15장. 모델 경량화: 양자화, 프루닝, 지식증류
실습 4 — 프루닝: 가지를 쳐도 맞히나
2장의 손글씨 숫자(load_digits, scikit-learn 에 들어 있는 실제 공개 자료)로 작은 신경망을 학습한 뒤, 크기가 작은 가중치를 0 으로 만드는 비정형 프루닝을 0% 에서 95% 까지 해 보고, 지운 뒤 다시 학습하면 회복되는지, 뉴런을 통째로 지우는 정형 프루닝은 어떤지 봅니다. CPU 에서 씨앗을 고정해 돌립니다.
1단계. 신경망 학습하기
import copy, time
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.nn.utils.prune as prune
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X / 16.0, y, test_size=0.3, random_state=42, stratify=y)
Xtr, Xte = torch.tensor(Xtr, dtype=torch.float32), torch.tensor(Xte, dtype=torch.float32)
ytr, yte = torch.tensor(ytr), torch.tensor(yte)


def mlp(h):
    return nn.Sequential(nn.Linear(64, h), nn.ReLU(), nn.Linear(h, h), nn.ReLU(), nn.Linear(h, 10))


def fit(model, X, y, epochs=60, seed=0):
    """작은 묶음(32개)으로 Adam 학습. 씨앗을 고정해 다시 돌려도 같다"""
    torch.manual_seed(seed)
    opt = torch.optim.Adam(model.parameters(), lr=1e-3)
    g = torch.Generator().manual_seed(seed)
    for _ in range(epochs):
        idx = torch.randperm(len(X), generator=g)
        for i in range(0, len(X), 32):
            b = idx[i:i + 32]
            loss = F.cross_entropy(model(X[b]), y[b])
            opt.zero_grad()
            loss.backward()
            opt.step()
    return model


accuracy = lambda m: round((m(Xte).argmax(1) == yte).float().mean().item(), 3)
torch.manual_seed(0)
dense = fit(mlp(256), Xtr, ytr)
print("파라미터:", sum(p.numel() for p in dense.parameters()), "· 시험 정확도:", accuracy(dense))파라미터: 85002 · 시험 정확도: 0.9742단계. 비정형 프루닝으로 지워 보기
def pruned_copy(model, amount):
    """모든 층의 가중치를 한데 모아, 절댓값이 작은 쪽부터 amount 만큼 0 으로 만든 복사본"""
    m = copy.deepcopy(model)
    params = [(m[0], "weight"), (m[2], "weight"), (m[4], "weight")]
    if amount > 0:
        prune.global_unstructured(params, pruning_method=prune.L1Unstructured, amount=amount)
    return m


amounts = [0, 0.3, 0.5, 0.7, 0.8, 0.9, 0.95]
curve = [accuracy(pruned_copy(dense, a)) for a in amounts]
print(dict(zip(amounts, curve)))
plt.plot([a * 100 for a in amounts], curve, "o-")
plt.xlabel("지운 가중치의 몫(%)")
plt.ylabel("시험 정확도")
plt.title("비정형 프루닝: 지울수록 정확도는?")
plt.grid(alpha=0.3)
plt.show(){0: 0.974, 0.3: 0.974, 0.5: 0.976, 0.7: 0.969, 0.8: 0.952, 0.9: 0.856, 0.95: 0.613}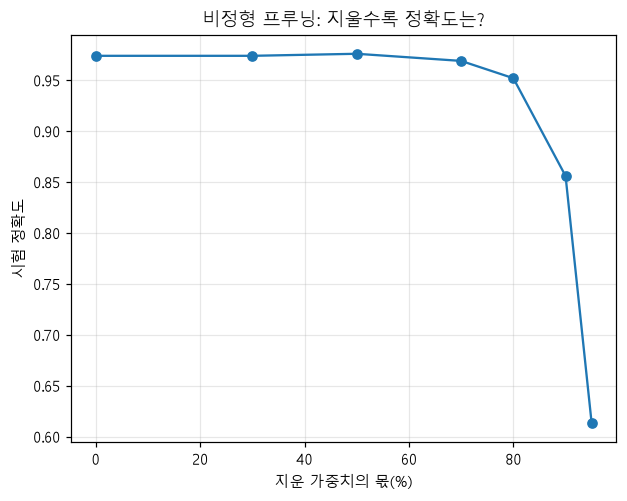
3단계. 90% 지운 뒤 다시 학습하기
m90 = pruned_copy(dense, 0.9)
before = accuracy(m90)
fit(m90, Xtr, ytr, epochs=20, seed=1)              # 지운 자리는 마스크로 0 에 묶인 채 남은 가중치만 다시 학습
zeros = sum((layer.weight == 0).sum().item() for layer in (m90[0], m90[2], m90[4]))
total = sum(layer.weight.numel() for layer in (m90[0], m90[2], m90[4]))
print("다시 학습 전", before, "→ 뒤", accuracy(m90), f"· 0 인 가중치 {zeros / total:.1%}")다시 학습 전 0.856 → 뒤 0.985 · 0 인 가중치 90.0%4단계. 뉴런을 통째로 지우기(정형 프루닝)
def structured(model, keep):
    """숨은층마다 가중치 크기(L1)가 큰 뉴런 keep 개만 남긴 더 작은 신경망을 만든다"""
    W0, W2, W4 = model[0].weight.data, model[2].weight.data, model[4].weight.data
    k1 = W0.abs().sum(1).topk(keep).indices                      # 첫 숨은층에서 남길 뉴런
    k2 = W2[:, k1].abs().sum(1).topk(keep).indices               # 둘째 숨은층에서 남길 뉴런
    small = mlp(keep)
    small[0].weight.data, small[0].bias.data = W0[k1].clone(), model[0].bias.data[k1].clone()
    small[2].weight.data, small[2].bias.data = W2[k2][:, k1].clone(), model[2].bias.data[k2].clone()
    small[4].weight.data, small[4].bias.data = W4[:, k2].clone(), model[4].bias.data.clone()
    return small


def speed_ms(m):
    big_batch = Xte.repeat(50, 1)                                # 540 × 50 = 27,000개
    with torch.no_grad():
        t = time.perf_counter()
        for _ in range(5):
            m(big_batch)
    return round((time.perf_counter() - t) / 5 * 1000, 1)


rows = []
for keep in (256, 128, 64, 32):
    s = structured(dense, keep)
    a0 = accuracy(s)
    fit(s, Xtr, ytr, epochs=20, seed=1)
    rows.append({"남긴 뉴런": keep, "파라미터": sum(p.numel() for p in s.parameters()),
                 "지운 직후": a0, "다시 학습 뒤": accuracy(s), "27,000개 추론 ms": speed_ms(s)})
import pandas as pd
print(pd.DataFrame(rows).to_string(index=False)) 남긴 뉴런 파라미터 지운 직후 다시 학습 뒤 27,000개 추론 ms
256 85002 0.974 0.974 34.0
128 26122 0.954 0.980 14.5
64 8970 0.770 0.981 6.4
32 3466 0.343 0.976 3.6이 실습이 뜻하는 것
이 실습은 정원의 나무 가지치기와 같습니다. 나무를 먼저 키우고(1단계), 가는 가지부터 점점 많이 잘라 열매가 얼마나 남는지 봅니다(2단계). 90% 를 자른 나무를 한 철 더 키워 보고(3단계), 가는 가지 대신 굵은 줄기째 잘라 나무 자체를 작게 만듭니다(4단계). 여기서 가는 가지가 가중치 하나, 굵은 줄기가 뉴런, 열매가 시험 정확도입니다. 비유와 다른 점은, 가는 가지를 자른 나무(비정형 프루닝)는 자른 자리를 0 으로 남겨 두어 크기가 그대로라는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 학습 | 파라미터: 85002 · 시험 정확도: 0.974 | 손글씨 숫자 시험 그림 100장 가운데 97장쯤을 맞히는 신경망입니다 |
| 2. 30%, 50% 지우기 | 0.974, 0.976 | 가중치 절반을 0 으로 만들어도 정확도가 그대로입니다 |
| 2. 70%, 80% 지우기 | 0.969, 0.952 | 조금씩 떨어지기 시작합니다 |
| 2. 90%, 95% 지우기 | 0.856, 0.613 | 여기서부터 크게 떨어집니다 |
| 2. 그래프 | 지운 몫과 정확도의 선 | 80% 까지는 거의 평평하다가 그 뒤로 꺾입니다 |
| 3. 다시 학습 | 0.856 → 뒤 0.985 · 0 인 가중치 90.0% | 90% 를 0 으로 묶은 채 남은 10% 만 다시 학습했더니, 지우기 전(0.974)보다도 높아졌습니다 |
| 4. 뉴런 128개 | 26122개 · 0.954 → 0.980 · 14.5ms | 뉴런을 절반 남기자 숫자가 3분의 1 아래로 줄었고, 다시 학습하면 정확도가 돌아옵니다 |
| 4. 뉴런 32개 | 3466개 · 0.343 → 0.976 · 3.6ms | 숫자가 약 25분의 1 이 되었고, 지운 직후 무너졌다가 다시 학습하면 돌아옵니다. 27,000개 추론이 34.0ms 에서 3.6ms(ms 는 1,000분의 1초)로 9배쯤 빨라졌습니다 |
한 줄로 줄이면, 작은 신경망은 가중치 대부분을 지워도 다시 학습하면 회복되고, 크기와 속도를 실제로 줄이려면 뉴런째 지워야 한다는 것을 보인 실습입니다. 손글씨 숫자처럼 쉬운 문제를 푸는 작은 신경망의 결과이고, 시간은 이 PC 의 CPU(Central Processing Unit, 중앙 처리 장치)에서 잰 것입니다. LLM 도 이렇게 잘 버티는지는 실습 6에서 봅니다.
코드 설명
- 1단계의 신경망은 숨은층 둘(뉴런 256개씩), 파라미터 85,002개이고 시험 정확도는 0.974 입니다.
torch.manual_seed와torch.Generator().manual_seed로 가중치의 처음 값과 섞는 순서를 고정했습니다. prune.global_unstructured는 세 층의 가중치를 한데 모아 절댓값이 작은 쪽부터 정한 몫을 0 으로 만듭니다. 50% 를 지워도 0.976 으로 그대로였고, 80% 에서 0.952, 90% 에서 0.856, 95% 에서 0.613 으로 떨어졌습니다. 그래프에서 80% 까지는 거의 평평하다가 그 뒤로 꺾입니다.- 90% 를 지워 0.856 이 된 모델을 20에포크 다시 학습하자 0.985 로, 지우기 전(0.974)보다도 높아졌습니다.
prune은 지운 자리에 마스크를 씌워 두므로 다시 학습해도 0 은 0 으로 남습니다(0 인 가중치 90.0%). 다만 이 모델은 메모리에 여전히 85,002개의 숫자를 들고 있습니다. - 정형 프루닝은 뉴런을 실제로 빼서 더 작은 신경망을 만듭니다. 뉴런을 32개만 남기면 파라미터가 3,466개(25분의 1)가 되고, 지운 직후 0.343 으로 무너졌다가 다시 학습하면 0.976 으로 돌아옵니다. 27,000개를 추론하는 시간도 34.0ms 에서 3.6ms 로 줄었습니다. 비정형과 달리 크기와 속도가 실제로 줄지만, 다시 학습이 꼭 필요합니다.