17장. Project 02. LLM 추론 API 서빙
프로젝트 3 — 두 서비스를 한 묶음으로 배포하기
요약 API 와 분류 API 를 Ollama 와 함께 한 묶음으로 배포할 준비를 하고, 다른 팀이 부르는 것처럼 부하 시험을 해 보세요. 이 PC 에는 Docker 가 없으므로 compose 는 파일로 만들어 서로 맞는지 코드로 검사하고, 서비스는 배포 폴더에서 하위 프로세스로 띄워 확인합니다(14장와 같은 방식). 프로젝트 1과 2를 먼저 실행해야 합니다.
| 만들 것 | 내용 |
|---|---|
out_llm_serving/summary/ | app.py(프로젝트 1의 API), requirements.txt, Dockerfile |
out_llm_serving/inquiry/ | app.py(프로젝트 2의 API), out_inquiry_clf.joblib, requirements.txt, Dockerfile |
out_llm_serving/compose.yaml | ollama, ollama-pull, summary, inquiry 의 네 서비스 |
요구사항은 다섯 가지입니다.
- 두 서비스의 폴더에 코드, 판을 고정한 패키지 목록, Dockerfile 을 둡니다. 분류 API 의 이미지는 임베딩 모델을 만들 때 미리 받아 둡니다.
- compose 에 Ollama(GPU, 모델 볼륨, 상태 검사), 모델을 한 번 받는 서비스, 두 API 를 적고 뜨는 차례를 정합니다.
- 앱이 읽는 환경 변수, 포트, 패키지 목록이 compose 와 Dockerfile 에 맞는지 코드로 검사합니다.
- 두 서비스를 이 PC 에서 띄워, 다른 팀이 부르는 것처럼 표준 라이브러리로만 부릅니다.
- 분류 API 에 동시 요청 1, 4, 8 개로 부하 시험을 하고, 요약 API 는 503 을 받으면 기다렸다 다시 보내는 부르는 쪽 코드로 시험합니다.
단계별 힌트입니다.
- 패키지 판은
importlib.metadata.version()으로 지금 PC 의 것을 적습니다. - 앱이 읽는 환경 변수는 정규식
os.environ.get\("(\w+)"로 찾습니다. - import 한 패키지 이름과 설치 이름이 다른 것(
sklearn은scikit-learn)에 주의합니다. - 부하 시험은
ThreadPoolExecutor(max_workers=동시 수)로 같은 문의 40개를 보내고, 전체 시간으로 초당 처리 수를 냅니다. - 끝나면 띄운 서버를 반드시 끕니다.
확인할 것: 다 풀었으면 항목마다 스스로 확인해 체크해 보세요.
실제 데이터로 해 보려면
이 프로젝트의 "실제"는 데이터보다 실제 서버입니다. 사내 GPU 서버에 올릴 때 확인할 것입니다.
| 확인할 것 | 어디서 | 내용 |
|---|---|---|
| GPU 를 컨테이너에 주기 | NVIDIA Container Toolkit 공식 문서 | 서버에 드라이버와 툴킷을 설치하고 docker run --gpus all 로 확인한다 |
| Ollama 이미지 | Docker Hub 의 ollama/ollama | 판을 고정하고, 모델 볼륨 위치를 확인한다 |
| 폐쇄망에서 모델 옮기기 | 11장 | 인터넷이 되는 PC 에서 모델을 받아 볼륨째 옮긴다 |
| 실제 사용량 | 13장의 요청 기록 | 하루 요청 수와 몰리는 시각을 보고 동시 처리 수와 시간 제한을 정한다 |
코드의 흐름
예시 풀이의 코드가 어떤 차례로 흘러가는지 한 장으로 그렸습니다. 풀기 전에 큰 줄기를 먼저 보고, 풀다가 막히면 지금 어느 상자에 있는지 확인해 보세요.
주황 화살표가 실행 차례이고, 상자의 번호는 예시 풀이의 단계 번호와 같습니다. 1단계(청록)는 out_llm_serving 아래에 서비스마다 app.py, requirements.txt, Dockerfile 을 담은 서비스 폴더를 만들고, 2단계(마젠타)는 ollama, ollama-pull, summary, inquiry 의 네 서비스를 compose.yaml 에 적습니다. 3단계(다홍)는 환경 변수, 포트, 패키지 목록이 compose 와 Dockerfile 에 맞는지 검사합니다. 4단계(빨강)는 배포 폴더에서 두 서비스를 uvicorn 으로 띄워 /health 로 확인하고, 5단계(짙은 청록)는 ThreadPoolExecutor 의 max_workers 를 바꿔 가며 부하 시험을 해 초당 처리 수를 냅니다.
결과 보기 (예시 풀이)
1단계. 서비스마다 폴더 만들기
import importlib.metadata as md
import shutil, sys
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

plt.rcParams["font.family"] = "Malgun Gothic"        # 한글 글꼴(5단계의 그래프)
plt.rcParams["axes.unicode_minus"] = False
test = pd.read_csv("inquiries.csv")                  # 5단계의 부하 시험에 쓸 문의 40개
summary_bodies = pd.read_json("summary_docs.jsonl", lines=True)["본문"].tolist()

DEPLOY = Path("out_llm_serving")
for name, src, extra in [("summary", "out_summary_api.py", []), ("inquiry", "out_inquiry_api.py", ["out_inquiry_clf.joblib"])]:
    folder = DEPLOY / name
    folder.mkdir(parents=True, exist_ok=True)
    shutil.copy(src, folder / "app.py")                # 프로젝트 1, 2 의 API 를 app.py 로
    for f in extra:
        shutil.copy(f, folder / f)

# 판을 고정한 패키지 목록. 지금 이 PC 에 깔린 판을 적는다
PACKAGES = {"summary": ["fastapi", "uvicorn", "pydantic"],
            "inquiry": ["fastapi", "uvicorn", "pydantic", "joblib", "scikit-learn", "sentence-transformers"]}
for name, pkgs in PACKAGES.items():
    (DEPLOY / name / "requirements.txt").write_text("".join(f"{p}=={md.version(p)}\n" for p in pkgs), encoding="utf-8")

(DEPLOY / "summary" / "Dockerfile").write_text("""FROM python:3.14-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app.py .
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
""", encoding="utf-8")
(DEPLOY / "inquiry" / "Dockerfile").write_text(f"""FROM python:3.14-slim
WORKDIR /app
# 임베딩은 CPU 에서 돌리므로 CPU 판 PyTorch 를 깐다(GPU 판보다 훨씬 작다)
RUN pip install --no-cache-dir torch=={md.version("torch").split("+")[0]} --index-url https://download.pytorch.org/whl/cpu
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
# 임베딩 모델을 이미지를 만들 때 받아 둔다. 컨테이너가 뜰 때 인터넷이 없어도 된다
RUN python -c "from sentence_transformers import SentenceTransformer; SentenceTransformer('intfloat/multilingual-e5-small')"
COPY app.py out_inquiry_clf.joblib ./
EXPOSE 8000
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
""", encoding="utf-8")
for p in sorted(DEPLOY.rglob("*")):
    if p.is_file():
        print(p.as_posix(), f"{p.stat().st_size:,}바이트")
print((DEPLOY / "inquiry" / "requirements.txt").read_text(encoding="utf-8"))out_llm_serving/compose.yaml 1,494바이트
out_llm_serving/inquiry/app.py 4,809바이트
out_llm_serving/inquiry/Dockerfile 666바이트
out_llm_serving/inquiry/out_inquiry_clf.joblib 8,814바이트
out_llm_serving/inquiry/requirements.txt 119바이트
out_llm_serving/summary/app.py 5,201바이트
out_llm_serving/summary/Dockerfile 209바이트
out_llm_serving/summary/requirements.txt 53바이트
fastapi==0.162.0
uvicorn==0.54.0
pydantic==2.14.1
joblib==1.6.0
scikit-learn==1.9.1
sentence-transformers==6.2.02단계. compose.yaml 쓰기
import yaml

compose_text = """services:
  ollama:
    image: ollama/ollama:0.40.12
    volumes:
      - ollama-models:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
    healthcheck:
      test: ["CMD", "ollama", "list"]
      interval: 10s
      retries: 30
  ollama-pull:
    image: ollama/ollama:0.40.12
    environment:
      OLLAMA_HOST: ollama:11434
    entrypoint: ["ollama", "pull", "qwen2.5:3b"]
    depends_on:
      ollama:
        condition: service_healthy
  summary:
    build: ./summary
    ports: ["8171:8000"]
    environment:
      OLLAMA_URL: http://ollama:11434
      SUMMARY_MODEL: qwen2.5:3b
      SUMMARY_MAX_BUSY: "2"
      SUMMARY_TIMEOUT: "60"
    depends_on:
      ollama-pull:
        condition: service_completed_successfully
    healthcheck:
      test: ["CMD", "python", "-c", "import urllib.request; urllib.request.urlopen('http://127.0.0.1:8000/health')"]
      interval: 15s
  inquiry:
    build: ./inquiry
    ports: ["8172:8000"]
    environment:
      OLLAMA_URL: http://ollama:11434
      INQUIRY_MODEL: qwen2.5:3b
      INQUIRY_THRESHOLD: "0.6"
    depends_on:
      ollama-pull:
        condition: service_completed_successfully
    healthcheck:
      test: ["CMD", "python", "-c", "import urllib.request; urllib.request.urlopen('http://127.0.0.1:8000/health')"]
      interval: 15s
volumes:
  ollama-models:
"""
(DEPLOY / "compose.yaml").write_text(compose_text, encoding="utf-8")
compose = yaml.safe_load(compose_text)
for name, svc in compose["services"].items():
print(f"{name:12s} 포트 {svc.get('ports', '-')} · 기다림 {list(svc.get('depends_on', {}))} · GPU {'deploy' in svc}")ollama 포트 - · 기다림 [] · GPU True
ollama-pull 포트 - · 기다림 ['ollama'] · GPU False
summary 포트 ['8171:8000'] · 기다림 ['ollama-pull'] · GPU False
inquiry 포트 ['8172:8000'] · 기다림 ['ollama-pull'] · GPU False3단계. 파일끼리 맞는지 검사하기
import ast, re
from urllib.parse import urlsplit

IMPORT_NAME = {"sklearn": "scikit-learn", "sentence_transformers": "sentence-transformers"}   # import 이름과 설치 이름이 다른 것
problems = []
services = compose["services"]
for name in ["summary", "inquiry"]:
    folder, svc = DEPLOY / name, services[name]
    code = (folder / "app.py").read_text(encoding="utf-8")
    # 1) 앱이 읽는 환경 변수 가운데 compose 가 주는 것과 기본값을 쓰는 것
    used = re.findall(r'os\.environ\.get\("(\w+)"', code)
    given = svc.get("environment", {})
    print(f"{name}: compose 가 주는 값 {[v for v in used if v in given]} · 기본값을 쓰는 값 {[v for v in used if v not in given]}")
    problems += [f"{name}: 앱이 읽지 않는 {k}" for k in given if k not in used]
    # 2) 주소의 호스트가 compose 의 서비스 이름인가
    problems += [f"{name}.{k}: {urlsplit(v).hostname} 서비스가 없다" for k, v in given.items()
                 if str(v).startswith("http") and urlsplit(v).hostname not in services]
    # 3) Dockerfile 의 포트와 compose 의 컨테이너 쪽 포트
    if '"--port", "8000"' not in (folder / "Dockerfile").read_text(encoding="utf-8") or not svc["ports"][0].endswith(":8000"):
        problems.append(f"{name}: 포트가 맞지 않는다")
    # 4) import 한 바깥 패키지가 requirements.txt 에 있나
    tree = ast.parse(code)
    mods = {a.name.split(".")[0] for n in ast.walk(tree) if isinstance(n, ast.Import) for a in n.names}
    mods |= {n.module.split(".")[0] for n in ast.walk(tree) if isinstance(n, ast.ImportFrom) and n.module}
    third = {IMPORT_NAME.get(m, m) for m in mods if m not in sys.stdlib_module_names}
    reqs = {line.split("==")[0] for line in (folder / "requirements.txt").read_text(encoding="utf-8").split()}
    problems += [f"{name}: requirements.txt 에 {p} 가 없다" for p in third - reqs]
gpu = [n for n, s in services.items() if "deploy" in s]
print("GPU 를 받는 서비스:", gpu, "· 모델 볼륨:", services["ollama"]["volumes"])
print("문제:", problems or "없음")summary: compose 가 주는 값 ['OLLAMA_URL', 'SUMMARY_MODEL', 'SUMMARY_MAX_BUSY', 'SUMMARY_TIMEOUT'] · 기본값을 쓰는 값 []
inquiry: compose 가 주는 값 ['OLLAMA_URL', 'INQUIRY_MODEL', 'INQUIRY_THRESHOLD'] · 기본값을 쓰는 값 ['INQUIRY_CLF']
GPU 를 받는 서비스: ['ollama'] · 모델 볼륨: ['ollama-models:/root/.ollama']
문제: 없음4단계. 이 PC 에서 두 서비스 띄우기
compose 로 띄우는 명령은 아래와 같습니다. 이 PC 에서 실행하지 않은 안내 코드입니다.
cd out_llm_serving
docker compose up -d --build
docker compose ps
curl http://127.0.0.1:8172/health
예상 출력(실행하지 않고 유추한 예시)입니다. 처음에는 이미지를 만들고 모델(약 2GB)을 받느라 몇 분 걸리고, 두 API 는 모델 받기가 끝난 뒤에 뜹니다.
[+] Running 6/6
 ✔ Volume "out_llm_serving_ollama-models"    Created
 ✔ Container out_llm_serving-ollama-1        Healthy
 ✔ Container out_llm_serving-ollama-pull-1   Exited
 ✔ Container out_llm_serving-summary-1       Started
 ✔ Container out_llm_serving-inquiry-1       Started
NAME                          SERVICE    STATUS                    PORTS
out_llm_serving-inquiry-1     inquiry    Up 1 minute (healthy)     0.0.0.0:8172->8000/tcp
out_llm_serving-ollama-1      ollama     Up 3 minutes (healthy)    11434/tcp
out_llm_serving-summary-1     summary    Up 1 minute (healthy)     0.0.0.0:8171->8000/tcp
{"준비":true,"판":"inquiry-lr-1","기준값":0.6,"모델":"qwen2.5:3b","데우기실패":false,"LLM호출":0,"LLM실패":0}
이 PC 에서는 compose 가 하는 일을 흉내 냅니다. 두 서비스를 각자의 배포 폴더에서 띄우고, 서비스 이름 ollama 대신 이 PC 의 Ollama 주소를 줍니다.
import json, os, subprocess, time, urllib.error, urllib.request

servers = {}
for name, port in [("summary", 8171), ("inquiry", 8172)]:
    env = {k: str(v) for k, v in services[name]["environment"].items()}
    env["OLLAMA_URL"] = "http://127.0.0.1:11434"                   # compose 라면 http://ollama:11434
    servers[name] = subprocess.Popen([sys.executable, "-m", "uvicorn", "app:app", "--port", str(port), "--log-level", "warning"],
                                     cwd=DEPLOY / name, env=dict(os.environ, **env))
for name, port in [("summary", 8171), ("inquiry", 8172)]:
    for _ in range(240):                                          # 데우기까지 끝나야 /health 가 답한다
        if servers[name].poll() is not None:                      # 켜다가 멈췄으면 더 기다리지 않는다
            print(name, "켜지 못함")
            break
        try:
            print(name, urllib.request.urlopen(f"http://127.0.0.1:{port}/health", timeout=2).read().decode())
            break
        except OSError:
            time.sleep(0.5)
print("문서 화면:", urllib.request.urlopen("http://127.0.0.1:8172/docs").status)summary {"준비":true,"데우기초":0.39,"데우기실패":false,"다시물음":0,"캐시적중":0,"모델":"qwen2.5:3b","판":"summary-1.0","동시처리":2,"시간제한":60.0}
inquiry {"준비":true,"판":"inquiry-lr-1","기준값":0.6,"모델":"qwen2.5:3b","데우기실패":false,"LLM호출":0,"LLM실패":0}
문서 화면: 2005단계. 다른 팀처럼 부르고 부하 시험하기
from concurrent.futures import ThreadPoolExecutor


def call(url, body, tries=4):
    """다른 팀이 쓸 부르는 쪽 코드. 503 이면 Retry-After 만큼 기다렸다 다시 보낸다. (상태, 본문, 보낸 횟수)"""
    data = json.dumps(body, ensure_ascii=False).encode()
    for i in range(tries):
        req = urllib.request.Request(url, data=data, headers={"Content-Type": "application/json"})
        start = time.perf_counter()
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                return r.status, json.loads(r.read()), i + 1, time.perf_counter() - start
        except urllib.error.HTTPError as e:
            if e.code != 503:
                return e.code, json.loads(e.read()), i + 1, time.perf_counter() - start
            time.sleep(float(e.headers.get("Retry-After", 5)))
    return 503, None, tries, None


questions = test["문의"].tolist()
load = []
for workers in [1, 4, 8]:
    t = time.perf_counter()
    with ThreadPoolExecutor(max_workers=workers) as pool:          # 다른 팀 여럿이 한꺼번에 부르는 흉내
        res = list(pool.map(lambda q: call("http://127.0.0.1:8172/classify", {"문의": q}), questions))
    total = time.perf_counter() - t
    lat = [r[3] for r in res]
    ok = np.mean([r[1]["분류"] == y for r, y in zip(res, test["분류"])])
    load.append({"동시": workers, "초당 처리": round(40 / total, 2), "p50": round(float(np.percentile(lat, 50)), 2),
                 "p95": round(float(np.percentile(lat, 95)), 2), "전체 초": round(total, 1), "정확도": round(float(ok), 3),
                 "LLM": sum(r[1]["판단"] == "LLM" for r in res)})
print(pd.DataFrame(load).to_string(index=False))

# 요약 API: 넷이 한꺼번에 보내도, 부르는 쪽이 Retry-After 를 지키면 모두 답을 받는다
with ThreadPoolExecutor(max_workers=4) as pool:
    res = list(pool.map(lambda d: call("http://127.0.0.1:8171/summarize", {"본문": d, "문장수": 1}), summary_bodies[:4]))
print("요약 넷: 상태", [r[0] for r in res], "· 보낸 횟수", [r[2] for r in res])

fig, ax = plt.subplots(1, 2, figsize=(10, 4))
d = pd.DataFrame(load)
ax[0].bar(d["동시"].astype(str), d["초당 처리"])
ax[0].set_title("분류 API 의 초당 처리 수")
ax[0].set_xlabel("동시 요청 수")
ax[1].plot(d["동시"], d["p50"], marker="o", label="p50")
ax[1].plot(d["동시"], d["p95"], marker="o", label="p95")
ax[1].set_title("요청 하나의 응답 시간(초)")
ax[1].set_xlabel("동시 요청 수")
ax[1].legend()
plt.tight_layout()
plt.show()

for name, proc in servers.items():                               # 띄운 서버를 끈다
    proc.terminate()
    proc.wait(timeout=10)
print("서버를 껐습니다:", list(servers)) 동시 초당 처리 p50 p95 전체 초 정확도 LLM
1 3.22 0.40 0.51 12.4 0.9 28
4 3.58 1.53 1.65 11.2 0.9 28
8 3.54 3.01 3.22 11.3 0.9 28
요약 넷: 상태 [200, 200, 200, 200] · 보낸 횟수 [1, 1, 3, 2]
서버를 껐습니다: ['summary', 'inquiry']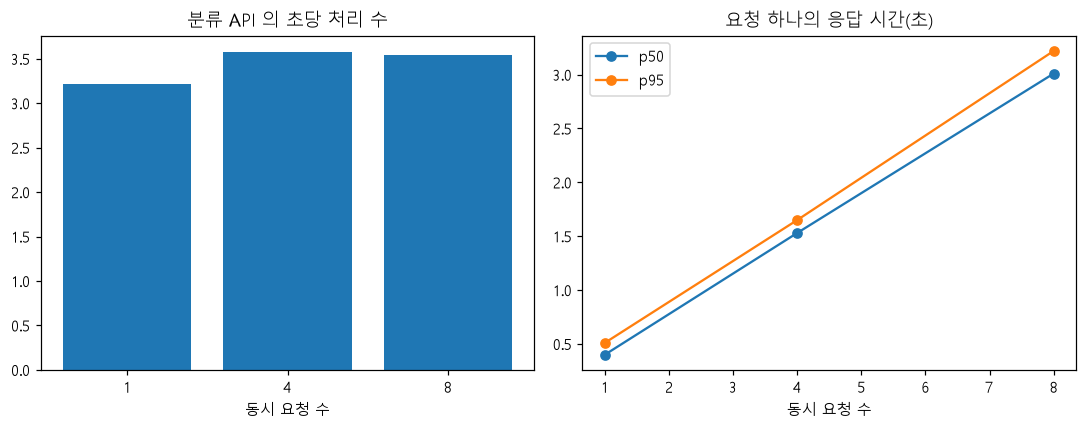
배포 폴더와 compose 의 검사에서는 문제가 나오지 않았습니다. 앱이 읽는 환경 변수 가운데 INQUIRY_CLF 만 기본값(폴더 안의 out_inquiry_clf.joblib)을 쓰고, GPU 는 ollama 서비스만 받습니다. 배포 폴더에서 띄운 두 서비스는 데우기를 마친 뒤 /health 에 "준비"라고 답했습니다. 분류 API 의 부하 시험에서 초당 처리 수는 동시 요청 1, 4, 8 에서 3.22, 3.58, 3.54 로 거의 그대로였습니다. 요청 하나의 p50 은 0.40초, 1.53초, 3.01초로 동시 수에 비례해 늘었습니다. 40개 가운데 28개가 LLM 을 거치는데, 이 PC 의 Ollama 는 요청을 하나씩 처리하기 때문입니다(16장). 병목은 API 가 아니라 LLM 이고, 동시 수를 늘리면 줄만 길어집니다. 처리량을 늘리려면 LLM 에 넘기는 수를 줄이거나(분류기를 더 학습), 여러 요청을 함께 처리하는 서빙 엔진(vLLM)을 써야 합니다. 요약 API 에는 넷을 한꺼번에 보냈습니다. 부르는 쪽이 Retry-After 를 지키자 넷 모두 200 을 받았고, 보낸 횟수는 1, 1, 3, 2 번이었습니다. 붐빌 때 503 으로 돌려보내도 부르는 쪽 코드가 기다렸다 다시 보내면 결국 모두 답을 받습니다. docker compose up 은 이 PC 에 Docker 가 없어 실행하지 않았고, 위의 예상 출력은 유추한 것입니다.
이 프로젝트가 뜻하는 것
이 프로젝트는 가게 두 곳(요약, 분류)과 두 가게가 함께 쓰는 공용 주방을 새 건물로 옮길 이사 준비를 하는 일과 같습니다. 가게마다 상자에 짐과 물품 목록, 설치 설명서를 넣습니다(1단계). 건물 배치도를 그려 공용 주방이 먼저 문을 열고, 재료를 받은 뒤에 가게가 문을 열도록 차례를 정합니다(2단계). 배치도와 상자 속 내용이 서로 맞는지 점검합니다(3단계). 지금 건물(이 PC)에서 두 가게를 임시로 열어 보고(4단계), 다른 팀 손님처럼 한꺼번에 몰려와 얼마나 버티는지 시험합니다(5단계). 여기서 상자가 서비스 폴더, 물품 목록이 requirements.txt, 설치 설명서가 Dockerfile, 건물 배치도가 compose.yaml, 공용 주방이 ollama 서비스, 재료 받기가 ollama-pull 서비스입니다. 비유와 다른 점은, 이 PC 에 Docker 가 없어 새 건물로 실제 이사(docker compose up)는 하지 않았다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 서비스 폴더 | summary/, inquiry/ 아래 app.py, Dockerfile, requirements.txt 등 | 두 서비스의 상자가 만들어졌습니다. 분류 서비스에는 학습한 분류기 파일(out_inquiry_clf.joblib)도 들어 있습니다. 목록의 compose.yaml 은 2단계에서 쓰는 파일이라, 앞서 실행해 둔 것이 남아 있는 것으로 보입니다 |
| 1. 패키지 목록 | fastapi==0.162.0 … sentence-transformers==6.2.0 | 이 PC 에 깔린 판을 그대로 적어, 새 건물에서도 같은 판이 깔리게 했습니다 |
| 2. compose | ollama 는 GPU True · ollama-pull 은 ollama 를 기다림 · summary 8171, inquiry 8172 는 ollama-pull 을 기다림 | GPU(Graphics Processing Unit, 그래픽 처리 장치)는 주방(ollama)만 받고, 두 가게는 모델 받기가 끝난 뒤에 뜨도록 차례가 정해졌습니다 |
| 3. 환경 변수 | summary 는 넷 모두 compose 가 줌 · inquiry 는 셋을 받고 INQUIRY_CLF 만 기본값 | 앱이 읽는 설정이 배치도에 빠짐없이 적혀 있습니다. INQUIRY_CLF 는 폴더 안의 분류기 파일을 기본값으로 씁니다 |
| 3. 점검 결과 | GPU 를 받는 서비스 ['ollama'] · 문제: 없음 | 환경 변수, 주소, 포트, 패키지 목록이 서로 어긋난 곳이 없습니다 |
| 4. compose 의 예상 출력 | 컨테이너 네 개가 뜨고 상태가 healthy | 실행하지 않고 유추한 예시입니다. 실제 결과가 아닙니다 |
| 4. 이 PC 에서 띄우기 | summary 와 inquiry 모두 "준비":true · 문서 화면: 200 | 배포 폴더에서 두 서비스를 띄우자 데우기를 마치고 준비되었다고 답했습니다 |
| 5. 초당 처리 | 동시 1, 4, 8 → 3.22, 3.58, 3.54 | 한꺼번에 부르는 수를 여덟 배로 늘려도 1초에 처리하는 문의 수는 거의 그대로입니다 |
| 5. 응답 시간 p50 | 0.40, 1.53, 3.01초 | 한꺼번에 많이 부를수록 문의 하나가 끝나는 가운데 값이 거의 비례해 늘었습니다. 줄을 서기 때문입니다 |
| 5. 정확도와 LLM | 정확도 0.9 · LLM 28 | 부하가 늘어도 답은 그대로이고, 40개 가운데 28개가 LLM 을 거쳤습니다 |
| 5. 요약 넷 | 상태 [200, 200, 200, 200] · 보낸 횟수 [1, 1, 3, 2] | 503 을 받은 둘도 부르는 쪽이 Retry-After 만큼 기다렸다 다시 보내 결국 모두 답을 받았습니다 |
| 5. 그래프 | 초당 처리 막대와 p50, p95 꺾은선 | 막대는 높이가 거의 같고, 두 선은 동시 요청 수를 따라 오릅니다 |
한 줄로 줄이면, 두 API 와 모델 서버를 한 묶음으로 내보낼 파일을 서로 맞게 짜 두었고, 부하를 걸어 보니 병목은 API 가 아니라 요청을 하나씩 처리하는 LLM 이라는 것을 확인한 프로젝트입니다. 16장 실습 2에서 본 "처리량은 그대로, 기다림만 늘어남"과 같은 모습입니다. 처리량을 늘리려면 LLM 에 넘기는 수를 줄이거나 vLLM 처럼 묶어서 처리하는 엔진을 써야 합니다. Docker 로 실제로 띄우지 않았으므로 compose 의 예상 출력은 유추한 것이고, 부하 시험의 숫자는 이 PC 의 Ollama 에서 잰 것이라 GPU 서버에서는 다르게 나옵니다.