20장. LLM 평가와 모니터링
실습 5 — 드리프트 감지하기
도서관 챗봇의 운영 기록 8주(chat_log.csv, 1,712줄, 지어낸 연습용 데이터)에서 질문이 바뀌는지 잽니다. 1~4주를 기준 기간으로 삼고, 주마다 주제 분포의 PSI, 검색 점수 분포의 KS 검정, 처음 보는 질문의 비율을 봅니다. 운영 기록에는 질문의 주제가 적혀 있지 않으므로, 질문마다 가장 가까운 문서를 주제로 씁니다.
1단계. 준비와 질문 임베딩
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from scipy.stats import ks_2samp
from sentence_transformers import SentenceTransformer

plt.rcParams["font.family"] = "Malgun Gothic"        # 한글 글꼴(4단계의 그래프)
plt.rcParams["axes.unicode_minus"] = False

log = pd.read_csv("chat_log.csv", parse_dates=["시각"])
log["주"] = (log["시각"] - pd.Timestamp("2026-09-07")).dt.days // 7 + 1     # 2026-09-07(월)부터 1주
emb = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")
chunks, docs = [], []
for f in sorted(Path("library/day4").glob("*.txt")):
    paras = [p.strip() for p in f.read_text(encoding="utf-8").split("\n\n") if p.strip()]
    chunks += [f"{f.stem}: {p}" for p in paras[1:]]
    docs += [f.stem] * (len(paras) - 1)
V = emb.encode(["passage: " + c for c in chunks], normalize_embeddings=True)
# 같은 질문이 여러 번 들어오므로 서로 다른 질문만 한 번씩 임베딩한다
uniq = log["질문"].unique()
Q = emb.encode(["query: " + q for q in uniq], normalize_embeddings=True)
S = Q @ V.T
log["검색점수"] = log["질문"].map(dict(zip(uniq, S.max(axis=1))))
log["주제"] = log["질문"].map(dict(zip(uniq, [docs[i] for i in S.argmax(axis=1)])))
# 결과: 줄 수, 서로 다른 질문 수, 주마다의 질문 수
print(len(log), "줄 · 서로 다른 질문", len(uniq), "개")
print(log.groupby("주").size().to_dict())1712 줄 · 서로 다른 질문 38 개
{1: 216, 2: 215, 3: 221, 4: 208, 5: 213, 6: 196, 7: 206, 8: 237}2단계. 주제 분포의 PSI
def psi(base, now, eps=1e-4):
    keys = sorted(set(base.index) | set(now.index))
    b = base.reindex(keys, fill_value=0).to_numpy() + eps
    n = now.reindex(keys, fill_value=0).to_numpy() + eps
    return float(((n - b) * np.log(n / b)).sum())


base = log[log["주"] <= 4]                     # 기준 기간: 1~4주
p0 = base["주제"].value_counts(normalize=True)
weekly = pd.DataFrame({"질문": log.groupby("주").size(),
                       "PSI": log.groupby("주")["주제"].apply(lambda s: psi(p0, s.value_counts(normalize=True)))})
# 결과: 주마다의 PSI(1~4주는 기준 기간 안이라 작다)
print(weekly.round(3).T)주 1 2 3 4 5 6 7 8
질문 216.000 215.000 221.00 208.000 213.000 196.000 206.000 237.000
PSI 0.028 0.012 0.03 0.058 0.046 0.099 0.069 0.2093단계. 검색 점수와 처음 보는 질문
# KS 검정: 그 주의 검색 점수 분포가 기준 기간과 같은지. p 값이 작으면 다르다
weekly["KS p"] = [ks_2samp(base["검색점수"], g["검색점수"]).pvalue for _, g in log.groupby("주")]
# 처음 보는 질문: 기준 기간의 서로 다른 질문 가운데 가장 가까운 것과의 유사도가 0.95 아래
base_q = Q[np.isin(uniq, base["질문"].unique())]
nearest = dict(zip(uniq, (Q @ base_q.T).max(axis=1)))
log["처음"] = log["질문"].map(nearest) < 0.95
weekly["처음 보는 비율"] = log.groupby("주")["처음"].mean()
weekly["모름"] = log.groupby("주")["모름"].mean()
weekly["싫어요"] = log.groupby("주")["피드백"].apply(lambda s: (s == "싫어요").mean())
pd.set_option("display.float_format", lambda v: f"{v:.3g}" if v < 0.001 else f"{v:.3f}")
print(weekly)
pd.reset_option("display.float_format")       # 표시 설정을 되돌린다
# 결과: 처음 보는 질문 가운데 자주 나온 것
print(log[log["처음"]]["질문"].value_counts().head(8)) 질문 PSI KS p 처음 보는 비율 모름 싫어요
주
1 216 0.028 0.995 0 0.056 0.056
2 215 0.012 0.841 0 0.042 0.056
3 221 0.030 0.711 0 0.059 0.018
4 208 0.058 0.988 0 0.038 0.024
5 213 0.046 0.921 0 0.038 0.042
6 196 0.099 0.573 0.122 0.148 0.056
7 206 0.069 0.002 0.218 0.194 0.136
8 237 0.209 2.58e-05 0.333 0.270 0.131
질문
지하철역 스마트 도서관은 어떻게 이용해요? 28
스마트 도서관에는 어떤 책이 있어요? 23
Can I borrow books with a foreign ID? 19
기말고사 기간에 열람실 연장 운영하나요? 19
역에 있는 무인 대출기에서 회원증이 안 읽혀요. 17
스마트 도서관에서 빌린 책은 어디에 반납해요? 15
시험 기간에는 열람실을 밤새 여나요? 15
What time does the library close? 12
Name: count, dtype: int641~5주는 처음 보는 질문이 없고 PSI 도 0.06 아래입니다. 6주째에 처음 보는 질문이 0.122, 모름이 0.148 로 먼저 올랐지만, PSI 는 0.099 로 문턱 0.1 바로 아래였습니다. 새 질문의 가장 가까운 문서가 기존 문서(전자책, 열람실, 회원증)로 흩어져 주제 비율이 크게 바뀌지 않았기 때문입니다. 검색 점수의 KS 검정은 7주째(p 0.002)부터 차이를 보였고, 8주째에는 PSI 도 0.209 로 문턱을 넘었습니다. 신호마다 알아채는 때가 다르므로 하나만 보지 않습니다. 처음 보는 질문의 목록을 보면 무엇이 바뀌었는지(지하철역 스마트 도서관, 시험 기간 열람실, 영어 질문) 바로 읽힙니다.
4단계. 그래프로 보기
fig, axes = plt.subplots(1, 3, figsize=(11, 3.2))
weekly["PSI"].plot(ax=axes[0], marker="o", title="주제 분포의 PSI")
axes[0].axhline(0.1, linestyle="--", color="gray")
weekly["처음 보는 비율"].plot(ax=axes[1], marker="o", title="처음 보는 질문의 비율")
weekly[["모름", "싫어요"]].plot(ax=axes[2], marker="o", title="모름과 싫어요 비율")
for ax in axes:
    ax.set_xlabel("주")
plt.tight_layout()
plt.show()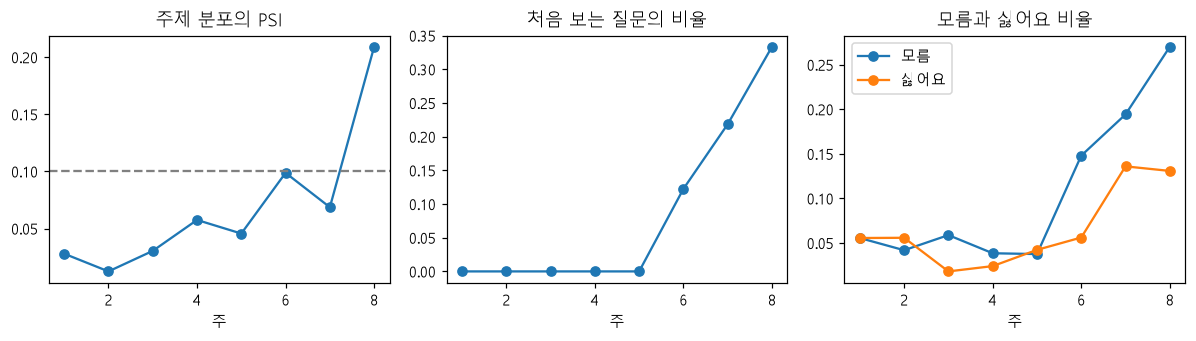
이 실습이 뜻하는 것
이 실습은 빵집 주인이 손님들이 찾는 빵이 달라지는지 주마다 살피는 일과 같습니다. 8주치 주문 장부를 펴고 주문마다 가장 가까운 빵 종류를 붙이고(1단계), 처음 4주의 빵 비율과 매주의 비율을 견주고(2단계), 손님 말이 메뉴판과 얼마나 잘 맞는지와 처음 듣는 주문의 비율을 본 뒤(3단계), 그래프로 그립니다(4단계). 여기서 주문 장부가 운영 기록 chat_log.csv, 빵 종류가 주제(가장 가까운 문서), 처음 4주가 기준 기간, 메뉴판과 맞는 정도가 검색 점수입니다. 비유와 다른 점은, 주제를 사람이 붙인 것이 아니라 가장 가까운 문서로 정했다는 것입니다. 그래서 새 주제의 질문도 기존 문서 가운데 하나로 들어가, 주제 비율이 덜 바뀌어 보일 수 있습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | 1712 줄 · 서로 다른 질문 38 개 | 8주 동안 질문이 1,712번 들어왔지만 서로 다른 질문은 38가지입니다. 주마다 196~237개가 들어왔습니다 |
| 2. PSI | 1~5주 0.012~0.058, 6주 0.099, 8주 0.209 | PSI(Population Stability Index, 모집단 안정성 지표)는 0에 가까울수록 주제 비율이 기준 기간과 같다는 뜻입니다. 8주째에 처음 문턱 0.1 을 넘었습니다 |
| 3. KS p | 1~6주 0.573 이상, 7주 0.002, 8주 2.58e-05 | KS(Kolmogorov-Smirnov, 두 수학자의 이름) 검정의 p 값이 아주 작으면 검색 점수의 분포가 기준 기간과 다르다는 뜻입니다. 8주째 값은 0.001 보다 작습니다 |
| 3. 처음 보는 비율 | 1~5주 0, 6주 0.122, 7주 0.218, 8주 0.333 | 8주째에는 질문 셋 가운데 하나가 기준 기간에 없던 질문입니다 |
| 3. 모름·싫어요 | 모름 1~5주 0.038~0.059, 8주 0.270 | 챗봇이 모른다고 답한 비율이 8주째에는 1~5주의 네 배가 넘습니다. 싫어요도 7주째 0.136 으로 올랐습니다 |
| 3. 처음 보는 질문 | 지하철역 스마트 도서관 28, 스마트 도서관의 책 23, 영어 질문 19와 12 | 무엇이 바뀌었는지 바로 읽힙니다. 스마트 도서관, 시험 기간 열람실, 영어 질문입니다 |
| 4. 그래프 | 선 그래프 세 칸 | 위 표의 PSI, 처음 보는 비율, 모름·싫어요를 주마다 선으로 이었습니다. PSI 칸에는 문턱 0.1 이 회색 점선으로 있습니다 |
한 줄로 줄이면, 질문이 바뀌는 드리프트는 신호마다 알아채는 때가 달라서 하나만 보면 늦게 안다는 것을 보인 실습입니다. 처음 보는 질문과 모름이 6주째에 먼저 올랐고, KS 검정은 7주째, PSI 는 8주째에 문턱을 넘었습니다. 다만 이 신호들은 "무언가 달라졌다"까지만 알려 줍니다. 챗봇이 새 질문에 실제로 어떻게 답하는지는 프로젝트에서 직접 물어 확인합니다. 운영 기록은 지어낸 연습용 데이터입니다.
코드 설명
- 운영 기록에는 같은 질문이 여러 번 나오므로
log["질문"].unique()로 서로 다른 질문만 임베딩하고,map으로 줄마다 붙입니다. S.argmax(axis=1)로 질문마다 가장 가까운 조각의 문서를 주제로 삼습니다. 주제 칸이 없는 기록에서 범주를 만드는 방법입니다.psi()는 기준 기간과 그 주의 주제 비율로 PSI 를 냅니다.reindex(..., fill_value=0)로 한쪽에만 있는 주제도 0 으로 채워 맞춥니다.ks_2samp(기준, 그 주)는 두 숫자 묶음의 분포가 같다는 가정의 p 값을 돌려줍니다.- 처음 보는 질문은 기준 기간 질문과의 가장 높은 유사도가 0.95 아래인 질문입니다. 글자는 달라도 뜻이 같은 질문은 처음 보는 질문으로 세지 않습니다.