3장. Attention 과 Transformer, GPT 직접 구현
임베딩
지도에서 가까운 동네끼리는 분위기도 비슷한 경우가 많습니다. 낱말에도 이런 지도를 만들 수 있다면, "배송"과 "택배"는 가까이, "배송"과 "청바지"는 멀리 놓일 것입니다. 토큰 번호를 이런 지도의 좌표로 바꾼 것이 임베딩입니다.
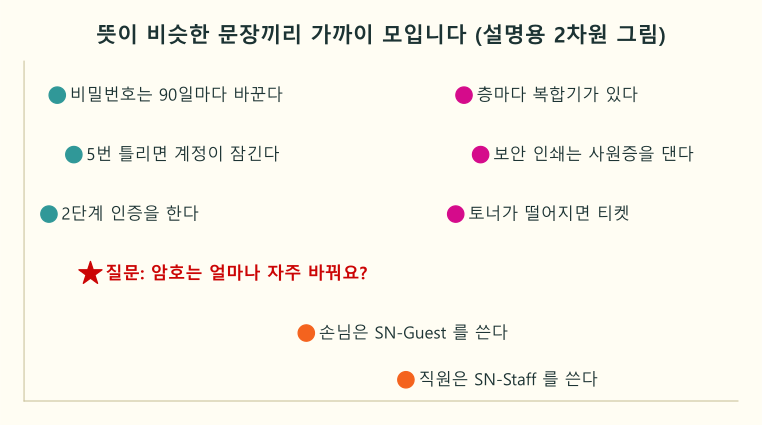
청록 점은 배송 무리, 마젠타 점은 환불 무리, 다홍 점은 옷 무리입니다. 뜻이 가까운 낱말끼리 모여 있습니다. 이 그림의 좌표는 설명을 위해 손으로 정한 것입니다. 실제 임베딩은 이런 자리를 학습으로 스스로 찾고, 좌표도 두 개가 아니라 수십에서 수천 개입니다. 여기서 동네가 낱말, 지도 좌표가 임베딩입니다.
번호에서 좌표로
| 단계 | 모양(예) | 뜻 |
|---|---|---|
| 토큰 번호 | 정수 하나, 예: 2 | "배"는 2번 |
| 임베딩 표 | (어휘 크기, 좌표 수), 예: (7, 4) | 어휘의 글자마다 좌표 한 줄 |
| 임베딩 | 좌표 4개, 예: [0.3, -1.2, 0.8, 0.1] | 표의 2번 줄을 꺼낸 것 |
임베딩 표는 2장의 가중치처럼 처음엔 난수이고, 학습하면서 쓸모 있는 좌표로 바뀌어 갑니다. PyTorch 에서는 nn.Embedding 이 이 표입니다.
코드로 표를 열어 보기
앞 절 "토큰과 토크나이저"에서 만든 일곱 글자 어휘를 그대로 씁니다. 표를 만들고, 표 안을 글자 이름을 붙여 찍어 본 뒤, "배송이" 세 글자의 좌표를 꺼냅니다.
import torch
from torch import nn

# 앞 절의 글자 토크나이저: 어휘 7글자에 번호를 붙인다
text = "배송이 늦어요"
chars = sorted(set(text))                      # [' ', '늦', '배', '송', '어', '요', '이']
stoi = {c: i for i, c in enumerate(chars)}     # 글자 → 번호

# 줄 7개(글자마다 한 줄), 칸 4개(좌표 4개)짜리 임베딩 표. 처음엔 난수다
torch.manual_seed(0)
emb = nn.Embedding(len(chars), 4)

# 1) 표를 줄마다 "번호, 글자, 좌표 4개"로 찍어 본다
for i, c in enumerate(chars):
    print(i, repr(c), [round(v, 2) for v in emb.weight[i].tolist()])

# 2) "배송이" 를 번호로 바꾸고, 번호마다 표의 한 줄을 꺼낸다
ids = torch.tensor([stoi[c] for c in "배송이"])
vecs = emb(ids)
print(ids)
print(vecs.detach().round(decimals=2))

# 3) 꺼낸 첫 줄이 표의 2번 줄("배")과 똑같은지 확인한다
print(torch.equal(vecs[0], emb.weight[2]))
print(emb.weight.shape, vecs.shape)0 ' ' [-1.13, -1.15, -0.25, -0.43]
1 '늦' [0.85, 0.69, -0.32, -2.12]
2 '배' [0.32, -1.26, 0.35, 0.31]
3 '송' [0.17, 0.87, -0.14, -0.11]
4 '어' [-0.61, 0.03, -0.49, 0.25]
5 '요' [0.62, -0.41, -0.84, -2.32]
6 '이' [-0.1, 0.79, -0.29, 0.05]
tensor([2, 3, 6])
tensor([[ 0.3200, -1.2600, 0.3500, 0.3100],
[ 0.1700, 0.8700, -0.1400, -0.1100],
[-0.1000, 0.7900, -0.2900, 0.0500]])
True
torch.Size([7, 4]) torch.Size([3, 4])결과를 차례로 읽기
| 출력 | 읽는 법 |
|---|---|
| 위의 일곱 줄 | 임베딩 표 자체다. 글자 하나에 줄 하나, 줄마다 좌표 4개가 있다. 예를 들어 "배"의 좌표는 0.32, -1.26, 0.35, 0.31 이다 |
tensor([2, 3, 6]) | "배송이"를 번호로 바꾼 것이다. 배는 2번, 송은 3번, 이는 6번 줄이다 |
| 3줄짜리 텐서 | emb(ids) 가 꺼낸 좌표다. 첫 줄은 표의 2번 줄("배"), 둘째 줄은 3번 줄("송"), 셋째 줄은 6번 줄("이")과 숫자가 똑같다 |
True | 꺼낸 첫 줄과 표의 2번 줄이 완전히 같다는 확인이다. 곧 emb(ids) 는 계산이 아니라 표에서 줄을 찾아 꺼내는 일이다 |
torch.Size([7, 4]), torch.Size([3, 4]) | 표는 7줄 4칸, 꺼낸 것은 글자 3개 × 좌표 4개다 |
한마디로, 임베딩은 "번호표를 보고 표에서 그 줄을 꺼내 오는 일"입니다. 도서관에서 청구번호 2번을 들고 가면 2번 칸의 책을 꺼내 주는 것과 같습니다. 여기서 청구번호가 토큰 번호, 서가의 칸이 표의 줄, 꺼낸 책이 좌표(벡터)입니다. 비유와 다른 점은, 이 표의 숫자는 학습하면서 계속 고쳐진다는 것입니다. 지금 숫자는 난수라서 "배"와 "송"이 가까운지 먼지에는 아직 아무 뜻이 없습니다. 학습을 거치면 함께 자주 쓰이는 글자의 좌표가 위 지도처럼 서로 가까워집니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
torch.manual_seed(0) | 난수의 씨앗을 고정한다. 임베딩 표의 처음 난수가 실행할 때마다 같아진다 |
nn.Embedding(len(chars), 4) | 줄 7개, 칸 4개짜리 표를 만든다. 첫 숫자가 어휘 크기(글자 수), 둘째 숫자가 좌표 수다 |
emb.weight | 임베딩 표 자체다. emb.weight[2] 는 표의 2번 줄이다. 2장에서 본 가중치처럼 requires_grad 가 켜져 있어 학습으로 바뀐다 |
.tolist(), round(v, 2) | 텐서 한 줄을 파이썬 목록으로 바꾸고 소수 둘째 자리까지 줄여 보기 좋게 찍는다 |
torch.tensor([stoi[c] for c in "배송이"]) | 글자를 번호로 바꾼 목록을 정수 텐서로 만든다. 임베딩 층에는 정수 텐서를 넣어야 한다 |
emb(ids) | 번호마다 표에서 그 번호의 줄을 꺼내 쌓는다. 곱셈 없는 표 찾기다 |
.detach() | 학습 기록을 떼어 낸 값만 꺼낸다. 찍기만 할 때 붙이면 출력에 학습 기록 표시가 섞이지 않는다 |
torch.equal(a, b) | 두 텐서의 모양과 숫자가 모두 같으면 True 를 돌려준다 |
번호의 크기에 뜻이 없어도 괜찮은 까닭이 여기에 있습니다. 번호는 몇 번째 줄인지 가리킬 뿐이고, 뜻은 그 줄에 담긴 좌표가 학습으로 갖게 됩니다.
주의할 점
- 2장에서 특성을 표준화해 넣었던 것과 달리, 토큰 번호는 그대로 신경망에 넣지 않습니다. 번호의 크기에 뜻이 없기 때문입니다. 반드시 임베딩을 거칩니다.
- 1장의
get_dummies(0/1 열로 펼치기)도 범주를 숫자로 바꾸는 방법이지만, 어휘가 수만 개면 열이 수만 개가 됩니다. 임베딩은 이것을 짧은 좌표로 줄입니다.