3장. Attention 과 Transformer, GPT 직접 구현
마스크: 앞만 보기
받아쓰기 시험을 볼 때 답안지의 뒷부분이 보이면 시험이 되지 않습니다. GPT 는 다음 글자를 맞히며 배우는데, 뒤의 글자를 볼 수 있다면 답을 보고 맞히는 셈입니다. 그래서 뒤의 글자를 가립니다. 이 가림표가 마스크입니다.
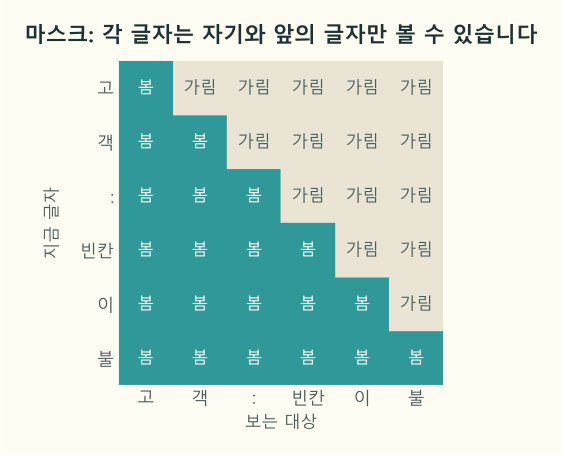
줄이 지금 글자, 칸이 보는 대상입니다. 청록 "봄" 칸은 볼 수 있는 자리, 회색 "가림" 칸은 가린 자리입니다. 첫 글자 "고"는 자기 자신만 보고, 마지막 "불"은 앞의 다섯 글자를 모두 봅니다. 왼쪽 아래 삼각형만 남기 때문에 인과적(앞에서 뒤로만 이어지는) 마스크라고 부릅니다. 여기서 답안지의 뒷부분이 가린 칸입니다.
가리는 법
가릴 칸의 점수를 아주 작은 수(음의 무한대)로 바꾸면, softmax 를 지난 뒤 그 칸의 비율이 0 이 됩니다.
| 단계 | 하는 일 |
|---|---|
| 1 | torch.tril(torch.ones(T, T)) 로 아래 삼각형이 1 인 표를 만든다 |
| 2 | 표가 0 인 칸의 점수를 -inf 로 바꾼다 |
| 3 | softmax 를 하면 그 칸은 0, 남은 칸끼리 합이 1 |
import torch

T = 4
scores = torch.zeros(T, T)                         # 점수가 모두 같다고 해 보자
mask = torch.tril(torch.ones(T, T))                # 아래 삼각형만 1
scores = scores.masked_fill(mask == 0, float("-inf"))   # 뒤쪽 칸은 -무한대로
print(torch.softmax(scores, dim=-1))
첫 줄은 [1, 0, 0, 0], 둘째 줄은 [0.5, 0.5, 0, 0], 넷째 줄은 [0.25, 0.25, 0.25, 0.25] 입니다. 점수가 모두 같으니 볼 수 있는 칸끼리 똑같이 나눠 가졌고, 뒤쪽 칸은 모두 0 입니다.
왜 1, 1/2, 1/3, 1/4 가 나오나
점수를 모두 0 으로 똑같이 두었기 때문에, 줄마다 볼 수 있는 칸끼리 1 을 똑같이 나눠 가진 것입니다. 네 걸음으로 따라가 봅니다.
1) 처음 점수는 모두 0 입니다. torch.zeros(4, 4) 로 16칸을 모두 0 으로 두었습니다. "어느 글자든 똑같이 중요하다"고 일부러 정한 것입니다.
2) 마스크를 씌우면 뒤쪽 칸만 -inf 가 됩니다. tril 은 대각선과 그 아래만 1 로 남기고, mask == 0 인 칸, 곧 대각선 위쪽이 -inf(음의 무한대)로 바뀝니다.
| 지금 글자 | 1번 칸 | 2번 칸 | 3번 칸 | 4번 칸 |
|---|---|---|---|---|
| 1번 줄 | 0 | -inf | -inf | -inf |
| 2번 줄 | 0 | 0 | -inf | -inf |
| 3번 줄 | 0 | 0 | 0 | -inf |
| 4번 줄 | 0 | 0 | 0 | 0 |
3) softmax 의 세 걸음을 거칩니다. "Attention 의 원리" 절에서 본 대로 exp 로 바꾸고, 줄마다 더하고, 합으로 나눕니다. exp(0) 은 1 이고, exp(-inf) 는 0 입니다. e 를 음의 무한대만큼 곱하면 한없이 0 에 가까워지기 때문입니다.
| 줄 | exp 를 지난 값 | 합 | 합으로 나눈 결과 |
|---|---|---|---|
| 1번 줄 | 1, 0, 0, 0 | 1 | 1, 0, 0, 0 |
| 2번 줄 | 1, 1, 0, 0 | 2 | 0.5, 0.5, 0, 0 |
| 3번 줄 | 1, 1, 1, 0 | 3 | 0.3333, 0.3333, 0.3333, 0 |
| 4번 줄 | 1, 1, 1, 1 | 4 | 0.25, 0.25, 0.25, 0.25 |
4) 뜻으로 읽습니다.
- 1번 글자는 자기 자신만 볼 수 있어서 자기를 100% 참고합니다.
- 2번 글자는 두 글자를 볼 수 있고, 점수가 같으니 반씩 나눕니다. 3번은 셋으로, 4번은 넷으로 똑같이 나눕니다.
- 가린 칸은 exp 에서 0 이 되므로 합에도 들어가지 않고, 비율도 정확히 0 입니다. 뒤 글자를 전혀 참고하지 않는다는 뜻입니다.
실제 모델에서는 점수가 칸마다 달라서 똑같이 나뉘지 않습니다. 이 예는 마스크가 하는 일만 보이려고 점수를 같게 둔 것입니다. 그래도 "가린 칸은 0, 남은 칸끼리 합이 1"이라는 점은 실제 모델에서도 같습니다.
dim=-1 은 왜 쓰나
dim 은 어느 방향으로 묶어 softmax 를 할지 정합니다. -1 은 파이썬 목록의 a[-1] 처럼 마지막 축을 뜻하고, (4, 4) 표에서는 dim=1 과 같습니다.
| dim 값 | 묶는 방향 | 합이 1 이 되는 곳 |
|---|---|---|
0 | 세로(한 칸 안의 네 줄) | 칸마다 |
1 또는 -1 | 가로(한 줄 안의 네 칸) | 줄마다 |
- 줄은 지금 글자이고, 한 글자가 볼 수 있는 글자들에게 참고 비율 100% 를 나눠 주어야 하므로 줄마다 합이 1 이어야 합니다.
dim=0으로 바꾸면 세로로 합이 1 이 됩니다. 1번 줄의 합이 0.25, 4번 줄의 합이 2 를 넘어 비율로 읽을 수 없는 표가 됩니다.1대신-1로 쓰는 까닭은, 실제 모델에서는 문장 여러 개와 멀티헤드 때문에 표가 (문장 수, 헤드 수, 4, 4) 처럼 커져 칸 방향 축의 번호가 바뀌기 때문입니다.-1은 모양이 바뀌어도 늘 마지막 축, 곧 칸 방향을 가리킵니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
torch.zeros(T, T) | 모든 칸이 0인 (4, 4) 표를 만든다. 점수가 모두 같은 경우를 흉내 낸다 |
torch.ones(T, T) | 모든 칸이 1인 (4, 4) 표를 만든다 |
torch.tril(...) | "lower triangle"의 줄임말이다. 대각선과 그 아래만 남기고 위쪽 칸을 0으로 만든다 |
mask == 0 | 칸마다 0인지 견줘 True, False 표를 만든다. True 인 칸이 가릴 칸이다 |
scores.masked_fill(조건, 값) | 조건이 True 인 칸만 값으로 바꾼 새 텐서를 돌려준다. 원래 scores 는 바뀌지 않아서 다시 담는다 |
float("-inf") | 음의 무한대다. softmax 를 지나면 이 칸의 비율은 정확히 0이 된다 |
masked_fill 은 마스크가 True 인 칸을 채웁니다. 그래서 "볼 칸이 1"인 tril 표를 그대로 넣지 않고, mask == 0 으로 뒤집어 "가릴 칸이 True"인 표를 넣습니다.
주의할 점
- 마스크는 학습 때 한꺼번에 계산하려고 필요합니다. 문장 하나로 "1글자 보고 2번째 맞히기", "2글자 보고 3번째 맞히기"를 동시에 연습할 수 있게 됩니다.
- 번역 모델의 인코더나 BERT 처럼 문장 전체를 읽는 모델은 이 마스크를 쓰지 않습니다.