3장. Attention 과 Transformer, GPT 직접 구현
셀프 어텐션 계산
고객 문의 "이불 배송 언제 와요"를 읽는다고 해 봅시다. "언제"를 읽을 때는 무엇이 언제인지 알려고 "배송"을 많이 참고하고, "배송"을 읽을 때는 무엇의 배송인지 알려고 "이불"을 참고하게 됩니다. 같은 문장 안의 낱말끼리 서로 참고하는 이 계산이 셀프 어텐션입니다.
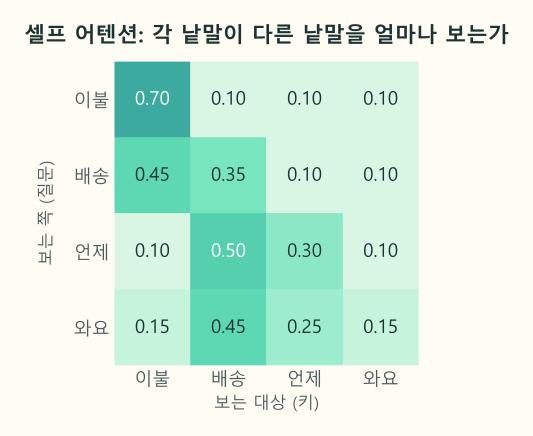
줄이 보는 쪽, 칸이 보는 대상입니다. "언제" 줄에서 "배송" 칸이 0.50 으로 가장 진하고, "배송" 줄에서는 "이불" 칸이 0.45 입니다. 한 줄의 숫자를 더하면 1 입니다. 칸의 숫자는 설명을 위해 정한 것이고, 실습 2에서 실제로 계산한 표를 봅니다.
계산 순서
| 단계 | 식 | 모양(낱말 4개, 좌표 8개일 때) |
|---|---|---|
| Q, K, V 만들기 | X × Wq, X × Wk, X × Wv | 각각 (4, 8) |
| 점수 | Q × K의 전치 | (4, 4): 낱말 쌍마다 하나 |
| 크기 줄이기 | 점수 ÷ √8 | (4, 4) |
| 비율 | 줄마다 softmax | (4, 4), 줄의 합이 1 |
| 결과 | 비율 × V | (4, 8): 낱말마다 새 벡터 |
점수를 좌표 수의 제곱근으로 나누는 까닭은, 좌표가 많을수록 곱한 값이 커져 softmax 가 한 칸에만 몰리기 때문입니다. 그래서 이 계산을 "크기를 줄인 내적 어텐션(scaled dot-product attention)"이라고 부릅니다.
숫자 몇 개로 따라가 보기
먼저 계산이 눈에 보이도록, 낱말마다 숫자 2개만 사람이 직접 정해 넣습니다. 첫째 숫자는 "물건"과 관련된 정도, 둘째 숫자는 "배송"과 관련된 정도입니다. 낱말마다 세 가지를 적습니다.
| 이름 | 영어 | 도서관 비유 | 뜻 |
|---|---|---|---|
| Q | Query(질문) | 질문 쪽지 | 나는 이런 낱말을 찾아요 |
| K | Key(열쇠) | 책의 제목표 | 나는 이런 낱말이에요 |
| V | Value(값) | 책의 내용 | 내가 넘겨줄 내용이에요 |
import torch
import pandas as pd

words = ["이불", "배송", "언제", "와요"]

# 낱말마다 숫자 2개로 적는다. 첫째 칸은 "물건", 둘째 칸은 "배송"과 관련된 정도
# K(제목표): "나는 이런 낱말이에요"
K = torch.tensor([[2.0, 0.0],    # 이불: 물건이다
                  [0.0, 2.0],    # 배송: 배송 그 자체다
                  [0.0, 0.0],    # 언제: 물건도 배송도 아니다
                  [0.0, 1.0]])   # 와요: 배송과 조금 관련 있다
# Q(질문 쪽지): "나는 이런 낱말을 찾아요"
Q = torch.tensor([[0.0, 1.0],    # 이불: 배송 쪽을 조금 찾는다
                  [2.0, 0.0],    # 배송: 무엇의 배송인지, 물건을 찾는다
                  [0.0, 2.0],    # 언제: 무엇이 언제인지, 배송을 찾는다
                  [0.0, 1.0]])   # 와요: 배송 쪽을 조금 찾는다
# V(내용): 설명을 쉽게 하려고 제목표와 같은 숫자로 둔다
V = K.clone()

# 1) 점수: 질문과 제목표를 칸끼리 곱해 더한다. "언제"와 "배송"은 0×0 + 2×2 = 4
scores = Q @ K.T
print("1) 점수표 (줄: 보는 낱말, 칸: 참고할 낱말)")
print(pd.DataFrame(scores.numpy(), index=words, columns=words))

# 2) 크기 줄이기: 좌표가 2개이므로 √2 로 나눈다
scaled = scores / 2 ** 0.5

# 3) 비율: 줄마다 softmax 로 합이 1 이 되게 바꾼다
weights = torch.softmax(scaled, dim=-1)
print("\n2) 비율표 (줄마다 합이 1)")
print(pd.DataFrame(weights.numpy(), index=words, columns=words).round(2))

# 4) 섞기: 비율대로 내용(V)을 더해 낱말마다 새 숫자 2개를 만든다
out = weights @ V
print("\n3) 섞은 결과 (물건, 배송)")
print(pd.DataFrame(out.numpy(), index=words, columns=["물건", "배송"]).round(2))1) 점수표 (줄: 보는 낱말, 칸: 참고할 낱말)
이불 배송 언제 와요
이불 0.0 2.0 0.0 1.0
배송 4.0 0.0 0.0 0.0
언제 0.0 4.0 0.0 2.0
와요 0.0 2.0 0.0 1.0
2) 비율표 (줄마다 합이 1)
이불 배송 언제 와요
이불 0.12 0.51 0.12 0.25
배송 0.85 0.05 0.05 0.05
언제 0.04 0.73 0.04 0.18
와요 0.12 0.51 0.12 0.25
3) 섞은 결과 (물건, 배송)
물건 배송
이불 0.25 1.26
배송 1.70 0.15
언제 0.09 1.65
와요 0.25 1.26"언제" 한 줄만 손으로 따라가기
표 전체를 한꺼번에 보면 어렵습니다. "언제" 한 줄만 손으로 계산해 봅니다. "언제"의 질문 쪽지는 (0, 2) 로 "배송을 찾아요"라는 뜻입니다.
| 걸음 | 이불 | 배송 | 언제 | 와요 |
|---|---|---|---|---|
| 상대의 제목표 K | (2, 0) | (0, 2) | (0, 0) | (0, 1) |
| 1) 점수 = 칸끼리 곱해 더하기 | 0×2 + 2×0 = 0 | 0×0 + 2×2 = 4 | 0 | 0×0 + 2×1 = 2 |
| 2) √2(약 1.41)로 나누기 | 0 | 2.83 | 0 | 1.41 |
| 3) softmax 로 비율 | 0.04 | 0.73 | 0.04 | 0.18 |
"언제"는 "배송"을 73%, "와요"를 18% 참고합니다. 찾는 것(배송)과 제목표가 맞는 낱말일수록 점수가 높고, 점수가 높을수록 비율이 큽니다.
4) 섞기는 이 비율대로 상대의 내용 V 를 더하는 일입니다. "언제"의 둘째 숫자(배송)는 0.04×0 + 0.73×2 + 0.04×0 + 0.18×1 = 1.64 쯤이고, 출력의 1.65 와 같습니다(반올림 차이). 원래 "언제"의 숫자는 (0, 0) 이었는데, 섞은 뒤에는 (0.09, 1.65) 가 되었습니다. 곧 "언제"가 "배송"의 내용을 받아 "배송이 언제인가"라는 뜻을 품게 된 것입니다.
결과를 차례로 읽기
| 출력 | 읽는 법 |
|---|---|
| 1) 점수표 | 줄이 보는 낱말, 칸이 참고할 낱말이다. "배송" 줄은 "이불" 칸만 4 로, 무엇의 배송인지 알려고 이불을 찾는다 |
| 2) 비율표 | 점수를 줄마다 합이 1 인 비율로 바꾼 것이다. "배송"은 "이불"을 0.85, "언제"는 "배송"을 0.73 참고한다 |
| 3) 섞은 결과 | 낱말마다 다른 낱말의 내용을 비율대로 받은 새 숫자다. "배송"은 물건 숫자가 0 에서 1.70 으로 커져 "이불의 배송"이 되었다 |
"이불"과 "와요"는 질문 쪽지가 (0, 1) 로 같아서 비율도 결과도 똑같습니다. 질문이 같으면 참고하는 곳도 같습니다.
코드에 나오는 것
| 코드 | 쉬운 뜻 |
|---|---|
torch.tensor([[2.0, 0.0], ...]) | 사람이 정한 숫자로 표(텐서)를 만든다. 4줄 2칸이다 |
K.clone() | K 를 똑같이 복사한다. V 를 바꿔도 K 가 함께 바뀌지 않게 한다 |
Q @ K.T | .T 로 K 의 줄과 칸을 바꾼 뒤 @(행렬 곱)로 곱한다. 모든 낱말 쌍의 "칸끼리 곱해 더하기"를 한 번에 해서 4×4 점수표를 만든다 |
scores / 2 ** 0.5 | 점수를 √2 로 나눈다. 2 ** 0.5 가 √2 다 |
torch.softmax(scaled, dim=-1) | 줄마다 점수를 합이 1 인 비율로 바꾼다 |
weights @ V | 비율표와 내용을 곱해, 낱말마다 내용을 비율대로 더한 결과를 만든다 |
pd.DataFrame(..., index=words, columns=words) | 텐서를 줄과 칸에 낱말 이름을 붙인 표로 바꿔 보기 좋게 찍는다 |
실제 모델처럼 쓰면
실제 모델에서는 Q, K, V 의 숫자를 사람이 정하지 않습니다. 낱말의 임베딩 X 에 가중치 Wq, Wk, Wv 를 곱해 만들고, 그 가중치를 학습으로 배웁니다. 좌표도 2개가 아니라 수십에서 수천 개입니다. 아래 코드는 위와 같은 네 걸음을, 낱말 4개와 좌표 8개짜리 난수로 실제 모델의 모양대로 적은 것입니다.
import torch

torch.manual_seed(0)
X = torch.randn(4, 8)                     # 낱말 4개의 임베딩(설명용 난수)
Wq, Wk, Wv = torch.randn(8, 8), torch.randn(8, 8), torch.randn(8, 8)

Q, K, V = X @ Wq, X @ Wk, X @ Wv          # 낱말마다 질문, 제목표, 내용
scores = Q @ K.T / 8 ** 0.5               # 낱말 쌍마다 점수, 크기 줄이기
weights = torch.softmax(scores, dim=-1)   # 줄마다 비율로(dim=-1: 마지막 축 방향)
out = weights @ V                         # 비율만큼 내용을 섞는다
print(weights.shape, out.shape)
print(weights.sum(dim=-1))                # 줄마다의 합
비율 표는 (4, 4), 결과는 (4, 8) 이고, 줄마다의 합은 모두 1 입니다. 입력과 결과의 모양이 같다는 점이 중요합니다. 그래서 같은 계산을 여러 층 겹쳐 쌓을 수 있습니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
torch.randn(4, 8) | 평균 0 근처의 난수로 (4, 8) 모양 텐서를 만든다. 여기서는 낱말 4개의 임베딩 대신 쓴다 |
X @ Wq | @ 는 행렬 곱이다. (4, 8) 과 (8, 8) 을 곱해 (4, 8) 의 Q 를 만든다. 실제 모델에서는 이 곱을 nn.Linear 가 한다 |
K.T | .T 는 전치다. 줄과 칸을 바꿔 (4, 8) 을 (8, 4) 로 만든다. 그래야 Q @ K.T 가 (4, 4) 점수표가 된다 |
/ 8 ** 0.5 | 좌표 수 8의 제곱근으로 나눈다. 앞의 "계산 순서" 표의 "크기 줄이기" 단계다 |
torch.softmax(scores, dim=-1) | 점수표의 줄마다 softmax 를 한다. dim=-1 은 마지막 축, 곧 한 줄 안의 칸들을 따라 합이 1이 된다는 뜻이다 |
weights @ V | (4, 4) 비율표와 (4, 8) 내용을 곱한다. 낱말마다 다른 낱말의 내용을 비율대로 섞은 (4, 8) 결과가 나온다 |
weights.sum(dim=-1) | 줄마다 합을 구한다. 낱말 4개의 합이 하나씩, 4개가 나온다 |
가장 헷갈리는 것은 dim 입니다. dim=-1 은 "마지막 축을 따라"라는 뜻이라서, (4, 4) 표에서는 한 줄 안의 네 칸을 묶어 계산합니다. dim=0 이었다면 한 칸 안의 네 줄을 묶어 세로 방향으로 합이 1이 됩니다.
이 코드가 뜻하는 것
이 코드는 "이불 배송 언제 와요"처럼 낱말 4개가 있는 문장에서, 낱말마다 다른 낱말을 얼마나 참고할지 정하고 그 비율대로 내용을 섞어 새 벡터를 만드는 셀프 어텐션 한 번을 그대로 흉내 냅니다. 학습하지 않은 난수로 계산하므로 비율에 뜻은 없고, 계산의 순서와 모양을 보는 코드입니다.
| 줄 | 하는 일 | 문장으로 치면 |
|---|---|---|
X = torch.randn(4, 8) | 낱말 4개의 임베딩(좌표 8개). 설명용 난수다 | 이불, 배송, 언제, 와요 네 낱말 |
Wq, Wk, Wv = ... | 질문, 제목표, 내용을 만들 가중치 세 개. 실제 모델에서는 학습으로 정해진다 | 쪽지와 제목표를 쓰는 규칙 |
Q, K, V = X @ Wq, ... | 낱말마다 질문(Q), 제목표(K), 내용(V)을 만든다 | 낱말마다 "내가 찾는 것", "나는 이런 것", "내 내용"을 적는다 |
Q @ K.T / 8 ** 0.5 | 모든 낱말 쌍의 질문과 제목표를 견줘 점수 16개(4×4)를 내고 크기를 줄인다 | "언제"의 질문을 네 낱말의 제목표와 하나씩 견준다 |
torch.softmax(..., dim=-1) | 줄마다 점수를 합이 1 인 비율로 바꾼다 | "언제"가 각 낱말을 몇 % 씩 참고할지 정한다 |
weights @ V | 비율대로 다른 낱말의 내용을 섞어 낱말마다 새 벡터를 만든다 | "언제"가 "배송"의 내용을 담아 "배송이 언제인가"라는 뜻이 된다 |
weights.sum(dim=-1) | 줄마다 합이 1 인지 확인한다 | 한 낱말이 나눠 준 참고 비율의 합은 100% |
비율표의 줄은 보는 낱말, 칸은 그 낱말이 참고하는 낱말입니다. 비율표가 (4, 4) 인 것은 낱말 4개가 서로를 하나씩 견줘서이고, 결과가 (4, 8) 인 것은 낱말마다 새 벡터가 하나씩 나와서입니다.
비율표를 찍어 보면
같은 코드 뒤에 비율표와 점수의 크기를 찍어 봅니다.
import torch

torch.manual_seed(0)
X = torch.randn(4, 8)
Wq, Wk, Wv = torch.randn(8, 8), torch.randn(8, 8), torch.randn(8, 8)
Q, K, V = X @ Wq, X @ Wk, X @ Wv
scores = Q @ K.T / 8 ** 0.5
weights = torch.softmax(scores, dim=-1)

print(weights.round(decimals=3))
# 점수의 평균 크기: 나누기 전과 √8 로 나눈 뒤
print((Q @ K.T).abs().mean().round(decimals=2), scores.abs().mean().round(decimals=2))tensor([[0.0000, 0.0670, 0.9320, 0.0000],
[0.0020, 0.0410, 0.0680, 0.8890],
[0.0000, 0.0000, 0.0000, 1.0000],
[0.0000, 0.0000, 1.0000, 0.0000]])
tensor(15.1400) tensor(5.3500)줄마다 한 칸에 0.9~1.0 이 몰려, 낱말마다 거의 한 낱말만 참고합니다. 가중치를 평균 0, 표준편차 1 인 큰 난수로 채워 점수가 크게 벌어졌기 때문입니다. √8 로 나눠 점수의 평균 크기가 15.14 에서 5.35 로 줄었는데도 softmax 가 한쪽으로 쏠립니다. 그래서 실제 모델은 가중치를 작은 값으로 시작하고, 학습하며 "언제 → 배송"처럼 뜻 있는 비율을 배웁니다.
한 문장으로 줄이면, 셀프 어텐션은 "질문과 제목표를 견줘 점수, 줄마다 비율, 비율대로 내용 섞기"이고, 그 결과 낱말마다 문장 속 다른 낱말을 참고해 다시 쓴 벡터가 나옵니다.
주의할 점
- 결과 벡터는 원래 낱말의 벡터가 아니라 "다른 낱말을 참고해 다시 쓴" 벡터입니다. 같은 "배송"이라도 문장에 따라 다른 벡터가 됩니다.
- 비율이 높다고 그 낱말이 "중요하다"는 사람의 판단과 늘 같지는 않습니다. 어텐션 표는 모델을 해석하는 힌트일 뿐입니다.