3장. Attention 과 Transformer, GPT 직접 구현
다음 글자 고르기: 생성과 온도
가위바위보 대회에 나간다고 해 봅시다. 상대가 바위를 낼 확률이 60% 라고 늘 보만 내면 상대가 금세 알아챕니다. 가끔은 확률이 낮은 손도 내야 합니다. GPT 도 다음 글자를 고를 때 늘 1등만 고를지, 확률대로 뽑을지를 정해야 합니다.
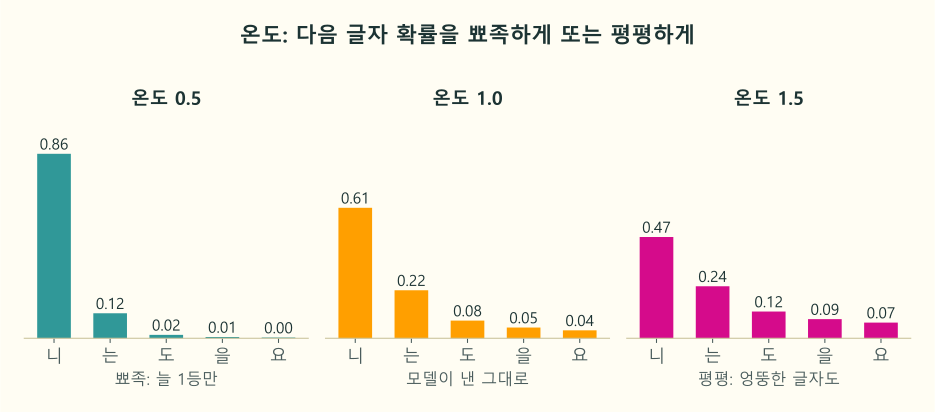
다음 글자 후보 다섯 개의 점수가 같을 때, 왼쪽 청록 막대는 온도 0.5 로 1등 "니"가 0.86 을 가져가 뾰족합니다. 가운데 주황 막대(온도 1.0)는 모델이 낸 그대로이고, 오른쪽 마젠타 막대(온도 1.5)는 평평해져 낮은 후보도 뽑힐 기회가 늘어납니다. 여기서 늘 같은 손을 내는 것이 낮은 온도, 이것저것 섞어 내는 것이 높은 온도입니다.
글이 만들어지는 순서
| 단계 | 하는 일 |
|---|---|
| 1 | 지금까지의 글을 모델에 넣어 마지막 자리의 "다음 글자 점수"를 받는다 |
| 2 | 점수를 온도로 나눈 뒤 softmax 로 확률을 만든다 |
| 3 | 확률대로 글자 하나를 뽑는다(가장 큰 것만 고르면 탐욕적 선택) |
| 4 | 뽑은 글자를 글 끝에 붙이고 1번으로 돌아간다 |
온도 고르기
| 온도 | 글의 모습 | 어울리는 일 |
|---|---|---|
| 0(또는 탐욕적 선택) | 늘 같은 답, 무난하지만 되풀이되기 쉽다 | 정해진 답, 실습 6과 프로젝트 |
| 0.5~1.0 | 자연스럽고 조금씩 다르다 | 일반 대화 |
| 1.5 이상 | 엉뚱하고 틀린 글자가 섞인다 | 거의 쓰지 않는다 |
import torch

torch.manual_seed(0)
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, 0.2])   # 다음 글자 후보 5개의 점수
for t in [0.5, 1.0, 1.5]:
    probs = torch.softmax(logits / t, dim=0)          # 온도로 나눈 뒤 확률로
    pick = torch.multinomial(probs, num_samples=10, replacement=True)   # 확률대로 10번 뽑기
    print(t, [round(v, 2) for v in probs.tolist()], pick.tolist())   # 확률은 소수 둘째 자리까지
온도 0.5 에서는 첫 후보의 확률이 0.86 이라 열 번 뽑아도 대부분 0번이 나오고, 1.5 에서는 0.47 로 줄어 다른 번호가 자주 섞입니다. 그림의 막대와 같은 숫자입니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
logits | softmax 를 지나기 전의 점수를 부르는 이름이다. 모델이 다음 글자 후보마다 내는 날것의 점수다 |
logits / t | 점수를 온도로 나눈다. 1보다 작은 온도는 점수 차이를 키우고, 1보다 큰 온도는 줄인다 |
torch.softmax(..., dim=0) | 나눈 점수를 합이 1인 확률로 바꾼다. 후보가 한 줄뿐이라 dim=0 이다 |
torch.multinomial(probs, num_samples=10, replacement=True) | 확률대로 번호를 뽑는다. 확률이 0.86 인 번호는 자주, 낮은 번호는 가끔 나온다 |
replacement=True | 뽑은 번호를 다시 넣고 뽑는다. 같은 번호가 여러 번 나올 수 있다. False 면 한 번 나온 번호는 다시 나오지 않는다 |
.tolist() | 텐서를 파이썬 목록으로 바꾼다. 출력을 읽기 쉽게 하려고 쓴다 |
torch.multinomial 은 확률대로 뽑는 함수이고, 늘 가장 큰 것만 고르는 탐욕적 선택은 argmax(가장 큰 값의 번호를 돌려준다)로 합니다. 같은 확률에서도 multinomial 은 실행마다 다를 수 있어서 torch.manual_seed(0) 로 씨앗을 고정했습니다.
이 코드가 뜻하는 것
가위바위보 비유로 읽으면, 이 코드는 "어떤 손을 낼지"를 세 가지 성격으로 정해 보는 코드입니다. 다음 글자 후보 다섯 개의 점수(3.0, 2.0, 1.0, 0.5, 0.2)는 그대로 두고, 온도만 0.5, 1.0, 1.5 로 바꿔 가며 확률을 만들고 10번씩 뽑아 봅니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
logits = torch.tensor([...]) | 후보 5개의 점수를 적는다 | 손마다 "이걸 낼 만하다"는 점수 |
logits / t | 점수를 온도로 나눈다 | 온도 0.5 로 나누면 3.0 이 6.0, 0.2 가 0.4 가 되어 점수 차이가 두 배로 벌어지고, 1.5 로 나누면 2.0 과 0.13 으로 차이가 줄어든다 |
torch.softmax(...) | 점수를 합이 1 인 확률로 바꾼다 | 손마다 낼 확률 |
torch.multinomial(...) | 확률대로 10번 뽑는다 | 확률이 적힌 제비뽑기 통에서 10번 뽑는다 |
print(t, 확률, 뽑힌 번호) | 온도마다 확률과 뽑힌 번호를 찍는다 | 성격마다 어떤 손을 냈는지 기록 |
곧 온도는 "점수 차이를 얼마나 크게 볼지" 정하는 손잡이입니다. 온도가 낮으면 1등이 거의 다 가져가고, 높으면 다른 후보에게도 몫이 돌아갑니다.
글자로 바꿔 눈으로 보기
번호만 보면 와닿지 않으니, 그림과 같은 후보 글자(니, 는, 도, 을, 요)를 붙이고 20번씩 뽑아 봅니다. 늘 1등만 고르는 탐욕적 선택도 함께 봅니다.
import torch

cands = ["니", "는", "도", "을", "요"]                  # 다음 글자 후보 5개
logits = torch.tensor([3.0, 2.0, 1.0, 0.5, 0.2])     # 후보마다 모델이 낸 점수

# 탐욕적 선택: 늘 점수가 가장 큰 후보 하나
print("탐욕적 선택:", cands[logits.argmax()])

torch.manual_seed(0)
for t in [0.5, 1.0, 1.5]:
    probs = torch.softmax(logits / t, dim=0)                         # 온도로 나눈 뒤 확률로
    picks = torch.multinomial(probs, num_samples=20, replacement=True)   # 확률대로 20번 뽑기
    word = "".join(cands[i] for i in picks)                          # 번호를 글자로 바꾼다
print(f"온도 {t}: 1등 '니' 의 확률 {probs[0]:.2f}, 뽑힌 글자 {word}, '니' 가 아닌 글자 {sum(c != '니' for c in word)}번")탐욕적 선택: 니
온도 0.5: 1등 '니' 의 확률 0.86, 뽑힌 글자 는니니는니니니니니니니니니니니니니니니니, '니' 가 아닌 글자 2번
온도 1.0: 1등 '니' 의 확률 0.61, 뽑힌 글자 니는니니니니니는는니는는니니니을니니는니, '니' 가 아닌 글자 7번
온도 1.5: 1등 '니' 의 확률 0.47, 뽑힌 글자 니니도니는니을니요을도니니요도니는도니는, '니' 가 아닌 글자 11번| 결과 | 읽는 법 |
|---|---|
| 탐욕적 선택 | 언제 몇 번을 해도 "니" 하나만 나온다. 가위바위보에서 늘 같은 손만 내는 것과 같다 |
| 온도 0.5 | 20번 가운데 18번이 "니"다. 무난하지만 같은 글이 되풀이되기 쉽다 |
| 온도 1.0 | "니"가 13번, "는"과 "을"이 섞였다. 모델이 낸 확률 그대로다 |
| 온도 1.5 | "니"가 아닌 글자가 11번으로 절반을 넘는다. 점수가 낮은 "요", "도"도 자주 나와 글이 엉뚱해지기 쉽다 |
20번 뽑은 결과라 씨앗을 바꾸면 횟수는 조금씩 달라집니다. 그래도 "온도가 높을수록 1등이 아닌 글자가 늘어난다"는 흐름은 같습니다.
주의할 점
- 온도는 모델이 아는 것을 바꾸지 않습니다. 같은 확률 분포에서 어떻게 뽑을지만 바꿉니다.
- 낮은 온도라도 모델이 틀린 것을 확신하고 있으면 틀린 답이 나옵니다. 사실처럼 그럴듯하게 틀리는 것을 환각이라 하고, 프로젝트에서 직접 봅니다.