3장. Attention 과 Transformer, GPT 직접 구현
실습 2 — 셀프 어텐션 손으로 계산하기
"이불 배송 언제 와요" 네 낱말로 Q, K, V 를 만들고, 점수, 마스크, softmax 를 차례로 계산해 어텐션 비율 표를 직접 구합니다. 마스크가 있을 때와 없을 때의 표를 그림으로 견줍니다. 가중치가 학습 전의 난수라서 비율은 아직 뜻이 없고, 계산의 순서를 익히는 실습입니다.
1단계. 낱말과 임베딩 준비
import torch
from torch import nn
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

torch.manual_seed(42)
words = ["이불", "배송", "언제", "와요"]
EMB = 8                                      # 좌표 수를 작게 잡아 계산을 눈으로 따라간다

emb = nn.Embedding(len(words), EMB)          # 낱말 4개의 임베딩 표
X = emb(torch.arange(len(words)))            # (4, 8): 낱말마다 좌표 8개
print(X.shape)torch.Size([4, 8])이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
import matplotlib.pyplot as plt | 그래프를 그리는 matplotlib 의 그리기 모듈을 plt 로 불러온다. 4단계에서 쓴다. |
plt.rcParams["font.family"] = "Malgun Gothic" | 그래프의 글꼴을 맑은 고딕으로 정한다. 기본 글꼴은 한글이 네모로 깨진다. |
plt.rcParams["axes.unicode_minus"] = False | 눈금의 빼기 기호를 보통 하이픈으로 쓴다. 맑은 고딕에서 빼기 기호가 깨지는 것을 막는다. |
torch.manual_seed(42) | 2장에서 본 씨앗 고정이다. 임베딩과 가중치의 난수가 실행마다 같다. |
nn.Embedding(len(words), EMB) | 낱말 4개에 좌표 8개씩 주는 임베딩 표다. 실습 1의 글자 대신 낱말을 번호로 쓴다. |
emb(torch.arange(len(words))) | 번호 0, 1, 2, 3을 한꺼번에 넣어 네 낱말의 좌표를 꺼낸다. 결과 모양은 (4, 8)이다. |
2단계. Q, K, V 와 점수
# bias=False: 곱하기만 하는 층. Q, K, V 를 만드는 가중치는 서로 다르다
Wq = nn.Linear(EMB, EMB, bias=False)
Wk = nn.Linear(EMB, EMB, bias=False)
Wv = nn.Linear(EMB, EMB, bias=False)

with torch.no_grad():                        # 학습이 아니라 계산만 하므로 기록을 끈다
    Q, K, V = Wq(X), Wk(X), Wv(X)
    scores = Q @ K.T / EMB ** 0.5            # 낱말 쌍마다 점수, 좌표 수의 제곱근으로 나눈다
print(scores.shape)
print(scores.round(decimals=2))torch.Size([4, 4])
tensor([[ 0.4400, 0.0100, -0.1400, 0.2100],
[-0.2300, 0.0400, -0.0700, 0.2500],
[ 0.1200, -0.2100, -0.2000, -0.8700],
[-0.1000, 0.3400, 0.6600, 0.0100]])이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
nn.Linear(EMB, EMB, bias=False) | 2장에서 본 선형 층이다. bias=False 라서 더하는 값 없이 가중치 행렬만 곱한다. |
with torch.no_grad(): | 이 안의 계산은 기울기를 구하려고 기록하지 않는다. 학습하지 않을 때 메모리와 시간을 아낀다. |
Wq(X), Wk(X), Wv(X) | 같은 입력 X 에 서로 다른 가중치를 곱해 Q, K, V 를 만든다. 셋 다 모양이 (4, 8)이다. |
K.T | 행렬의 행과 열을 바꾼다(전치). (4, 8)이 (8, 4)가 된다. |
Q @ K.T | 행렬 곱이다. (4, 8) @ (8, 4) = (4, 4)이고, 칸 (i, j)는 낱말 i 의 질문과 낱말 j 의 열쇠를 곱해 더한 점수다. |
/ EMB ** 0.5 | 점수를 좌표 수의 제곱근으로 나눈다. 좌표가 많을수록 점수가 커지는 것을 눌러 준다. |
scores.round(decimals=2) | 텐서의 값을 소수 둘째 자리까지 반올림해 보여 준다. |
출력의 4 × 4 표에서 줄은 "보는 쪽" 낱말, 칸은 "보는 대상" 낱말입니다. 아직 비율이 아니라서 줄마다 더해도 1이 되지 않습니다.
3단계. 마스크 씌우고 비율로 바꾸기
with torch.no_grad():
    # 마스크 없는 비율: 모든 낱말을 본다
    w_full = torch.softmax(scores, dim=-1)

    # 인과적 마스크: 아래 삼각형만 남기고 뒤쪽 칸의 점수를 -무한대로
    mask = torch.tril(torch.ones(4, 4))
    w_causal = torch.softmax(scores.masked_fill(mask == 0, float("-inf")), dim=-1)

    out = w_causal @ V                       # 비율만큼 내용을 섞은 결과
print("마스크 있는 비율:")
print(w_causal.round(decimals=2))
print("줄마다 합:", w_causal.sum(dim=-1).round(decimals=2).tolist())
print("결과 모양:", out.shape)마스크 있는 비율:
tensor([[1.0000, 0.0000, 0.0000, 0.0000],
[0.4300, 0.5700, 0.0000, 0.0000],
[0.4100, 0.2900, 0.3000, 0.0000],
[0.1700, 0.2700, 0.3700, 0.1900]])
줄마다 합: [1.0, 1.0, 1.0, 1.0]
결과 모양: torch.Size([4, 8])이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
torch.softmax(scores, dim=-1) | 점수를 0과 1 사이의 비율로 바꾸고 합이 1이 되게 한다. dim=-1 은 마지막 축, 곧 줄마다 따로 계산한다는 뜻이다. |
torch.ones(4, 4) | 값이 모두 1인 4 × 4 텐서를 만든다. |
torch.tril(...) | 대각선과 그 아래만 남기고 오른쪽 위를 0으로 만든다. 1인 칸이 "볼 수 있는 칸"이다. |
mask == 0 | 마스크가 0인 칸은 True, 나머지는 False 인 참·거짓 텐서를 만든다. |
scores.masked_fill(조건, float("-inf")) | 조건이 True 인 칸만 골라 -무한대로 바꾼 새 텐서를 돌려준다. 원래 scores 는 바뀌지 않는다. |
w_causal @ V | 비율 (4, 4)와 내용 V (4, 8)을 곱한다. 낱말마다 다른 낱말의 내용을 비율만큼 섞은 결과 (4, 8)이 나온다. |
w_causal.sum(dim=-1) | 줄마다 비율을 더한다. 모두 1.0이면 softmax 가 바르게 된 것이다. |
.tolist() | 텐서를 파이썬 리스트로 바꿔 짧게 출력한다. |
w_full 도 같은 점수로 만든 비율이지만 출력하지 않고 4단계의 왼쪽 그림에만 씁니다.
4단계. 두 비율 표를 그림으로 견주기
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
for ax, w, title in [(axes[0], w_full, "마스크 없음"), (axes[1], w_causal, "인과적 마스크")]:
    ax.imshow(w, vmin=0, vmax=1)                       # 비율이 클수록 밝은 색
    for i in range(4):
        for j in range(4):
            ax.text(j, i, f"{w[i, j]:.2f}", ha="center", va="center", color="white" if w[i, j] < 0.5 else "black")
    ax.set_xticks(range(4), words)
    ax.set_yticks(range(4), words)
    ax.set_xlabel("보는 대상(키)")
    ax.set_title(title)
axes[0].set_ylabel("보는 쪽(질문)")
plt.tight_layout()
plt.show()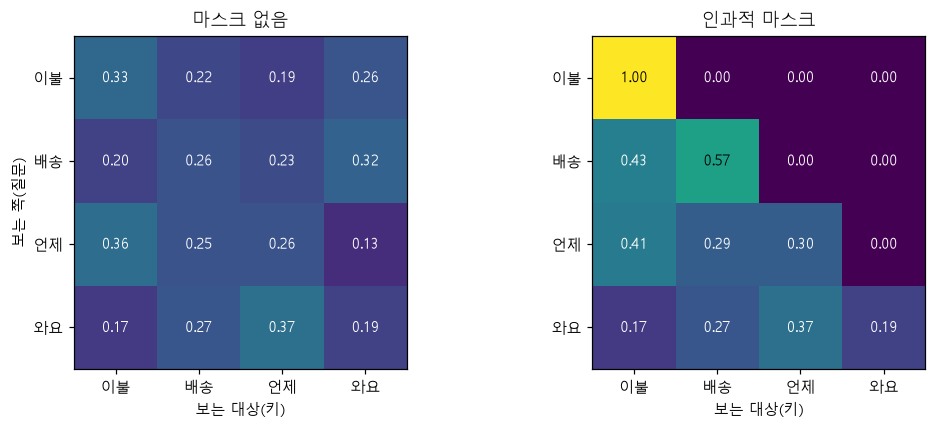
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
plt.subplots(1, 2, figsize=(10, 4)) | 그림판 하나에 1줄 2칸의 그래프 자리를 만든다. figsize 는 그림의 가로, 세로 크기(인치)다. axes[0], axes[1] 이 두 자리다. |
ax.imshow(w, vmin=0, vmax=1) | 표의 값을 색칸으로 그린다. vmin, vmax 로 색의 범위를 0~1로 묶어 두 그림의 색을 같은 기준으로 맞춘다. |
ax.text(j, i, 글, ha="center", va="center", color=…) | 칸 가운데에 숫자를 적는다. 가로 위치가 j(열), 세로 위치가 i(줄)다. ha, va 는 가로·세로 가운데 맞춤이다. |
f"{w[i, j]:.2f}" | 칸 하나의 값을 소수 둘째 자리 글자로 바꾼다. |
ax.set_xticks(range(4), words) | 가로 눈금 0~3 자리에 낱말 이름을 붙인다. set_yticks 는 세로 눈금이다. |
ax.set_xlabel, ax.set_ylabel, ax.set_title | 가로축 이름, 세로축 이름, 그래프 제목을 단다. |
plt.tight_layout() | 두 그래프와 글자가 겹치지 않게 간격을 맞춘다. |
plt.show() | 그림을 화면에 띄운다. |
imshow 의 그림에서는 왼쪽 위가 (0, 0)이고 아래로 갈수록 줄 번호가 커집니다. 그래서 ax.text 에는 줄 i 가 아니라 열 j 를 먼저 넣습니다.
이 실습이 뜻하는 것
이 실습은 네 낱말이 서로를 얼마나 참고할지 비율을 정하는 계산을 손으로 따라가 봅니다. 네 사람이 한 줄로 앉아 회의를 한다고 생각해 봅니다. 사람마다 자기소개 카드를 받고(1단계), "내가 궁금한 것" 카드와 "나는 이런 사람" 명찰, "내가 가진 정보" 메모를 만들어 궁금한 것과 명찰이 얼마나 맞는지 점수를 매깁니다(2단계). 그다음 자기보다 뒤에 앉은 사람은 못 보게 가리고, 점수를 "누구 말을 몇 할 들을지" 비율로 바꿔 메모를 섞습니다(3단계). 마지막으로 가렸을 때와 안 가렸을 때의 비율 표를 그림으로 견줍니다(4단계). 여기서 자기소개 카드가 임베딩, 궁금한 것이 Q, 명찰이 K, 메모가 V, 뒷사람을 가리는 것이 인과적 마스크입니다. 실제 회의와 달리 지금의 카드는 난수로 만든 것이라, 누가 누구를 많이 보는지에는 아직 이유가 없습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 임베딩 | torch.Size([4, 8]) | 낱말 4개가 저마다 숫자 8개짜리 좌표를 받았습니다 |
| 2. 점수 모양 | torch.Size([4, 4]) | 낱말 4개가 낱말 4개를 하나씩 보므로 점수가 4 × 4 = 16개입니다. 줄이 보는 쪽, 칸이 보는 대상입니다 |
| 2. 점수 값 | 가장 작은 값 -0.87, 가장 큰 값 0.66 | 아직 비율이 아닌 날 점수라 음수도 있고 줄마다 더해도 1이 아닙니다. 넷째 줄 "와요"는 "언제"에 준 점수(0.66)가 가장 큽니다 |
| 3. 첫째 줄 | [1.0000, 0.0000, 0.0000, 0.0000] | 맨 앞의 "이불"은 앞에 아무도 없어 자기 자신만 봅니다. 그래서 비율이 1.00 입니다 |
| 3. 둘째 줄 | [0.4300, 0.5700, 0.0000, 0.0000] | "배송"은 "이불"과 자기 자신만 볼 수 있습니다. 자기 점수(0.04)가 "이불" 점수(-0.23)보다 커서 자기 쪽 비율이 더 큽니다 |
| 3. 넷째 줄 | [0.1700, 0.2700, 0.3700, 0.1900] | 맨 뒤의 "와요"는 가릴 칸이 없어 네 낱말을 모두 봅니다. 점수가 가장 컸던 "언제"가 0.37 로 가장 큰 몫을 받습니다 |
| 3. 줄마다 합 | [1.0, 1.0, 1.0, 1.0] | softmax 를 지나 줄마다 비율의 합이 1이 되었습니다. "열 할을 나눠 듣는다"는 뜻입니다 |
| 3. 결과 모양 | torch.Size([4, 8]) | 낱말마다 다른 낱말의 V 를 비율만큼 섞은 새 좌표 8개를 얻었습니다. 들어간 모양과 나온 모양이 같습니다 |
| 4. 그림 | 오른쪽 그림의 오른쪽 위가 모두 0.00 | 마스크가 뒤쪽 칸을 가린 자리입니다. 마지막 줄 "와요"는 가릴 칸이 없어 두 그림의 숫자가 같습니다 |
한 줄로 줄이면, 점수를 매기고, 뒤를 가리고, 비율로 바꿔, 내용을 섞는 네 걸음이 셀프 어텐션의 전부입니다. 실습 3의 nn.MultiheadAttention 은 이 계산을 헤드 여러 개로 한꺼번에 해 주는 층입니다. 지금의 비율 숫자 자체는 난수 가중치에서 나온 것이라 "와요가 언제를 중요하게 본다" 같은 뜻으로 읽으면 안 됩니다. 비율에 뜻이 생기는 것은 학습을 한 뒤입니다.
코드 설명
nn.Linear(EMB, EMB, bias=False)는 편향 없이 가중치만 곱하는 층입니다. 셀프 어텐션 절의 Wq, Wk, Wv 가 이것입니다.- 점수는 -0.87 에서 0.66 사이의 작은 수들입니다. 마스크를 씌우고 비율로 바꾸면 첫 줄 "이불"은 자기 자신만 볼 수 있어 1.00 이 되고, 넷째 줄 "와요"는 네 낱말을 0.17, 0.27, 0.37, 0.19 로 나눠 봅니다. 줄마다 합은 모두 1.0 입니다.
- 그림의 오른쪽 위 삼각형은 모두 0.00 입니다. 마지막 줄 "와요"는 가릴 칸이 없어서 두 그림에서 숫자가 같습니다. 가중치가 학습 전의 난수라 어느 낱말을 많이 보는지에는 아직 뜻이 없습니다.
masked_fill(mask == 0, float("-inf"))는 마스크가 0 인 칸만 골라 -무한대로 바꿉니다. softmax 에서 e의 -무한대 제곱은 0 이라 그 칸의 비율이 0 이 됩니다.- 색은 matplotlib 의 기본 색표(viridis)입니다. 밝은 노랑일수록 비율이 크고, 짙은 보라일수록 작습니다.