3장. Attention 과 Transformer, GPT 직접 구현
실습 4 — 미니 GPT 학습하고 글 이어 쓰기
실습 3과 같은 미니 GPT 를 대화 글로 1,500번 학습시키고, 학습 손실과 검증 손실을 그래프로 봅니다. 학습한 가중치를 체크포인트로 저장하고, 온도를 바꿔 가며 글을 이어 쓰게 합니다. 결과를 같게 맞추려고 CPU 에서 학습하며, 이 PC 에서 1분쯤 걸렸습니다.
1단계. 실습 3과 같은 준비
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

with open("cs_dialogs.txt", encoding="utf-8") as f:
    text = f.read()
chars = sorted(set(text))
stoi = {c: i for i, c in enumerate(chars)}
itos = {i: c for c, i in stoi.items()}
encode = lambda s: [stoi[c] for c in s]
decode = lambda ids: "".join(itos[i] for i in ids)
V, BLOCK, EMB, HEADS, LAYERS = len(chars), 64, 64, 4, 2

data = torch.tensor(encode(text))
n = int(len(data) * 0.9)
train_data, val_data = data[:n], data[n:]


# 실습 3과 같은 모델 정의
class Block(nn.Module):
    def __init__(self):
        super().__init__()
        self.ln1 = nn.LayerNorm(EMB)
        self.attn = nn.MultiheadAttention(EMB, HEADS, batch_first=True)
        self.ln2 = nn.LayerNorm(EMB)
        self.ff = nn.Sequential(nn.Linear(EMB, 4 * EMB), nn.ReLU(), nn.Linear(4 * EMB, EMB))

    def forward(self, x):
        T = x.shape[1]
        mask = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
        h = self.ln1(x)
        x = x + self.attn(h, h, h, attn_mask=mask, need_weights=False)[0]
        return x + self.ff(self.ln2(x))


class MiniGPT(nn.Module):
    def __init__(self):
        super().__init__()
        self.tok_emb = nn.Embedding(V, EMB)
        self.pos_emb = nn.Embedding(BLOCK, EMB)
        self.blocks = nn.Sequential(*[Block() for _ in range(LAYERS)])
        self.ln = nn.LayerNorm(EMB)
        self.head = nn.Linear(EMB, V)

    def forward(self, idx, targets=None):
        T = idx.shape[1]
        x = self.tok_emb(idx) + self.pos_emb(torch.arange(T))
        logits = self.head(self.ln(self.blocks(x)))
        loss = None if targets is None else F.cross_entropy(logits.view(-1, V), targets.view(-1))
        return logits, loss

    @torch.no_grad()
    def generate(self, idx, n_new, temperature=1.0, generator=None):
        for _ in range(n_new):
            logits, _ = self(idx[:, -BLOCK:])
            probs = F.softmax(logits[:, -1, :] / temperature, dim=-1)
            idx = torch.cat([idx, torch.multinomial(probs, 1, generator=generator)], dim=1)
        return idx

print("준비 완료:", len(train_data), len(val_data))준비 완료: 72280 8032이 단계의 함수는 실습 3의 표와 같습니다. 새로 나온 것만 적습니다.
| 코드 | 쉬운 뜻 |
|---|---|
import matplotlib.pyplot as plt | 그래프를 그리는 matplotlib 의 그리기 도구를 plt 라는 이름으로 불러온다 |
plt.rcParams["font.family"] = "Malgun Gothic" | 그래프의 글꼴을 맑은 고딕으로 바꾼다. 한글이 네모로 깨지지 않게 한다 |
plt.rcParams["axes.unicode_minus"] = False | 눈금의 빼기 기호를 보통 - 로 적는다. 맑은 고딕에서 빼기 기호가 깨지는 것을 막는다 |
torch.tensor(encode(text)) | 글 전체를 글자 번호 목록으로 바꾼 뒤 1차원 텐서 하나로 만든다. 모양은 (글자 수,)이다 |
data[:n], data[n:] | 앞 90%를 학습용, 뒤 10%를 검증용으로 자른다. 출력의 72280 과 8032 가 두 조각의 글자 수이다 |
F.cross_entropy(...) if targets ... else None | 실습 3의 forward 와 같은 일을 한 줄로 줄여 적은 것이다. 정답이 없으면 손실을 계산하지 않는다 |
모델 정의는 실습 3과 글자 하나까지 같은 짜임입니다. 절이 바뀌면 처음부터 다시 실행되므로 다시 적었습니다.
2단계. 배치 만드는 법 보기
g = torch.Generator().manual_seed(42)     # 배치를 뽑는 순서를 고정한다

def get_batch(split, batch_size=32):
    """글의 아무 곳에서나 64글자 묶음을 batch_size 개 뽑는다. y 는 x 를 한 칸 민 것(다음 글자)."""
    d = train_data if split == "train" else val_data
    ix = torch.randint(len(d) - BLOCK - 1, (batch_size,), generator=g)   # 시작 위치들
    x = torch.stack([d[i:i + BLOCK] for i in ix])
    y = torch.stack([d[i + 1:i + BLOCK + 1] for i in ix])
    return x, y

xb, yb = get_batch("train", batch_size=1)
print("입력 앞 12글자:", repr(decode(xb[0, :12].tolist())))
print("정답 앞 12글자:", repr(decode(yb[0, :12].tolist())))입력 앞 12글자: '객: 텀블러 재고가 있'
정답 앞 12글자: ': 텀블러 재고가 있나'이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
torch.Generator().manual_seed(42) | 씨앗을 고정한 난수 발생기를 따로 만든다. 이것을 넘긴 함수만 이 순서대로 난수를 뽑으므로 배치가 늘 같게 나온다 |
torch.randint(len(d) - BLOCK - 1, (batch_size,), generator=g) | 0 이상 첫 인자 미만의 정수를 batch_size 개 뽑는다. 64글자 묶음과 그 다음 한 글자가 글 끝을 넘지 않게 상한을 줄였다 |
d[i:i + BLOCK] | 시작 위치 i 부터 64글자를 잘라 낸다. 이것이 입력 x 한 줄이다 |
d[i + 1:i + BLOCK + 1] | 한 칸 뒤에서 64글자를 잘라 낸다. 자리마다 "바로 다음 글자"가 정답이 된다 |
torch.stack([...]) | 길이가 같은 1차원 텐서 여러 개를 새 축으로 쌓아 2차원 텐서로 만든다. 모양은 (batch_size, 64)이다 |
xb[0, :12].tolist() | 배치의 첫 줄에서 앞 12개 번호를 꺼내 파이썬 목록으로 바꾼다. decode 에 넘겨 글자로 보려는 것이다 |
출력에서 정답 줄이 입력 줄보다 한 글자씩 앞서 있습니다. "객" 다음은 ":", ":" 다음은 " "처럼 자리마다 정답이 하나씩 붙습니다.
3단계. 학습하기
torch.manual_seed(42)
model = MiniGPT()
opt = torch.optim.AdamW(model.parameters(), lr=3e-3)   # Adam 에 가중치 감쇠를 더한 옵티마이저

steps, train_hist, val_hist = [], [], []
for step in range(1, 1501):
    xb, yb = get_batch("train")
    _, loss = model(xb, yb)          # 순전파 + 손실
    opt.zero_grad()                  # 지난 기울기 지우기
    loss.backward()                  # 역전파
    opt.step()                       # 가중치 고치기

    if step % 100 == 0:              # 100번마다 검증용 손실도 잰다
        with torch.no_grad():
            xv, yv = get_batch("val")
            _, val_loss = model(xv, yv)
        steps.append(step); train_hist.append(loss.item()); val_hist.append(val_loss.item())
        if step % 300 == 0:
            print(f"{step:5d}번  학습 손실 {loss.item():.3f}  검증 손실 {val_loss.item():.3f}")

# 체크포인트: 학습한 가중치를 파일로 저장해 둔다
torch.save(model.state_dict(), "out_minigpt.pt")
print("저장: out_minigpt.pt") 300번 학습 손실 0.138 검증 손실 0.173
600번 학습 손실 0.133 검증 손실 0.160
900번 학습 손실 0.144 검증 손실 0.142
1200번 학습 손실 0.142 검증 손실 0.133
1500번 학습 손실 0.125 검증 손실 0.161
저장: out_minigpt.pt이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
torch.optim.AdamW(model.parameters(), lr=3e-3) | 2장의 Adam 에 가중치 감쇠(weight decay, 기본 0.01)를 더한 옵티마이저이다. 가중치가 너무 커지지 않게 조금씩 줄여 준다. lr 은 한 번에 고치는 폭이다 |
model(xb, yb) | forward 를 부른다. 정답 yb 를 함께 주었으므로 점수와 손실을 함께 돌려준다 |
opt.zero_grad(), loss.backward(), opt.step() | 2장에서 본 학습 세 줄이다. 지난 기울기를 지우고, 기울기를 구하고, 가중치를 고친다 |
with torch.no_grad(): | 이 안의 계산은 기울기를 기록하지 않는다. 검증 손실은 재기만 하고 학습에는 쓰지 않으므로 메모리와 시간을 아낀다 |
loss.item() | 값이 하나 든 텐서에서 파이썬 숫자를 꺼낸다. 목록에 모아 그래프로 그리려는 것이다 |
model.state_dict() | 모델의 모든 가중치를 "층 이름 → 텐서" 꼴의 사전으로 돌려준다 |
torch.save(..., "out_minigpt.pt") | 그 사전을 파일로 저장한다. 이 파일이 체크포인트이다 |
이 실습에는 model.train() 이나 model.eval() 이 없습니다. 이 모델에는 드롭아웃이 없어 두 상태에서 계산이 같기 때문입니다. 드롭아웃이 있는 모델은 검증 앞에 model.eval() 을 부릅니다.
4단계. 손실 곡선과 온도별 글쓰기
plt.figure(figsize=(8, 3.5))
plt.plot(steps, train_hist, label="학습 손실")
plt.plot(steps, val_hist, label="검증 손실")
plt.xlabel("학습 횟수")
plt.ylabel("손실(교차 엔트로피)")
plt.title("미니 GPT 의 손실")
plt.legend()
plt.show()

start = torch.tensor([encode("고객: ")])
for temp in [0.5, 1.0, 1.5]:
    out = model.generate(start, 110, temperature=temp, generator=torch.Generator().manual_seed(1))
    print(f"===== 온도 {temp}")
print(decode(out[0].tolist()))===== 온도 0.5
고객: 후드티 사이즈가 안 맞아요.
상담원: 교환 신청을 해 주시면 새 사이즈로 다시 보내 드립니다.
고객: 운동화 환불은 언제 되나요?
상담원: 반품 상품을 받은 뒤 3일 안에 환불해 드립니다.
고객:
===== 온도 1.0
고객: 가습기 재고가 있나요?
상담원: 지금 가습기는 재고가 113개 남아 있습니다.
고객: 텀블러 쿠폰을 쓸 수 있나요?
상담원: 텀블러는 할인 쿠폰을 함께 쓸 수 있습니다.
고객: 텀블러는 할인 쿠폰을
===== 온도 1.5
고객: 가습기 재고가 있나요?
상담원: 지금 가습기는 재고가 7개 남아 있습니다.
고객: 청바지가 망가진 채로 왔어요.
상담원: 불편을 드려 죄습기는 전이라면 바로 동화 환불은 언제 되나요?
상담원: 반품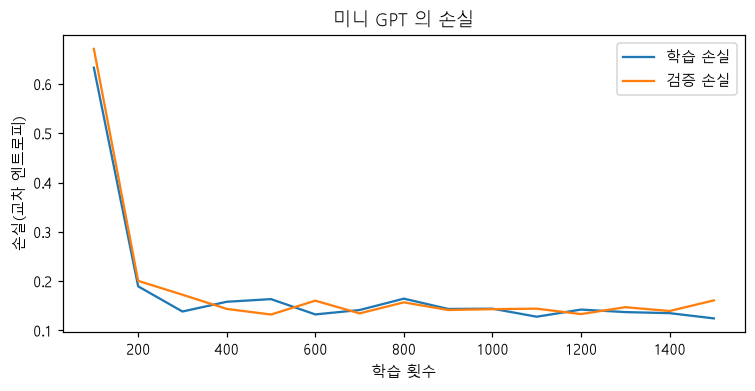
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
plt.figure(figsize=(8, 3.5)) | 새 그림판을 만든다. 크기는 가로 8, 세로 3.5 인치이다 |
plt.plot(steps, train_hist, label="학습 손실") | 가로에 학습 횟수, 세로에 손실을 놓고 선을 긋는다. label 은 범례에 나올 이름이다 |
plt.xlabel, plt.ylabel, plt.title | 가로축 이름, 세로축 이름, 그림 제목을 단다 |
plt.legend() | label 로 준 이름을 범례 상자로 보여 준다 |
plt.show() | 그린 그림을 화면에 띄운다 |
torch.tensor([encode("고객: ")]) | 시작 글을 번호로 바꾸고 바깥에 대괄호를 한 겹 더 씌워 모양 (1, 글자 수)의 배치로 만든다. 모델은 늘 (배치, 글자 수) 꼴을 받는다 |
model.generate(start, 110, temperature=temp, ...) | 실습 3의 generate 로 110글자를 이어 쓴다. 안에서 마지막 자리 점수를 temperature 로 나눈 뒤 softmax 로 확률을 만들고 torch.multinomial 로 한 글자를 뽑는다 |
generator=torch.Generator().manual_seed(1) | 온도마다 같은 씨앗의 발생기를 새로 만든다. 온도만 다르고 뽑는 난수는 같으므로 온도의 효과만 견줄 수 있다 |
out[0].tolist() | 배치의 첫(하나뿐인) 줄을 파이썬 목록으로 바꾼다. decode 로 글자로 되돌린다 |
온도로 나누면 점수 차이가 바뀝니다. 0.5 처럼 1보다 작으면 차이가 커져 1등 글자가 더 자주 뽑히고, 1.5 처럼 크면 차이가 줄어 낮은 글자도 자주 뽑힙니다.
이 실습이 뜻하는 것
이 실습은 실습 3에서 만든 빈 모델을 가르치고, 배운 뒤의 글솜씨를 봅니다. 받아쓰기 공부에 빗대 봅니다. 교재를 공부용과 시험용으로 나누고(1단계), "앞 글자를 보고 다음 글자를 맞히는" 문제 카드를 만드는 법을 봅니다(2단계). 카드 묶음으로 1,500번 연습하며 300번마다 쪽지시험 점수를 적고, 다 배운 머릿속을 공책에 옮겨 둡니다(3단계). 마지막으로 성적 그래프를 보고, 대담함을 바꿔 가며 글을 지어 보게 합니다(4단계). 여기서 문제 카드 묶음이 배치, 쪽지시험 점수가 손실, 공책이 체크포인트, 대담함이 온도입니다. 받아쓰기 점수와 달리 손실은 낮을수록 좋습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | 72280 8032 | 실습 1과 같은 나누기입니다. 앞 72,280글자로 배우고, 뒤 8,032글자는 시험용으로 남겨 둡니다 |
| 2. 배치 | 입력 '객: 텀블러 재고가 있', 정답 ': 텀블러 재고가 있나' | 정답은 입력을 한 글자 민 것입니다. "객" 다음은 ":", "있" 다음은 "나"처럼 자리마다 문제가 하나씩 있어, 64글자 묶음 하나가 64문제가 됩니다 |
| 3. 300번째 | 학습 손실 0.138, 검증 손실 0.173 | 이미 손실이 많이 낮습니다. 124글자 가운데 아무렇게나 고르는 모델이라면 손실이 ln 124 ≈ 4.82 쯤입니다 |
| 3. 1500번째 | 학습 손실 0.125, 검증 손실 0.161 | e 의 -0.125 제곱 ≈ 0.88 이므로, 모델이 정답 글자에 준 확률을 평균 내면(곱해서 고르게 나눈 평균) 0.88 쯤이라는 뜻입니다 |
| 3. 오르내림 | 검증 손실 0.173 → 0.160 → 0.142 → 0.133 → 0.161 | 꾸준히 줄지 않고 흔들립니다. 100번마다 배치 하나로만 재서 생기는 흔들림이고, 학습과 검증이 비슷해 과적합은 보이지 않습니다 |
| 3. 저장 | 저장: out_minigpt.pt | 배운 가중치를 파일로 남겼습니다. 다음에는 학습 없이 이 파일만 불러 쓰면 됩니다 |
| 4. 온도 0.5 | 후드티 교환, 운동화 환불 대화 | 데이터의 문장 틀 그대로의 바른 대화입니다. 1등 글자를 주로 고르니 안전하지만 늘 비슷한 글이 나옵니다 |
| 4. 온도 1.0 | "재고가 113개", 끝에 "고객: 텀블러는 할인 쿠폰을" | 대부분 바르지만 데이터에 없는 숫자(재고는 2~19개)를 만들고, 고객 줄에 상담원의 말이 들어갑니다 |
| 4. 온도 1.5 | "불편을 드려 죄습기는 전이라면…" | 낮은 순위의 글자까지 자주 뽑혀 문장이 무너집니다 |
한 줄로 줄이면, 다음 글자 맞히기를 1,500번 연습한 것만으로 모델이 상담 대화의 꼴을 흉내 내게 되었고, 온도가 높을수록 글이 자유로워지는 대신 틀리기 쉽습니다. 저장한 체크포인트를 불러 쓰는 방식은 실습 5의 from_pretrained 로 이어집니다. 손실이 0.1 대로 낮은 것은 대화가 같은 문장 틀 여덟 가지로 지어져 맞히기 쉬워서이고, 모델이 쇼핑몰 일을 이해한다는 뜻은 아닙니다. 이 실습은 CPU 에서 돌렸으며, 다른 PC 나 다른 버전에서는 손실 숫자가 조금 다를 수 있습니다.
코드 설명
get_batch의y는x를 한 칸 뒤로 민 것입니다. 2단계 출력처럼 입력이 "고객: …"이면 정답은 "객: …"입니다. 자리마다 "다음 글자"가 정답이라, 64글자 묶음 하나로 64문제를 한꺼번에 풉니다. 마스크가 이것을 가능하게 합니다.- 손실은 100번째에 0.6 대에서 200번째에 0.2 아래로 크게 떨어지고, 그 뒤로는 0.12~0.17 사이에서 오르내립니다. 학습 손실과 검증 손실이 거의 붙어 다니므로 과적합은 보이지 않습니다. 오르내림은 100번마다 배치 하나로만 재서 생긴 흔들림입니다(1500번째의 검증 손실 0.161 이 1200번째의 0.133 보다 큰 것도 이 때문입니다).
- 손실이 이렇게 낮은 것은 대화가 같은 문장 틀 여덟 가지로 지어져 다음 글자를 맞히기 쉽기 때문입니다. 실제 사람의 글로 학습하면 손실은 훨씬 높게 남습니다.
- 온도 0.5 의 글은 데이터의 문장 틀과 똑같은 바른 대화입니다. 온도 1.0 도 대부분 바르지만 "재고가 113개"처럼 데이터에 없는 숫자(재고는 2~19개)를 만들고, 마지막 줄에서 고객이 상담원의 말을 하기 시작합니다. 온도 1.5 에서는 "죄송합니다" 자리에 "죄습기는"처럼 엉뚱한 글자가 섞여 문장이 무너집니다. "다음 글자 고르기" 절의 표대로입니다.
torch.save(model.state_dict(), ...)가 체크포인트 패턴입니다. 다음에 쓸 때는MiniGPT()를 만든 뒤load_state_dict(torch.load("out_minigpt.pt"))로 불러옵니다.