7장. 자체 임베딩과 벡터DB, 검색 품질
임베딩이란
지도 앱을 떠올려 봅시다. 가게마다 위도와 경도라는 숫자 두 개가 붙어 있고, 숫자가 비슷하면 지도에서 가까이 있습니다. 임베딩은 글에 이런 좌표를 붙이는 일입니다. 다만 좌표가 두 개가 아니라 수백 개이고, 가까운 것은 거리가 아니라 뜻입니다.
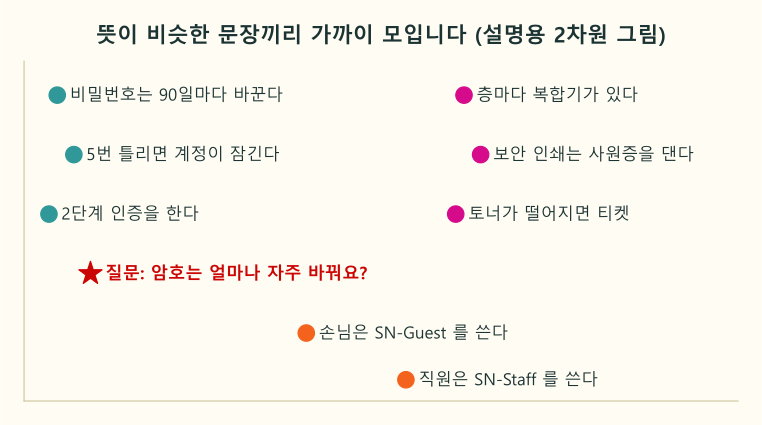
점 하나가 문장 하나입니다. 청록 점은 비밀번호와 계정, 마젠타 점은 프린터와 인쇄, 다홍 점은 와이파이에 관한 문장입니다. 빨강 별은 "암호는 얼마나 자주 바꿔요?"라는 질문으로, 낱말 "비밀번호"가 없어도 청록 무리 가까이 놓입니다. 실제 임베딩은 384차원이라 그릴 수 없어서, 설명을 위해 2차원에 자리를 정해 그린 그림입니다. 여기서 가게가 문장, 위도·경도가 임베딩입니다.
키워드 표현과 임베딩
| 견줄 것 | TF-IDF(6장) | 임베딩(이 장) |
|---|---|---|
| 숫자 줄의 길이 | 글자 조각의 가짓수(수천) | 모델이 정한 차원(e5-small 은 384) |
| 숫자의 뜻 | 그 조각이 몇 번, 얼마나 드물게 나왔나 | 학습으로 익힌 뜻의 좌표 |
| 대부분의 값 | 0 (나오지 않은 조각) | 0 이 아닌 작은 수 |
| "암호"와 "비밀번호" | 겹치는 글자가 없어 멀다 | 뜻이 같아 가깝다 |
| 만드는 법 | 문서에서 바로 센다 | 학습된 임베딩 모델이 만든다 |
숫자 줄로 견주기
임베딩끼리의 가까움은 6장과 같이 코사인 유사도로 잽니다. 정규화한 벡터라면 내적(@)이 곧 코사인 유사도입니다.
import numpy as np

# 설명을 위해 3차원으로 정한 가짜 임베딩
vecs = {"비밀번호를 바꿔요": np.array([0.9, 0.1, 0.1]),
        "암호를 새로 정해요": np.array([0.8, 0.2, 0.1]),
        "프린터가 안 돼요":   np.array([0.1, 0.9, 0.2])}
# 길이를 1 로 맞춘다(정규화). 그러면 내적이 코사인 유사도다
unit = {k: v / np.linalg.norm(v) for k, v in vecs.items()}
q = unit["비밀번호를 바꿔요"]
for k, v in unit.items():
    print(f"{q @ v:.3f}  {k}")
"암호를 새로 정해요"는 0.991 로 가깝고, "프린터가 안 돼요"는 0.237 로 멉니다. 실습 1에서는 진짜 임베딩 모델로 같은 일을 합니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
np.array([0.9, 0.1, 0.1]) | 숫자 세 개를 한 줄로 묶은 벡터다. 여기서는 문장 하나의 가짜 임베딩이다 |
np.linalg.norm(v) | 벡터의 길이를 잰다. linalg 는 linear algebra(선형대수), norm 은 "크기"라는 뜻이다. 숫자마다 제곱해 더한 뒤 제곱근을 씌운다 |
v / np.linalg.norm(v) | 벡터를 자기 길이로 나눈다. 방향은 그대로 두고 길이만 1 로 맞추는 정규화다 |
q @ v | 두 벡터의 내적이다. 같은 자리의 숫자끼리 곱해 모두 더한다. 길이가 1 인 벡터끼리라면 이 값이 코사인 유사도다 |
f"{q @ v:.3f}" | 소수 셋째 자리까지 적는다 |
이 코드가 뜻하는 것
나침반 바늘로 생각하면 쉽습니다. 두 바늘이 같은 쪽을 가리키면 1, 직각으로 엇갈리면 0 에 가깝습니다. 바늘이 길든 짧든 가리키는 방향만 봅니다. 여기서 바늘이 임베딩, 바늘 사이의 각도를 숫자로 바꾼 것이 코사인 유사도입니다. 비유와 다른 점은, 실제 임베딩은 방향이 2개가 아니라 384개인 공간을 가리킨다는 것입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
vecs = {...} | 문장 셋에 3차원 가짜 임베딩을 붙인다 | 문장마다 바늘 하나를 정한다 |
unit = {k: v / np.linalg.norm(v) ...} | 모든 벡터의 길이를 1 로 맞춘다 | 바늘 길이를 똑같이 자른다 |
q = unit["비밀번호를 바꿔요"] | 기준이 될 문장을 고른다 | 견줄 기준 바늘 |
print(f"{q @ v:.3f} {k}") | 기준과 각 문장의 내적을 찍는다 | 두 바늘이 얼마나 같은 쪽을 보는지 |
결과의 첫 줄은 자기 자신과의 값이라 1.000 이 나옵니다. "암호"와 "비밀번호"는 낱말이 달라도 바늘 방향이 거의 같아서 0.991 이 나오고, 프린터 문장은 다른 쪽을 가리켜 0.237 에 그칩니다.
작게 줄여서 눈으로 보기
정규화가 왜 필요한지 2차원 벡터 셋으로 봅니다. b 는 a 와 방향은 같고 길이만 두 배, c 는 a 와 직각 방향입니다.
import numpy as np

a = np.array([3.0, 4.0])        # 길이 5 인 2차원 벡터
b = np.array([6.0, 8.0])        # 같은 방향, 길이만 두 배
c = np.array([4.0, -3.0])       # a 와 직각 방향

print("길이:", np.linalg.norm(a), np.linalg.norm(b), np.linalg.norm(c))
print("내적 a·b:", a @ b, " a·c:", a @ c)

ua, ub, uc = (v / np.linalg.norm(v) for v in (a, b, c))   # 길이를 1 로
print("정규화한 a:", ua, " 길이:", np.linalg.norm(ua))
print("코사인 a,b:", round(float(ua @ ub), 3), " a,c:", round(float(ua @ uc), 3))길이: 5.0 10.0 5.0
내적 a·b: 50.0 a·c: 0.0
정규화한 a: [0.6 0.8] 길이: 1.0
코사인 a,b: 1.0 a,c: 0.0| 결과 | 읽는 법 |
|---|---|
| 길이 5.0, 10.0, 5.0 | b 는 a 보다 두 배 깁니다. 방향은 같습니다 |
| 내적 50.0 과 0.0 | 정규화 전의 내적은 길이에 따라 커집니다. 50.0 만 보고는 얼마나 닮았는지 알기 어렵습니다 |
| 정규화한 a 는 [0.6 0.8] | 3 과 4 를 길이 5 로 나눠 길이가 1.0 이 되었습니다 |
| 코사인 1.0 과 0.0 | 길이를 맞추고 나면 같은 방향은 1.0, 직각은 0.0 입니다. 이제 숫자가 "얼마나 같은 쪽을 보는지"만 뜻합니다 |
그래서 임베딩은 정규화한 뒤 내적을 씁니다. 그러면 글의 길이처럼 뜻과 상관없는 차이에 점수가 흔들리지 않습니다.
주의할 점
- 임베딩의 숫자 하나하나에는 사람이 읽을 뜻이 없습니다. "몇 번째 숫자가 비밀번호"처럼 읽으려 하지 말고, 벡터끼리의 가까움만 씁니다.
- 임베딩 모델이 다르면 좌표계가 다릅니다. 문서를 A 모델로, 질문을 B 모델로 임베딩하면 견줄 수 없습니다. 모델을 바꾸면 문서 임베딩도 모두 다시 만듭니다.