7장. 자체 임베딩과 벡터DB, 검색 품질
실습 5 — 조각 크기 견주기
같은 IT 지원 안내를 제목 단위, 100글자, 100글자(30글자 겹침), 300글자로 나눠, 나누는 법마다 키워드 검색과 의미 검색의 hit@1, hit@3 을 잽니다. 결과를 막대그래프로 그립니다.
1단계. 네 가지로 나누기
import json
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sentence_transformers import SentenceTransformer
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

plt.rcParams["font.family"] = "Malgun Gothic"     # 그래프의 한글 글꼴
text = open("it_helpdesk.md", encoding="utf-8").read()
qa = [json.loads(line) for line in open("it_helpdesk_qa.jsonl", encoding="utf-8")]
sections = ["## " + s.strip() for s in text.split("\n## ")[1:]]
body = "\n\n".join(sections)                       # 제목 단위 조각을 다시 이어 붙인 본문

def by_size(size, step):
    """size 글자씩, step 글자마다 새로 시작한다. step < size 면 겹친다"""
    return [body[i:i + size] for i in range(0, len(body), step)]

ways = {"제목 단위": sections, "100글자": by_size(100, 100),
        "100글자+겹침30": by_size(100, 70), "300글자": by_size(300, 300)}
for name, cs in ways.items():
print(f"{name:12s} 조각 {len(cs):3d}개 · 평균 {np.mean([len(c) for c in cs]):.0f}글자")제목 단위 조각 30개 · 평균 92글자
100글자 조각 29개 · 평균 97글자
100글자+겹침30 조각 41개 · 평균 98글자
300글자 조각 10개 · 평균 282글자2단계. 나누는 법마다 재기
emb = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")
Q = emb.encode(["query: " + r["질문"] for r in qa], normalize_embeddings=True)

def hits(scores, chunks):
    """scores: (질문 수, 조각 수). 정답 조각(근거 글이 든 조각)의 hit@1, hit@3"""
    h1 = h3 = 0
    for n, r in enumerate(qa):
        order = np.argsort(-scores[n]).tolist()
        gold = [i for i, c in enumerate(chunks) if r["근거"] in c]
        best = min((order.index(g) for g in gold), default=999) + 1   # 근거가 잘려 정답 조각이 없으면 999
        h1 += best == 1
        h3 += best <= 3
    return h1, h3

rows = []
for name, cs in ways.items():
    E = emb.encode(["passage: " + c for c in cs], normalize_embeddings=True)
    vec = TfidfVectorizer(analyzer="char_wb", ngram_range=(2, 3))
    X = vec.fit_transform(cs)
    k1, k3 = hits(cosine_similarity(vec.transform([r["질문"] for r in qa]), X), cs)
    s1, s3 = hits(Q @ E.T, cs)
    rows.append({"나누는 법": name, "조각 수": len(cs), "키워드 hit@1": k1, "키워드 hit@3": k3,
                 "의미 hit@1": s1, "의미 hit@3": s3})
result = pd.DataFrame(rows)
print(result.to_string(index=False)) 나누는 법 조각 수 키워드 hit@1 키워드 hit@3 의미 hit@1 의미 hit@3
제목 단위 30 26 33 30 34
100글자 29 22 29 24 30
100글자+겹침30 41 22 30 26 32
300글자 10 25 34 19 273단계. 그래프로 보기
ax = result.set_index("나누는 법")[["키워드 hit@1", "의미 hit@1"]].plot.bar(figsize=(8, 4), rot=0)
ax.set_ylabel("1등으로 맞힌 질문 수 (36개 중)")
ax.set_title("나누는 법에 따른 hit@1")
plt.tight_layout()
plt.show()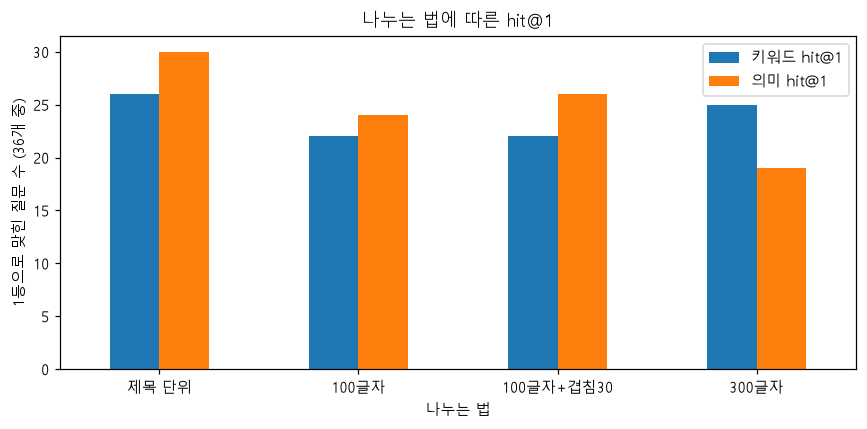
이 실습이 뜻하는 것
이 실습은 같은 피자 한 판을 네 가지로 잘라 보고, 어느 크기가 손님이 찾는 토핑을 가장 잘 집어 주는지 견주는 것과 같습니다. 피자를 메뉴 구획(제목)대로, 100글자 자로, 100글자에 30글자씩 겹치게, 300글자 자로 네 번 자르고(1단계), 자른 방법마다 두 검색으로 36문제를 풀어 점수를 내고(2단계), 1등으로 맞힌 수를 막대그래프로 그립니다(3단계). 여기서 피자 한 판이 IT 지원 안내 전체, 조각이 검색 단위인 청크(chunk, 덩어리), 토핑이 질문의 근거 글입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 제목 단위 | 30개 · 평균 92글자 | 주제마다 한 조각입니다 |
| 1. 100글자 | 29개 · 평균 97글자 | 길이는 비슷하지만 주제의 경계를 보지 않고 자릅니다 |
| 1. 100글자+겹침30 | 41개 · 평균 98글자 | 30글자씩 겹쳐 자르니 조각이 41개로 늘었습니다 |
| 1. 300글자 | 10개 · 평균 282글자 | 한 조각에 주제 서너 개가 섞입니다 |
| 2. 제목 단위 | 키워드 26·33, 의미 30·34 | 의미 검색이 네 방법 가운데 가장 좋은 점수(1등 30개, 위 3개 34개)를 냈습니다 |
| 2. 100글자 | 키워드 22·29, 의미 24·30 | 문장이 중간에서 끊겨 두 검색 모두 떨어졌습니다 |
| 2. 100글자+겹침30 | 키워드 22·30, 의미 26·32 | 겹치기가 끊긴 문장을 살려 의미 검색이 조금 되살아났습니다 |
| 2. 300글자 | 키워드 25·34, 의미 19·27 | 키워드 검색은 버텼지만 의미 검색은 가장 크게 떨어졌습니다. 여러 주제가 섞여 임베딩이 흐려졌기 때문입니다 |
| 3. 그래프 | 나누는 법마다 hit@1 막대 둘 | 위 표의 hit@1 을 그림으로 견줍니다. 300글자에서만 키워드 막대가 의미 막대보다 깁니다 |
한 줄로 줄이면, 이 문서에서는 주제(제목) 단위로 나눈 것이 의미 검색에 가장 잘 맞고, 너무 작게 자르면 문장이 끊기고 너무 크게 자르면 뜻이 흐려진다는 실습입니다. 겹치기는 끊긴 곳을 조금 살리지만 조각 수(41개)가 늘어 검색할 양도 늘어납니다. 문서 하나와 질문 36개로 낸 결과라, 다른 문서에서는 알맞은 크기가 달라질 수 있습니다. 실습 6은 제목 단위 조각으로 두 검색을 섞습니다.
코드 설명
by_size(size, step)은 6장 실습 2의 글자 수 자르기와 같습니다.step을size보다 작게 주면 앞 조각과 겹칩니다.- 제목 단위는 30조각(평균 92글자), 100글자는 29조각, 30글자를 겹친 100글자는 41조각, 300글자는 10조각(평균 282글자)입니다. 근거 글이 두 조각에 걸쳐 잘리면 그 질문은 정답 조각이 없어 틀린 것으로 셉니다.
- 제목 단위가 의미 검색에서 가장 좋습니다(hit@1 30, hit@3 34). 100글자로 자르면 두 검색 모두 떨어지고(키워드 22, 의미 24), 30글자씩 겹치면 의미 검색이 26 으로 조금 되살아납니다. 문장이 잘리는 것을 겹치기가 덜어 준 것입니다.
- 300글자로 크게 자르면 키워드 검색은 hit@1 25 로 버티지만, 의미 검색은 19 로 가장 크게 떨어집니다. 한 조각에 주제 서너 개가 섞여 임베딩이 흐려지기 때문입니다. 본문 "문서 나누기"의 너무 큰 피자 조각입니다.