7장. 자체 임베딩과 벡터DB, 검색 품질
검색 품질 평가
학원에서 모의고사를 보면 점수가 나와 어느 과목이 약한지 압니다. 검색도 정답이 붙은 질문 묶음으로 시험을 봐야 무엇을 고쳐야 할지 압니다. 느낌으로 "잘 찾는 것 같다"고 넘기지 않습니다.
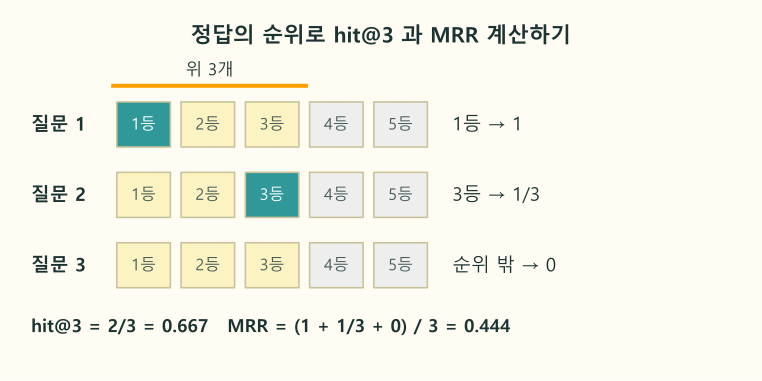
질문 세 개 가운데 첫째는 정답 조각이 1등, 둘째는 3등, 셋째는 위 3개 밖입니다. hit@3 은 위 3개 안에 든 질문의 비율이라 2/3 이고, MRR 은 1, 1/3, 0 의 평균이라 0.444 입니다. MRR 은 정답이 위에 있을수록 더 높은 점수를 줍니다. 여기서 모의고사가 질문 묶음, 과목별 점수가 hit@k 와 MRR 입니다.
지표 견주기
| 지표 | 계산 | 알려 주는 것 |
|---|---|---|
| hit@1 | 정답이 1등인 질문의 비율 | 첫째 조각만 붙일 때 맞는가 |
| hit@k | 정답이 위 k 개 안인 질문의 비율 | k 개를 붙이면 LLM 이 답을 볼 수 있는가 |
| MRR | 1 / 정답 순위의 평균(못 찾으면 0) | 정답을 얼마나 위에 올리는가 |
정답 표는 질문마다 "어느 조각이 정답인지"를 적은 것입니다. 이 장의 it_helpdesk_qa.jsonl 은 조각 번호 대신 정답 조각에 들어 있어야 할 글(근거)을 적어 두어, 조각을 어떻게 나누든 그 글이 든 조각을 정답으로 봅니다.
순위로 지표 계산하기
def metrics(ranks, k=3):
    """ranks: 질문마다 정답의 순위(1 부터). 못 찾았으면 None"""
    n = len(ranks)
    hit1 = sum(r == 1 for r in ranks) / n
    hitk = sum(r is not None and r <= k for r in ranks) / n
    mrr = sum(1 / r for r in ranks if r is not None) / n
    return round(hit1, 3), round(hitk, 3), round(mrr, 3)

print(metrics([1, 3, None]))          # 위 그림의 세 질문
print(metrics([1, 1, 2, 1, 5]))
그림의 세 질문은 (0.333, 0.667, 0.444), 둘째 줄은 (0.6, 0.8, 0.74) 입니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
ranks | 질문마다 정답 조각이 몇 등이었는지 적은 목록이다. 위 k 개 안에서 못 찾았으면 None 이다 |
sum(r == 1 for r in ranks) / n | 1등인 질문의 수를 세어 전체 질문 수로 나눈다. True 는 1, False 는 0 으로 더해진다. 이것이 hit@1 이다 |
r is not None and r <= k | 정답을 찾았고 그 순위가 k 이하인지 본다. None 을 먼저 걸러야 None <= 3 같은 오류가 나지 않는다 |
1 / r | 순위의 역수다. 1등은 1, 2등은 0.5, 3등은 0.333 이다 |
sum(...) / n (MRR 줄) | 찾은 질문의 역수만 더하고 전체 질문 수로 나눈다. 못 찾은 질문은 0 을 더한 것과 같다 |
이 코드가 뜻하는 것
모의고사 채점표로 생각합니다. 질문 하나가 문제 하나이고, 정답이 몇 등에 나왔는지가 그 문제의 답안입니다. hit@k 는 "k 등 안에만 들면 맞음"으로 채점한 점수이고, MRR 은 "1등이면 만점, 뒤로 갈수록 부분 점수"로 채점한 점수입니다. 여기서 문제지가 질문 묶음, 채점 기준이 지표입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
hit1 = ... | 1등인 질문의 비율 | 첫 답만 보고 맞힌 비율 |
hitk = ... | k 등 안인 질문의 비율 | 세 번 안에 맞힌 비율 |
mrr = ... | 역순위의 평균 | 빨리 맞힐수록 점수를 더 주는 채점 |
metrics([1, 3, None]) | 그림의 세 질문을 채점한다 | 세 문제짜리 모의고사 |
metrics([1, 1, 2, 1, 5]) | 다섯 질문을 채점한다 | 다섯 문제짜리 모의고사 |
둘째 줄에서 5등인 질문은 hit@3 에서는 틀린 것으로 셉니다. 그래도 MRR 에서는 1/5 = 0.2 만큼 부분 점수를 받아, 1 + 1 + 0.5 + 1 + 0.2 = 3.7 을 5 로 나눈 0.74 가 됩니다.
작게 줄여서 눈으로 보기
위 코드는 순위가 이미 주어져 있습니다. 실제로는 검색 결과 목록에서 정답이 몇 번째인지 먼저 찾아야 합니다. 그 한 걸음을 따라가 봅니다.
import numpy as np

ranked = ["와이파이", "계정 잠김", "보안 인쇄", "비밀번호 주기"]   # 검색이 내놓은 순서(설명용)
answer = "보안 인쇄"                                               # 정답 조각
rank = ranked.index(answer) + 1                                    # 0 부터 세므로 1 을 더한다
print("정답 순위:", rank)
print("hit@1:", rank <= 1, " hit@3:", rank <= 3)
print("역순위 1/순위:", round(1 / rank, 3))

ranks = [1, 3, None]
rr = [0 if r is None else 1 / r for r in ranks]
print("질문별 역순위:", [round(x, 3) for x in rr], " MRR:", round(float(np.mean(rr)), 3))정답 순위: 3
hit@1: False hit@3: True
역순위 1/순위: 0.333
질문별 역순위: [1.0, 0.333, 0] MRR: 0.444| 결과 | 읽는 법 |
|---|---|
| 정답 순위 3 | "보안 인쇄"가 목록의 세 번째에 있습니다. index 는 0 부터 세서 2 를 돌려주므로 1 을 더했습니다 |
| hit@1 False, hit@3 True | 1등은 아니지만 위 3개 안에는 들었습니다 |
| 역순위 0.333 | 3등이라 1/3 입니다 |
| 질문별 역순위와 MRR 0.444 | 그림의 세 질문(1등, 3등, 못 찾음)을 1.0, 0.333, 0 으로 바꿔 평균을 냈습니다. 위 metrics 의 결과와 같습니다 |
실습 4에서는 질문마다 이 "정답이 몇 번째인가"를 구한 뒤 같은 셈을 합니다. 다만 정답 판정은 조각 이름이 아니라 근거 글이 든 조각인지로 합니다.
주의할 점
- 질문 묶음은 실제 사용자가 할 법한 말로 만듭니다. 문서의 문장을 그대로 베낀 질문은 어떤 검색이든 잘 찾아 시험이 너무 쉬워집니다. 이 장의 질문은 문서와 낱말을 일부러 바꾼 "뜻" 질문과, 코드·이름이 그대로 든 "낱말" 질문을 섞었습니다.
- 질문이 수십 개면 한두 개 차이는 우연일 수 있습니다. 작은 차이로 결론을 내리지 않고, 틀린 질문을 하나하나 읽어 봅니다.