11장. 폐쇄망 문서 파이프라인과 폐쇄형 RAG
실습 5 — 인덱스의 속도와 정확도 재기
벡터가 많아지면 인덱스를 무엇으로 고르느냐가 속도를 가릅니다. 연습용 벡터 10만 개(384차원)를 만들어 Flat, IVF, HNSW 의 검색 시간과 재현율을 잽니다. 벡터는 실제 임베딩처럼 적은 수의 숨은 방향에서 만들어지도록 지어낸 것입니다. 시간은 PC 마다 다릅니다.
1단계. 연습용 벡터 10만 개 만들기
import time
import numpy as np
import pandas as pd
import faiss
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = "Malgun Gothic"            # 그래프의 한글 글꼴
plt.rcParams["axes.unicode_minus"] = False

rng = np.random.default_rng(42)
N, d = 100_000, 384
# 32개의 숨은 방향을 섞어 384차원으로 펼치고 잡음을 조금 더한다(실제 임베딩처럼 구조가 있는 벡터)
X = rng.normal(size=(N, 32)).astype("float32") @ rng.normal(size=(32, d)).astype("float32")
X += 0.05 * np.sqrt(32) * rng.normal(size=(N, d)).astype("float32")
X /= np.linalg.norm(X, axis=1, keepdims=True)           # 길이를 1 로 맞춘다
# 질문 200개: 들어 있는 벡터를 조금 흔든 것
Q = X[rng.choice(N, 200, replace=False)] + 0.02 * rng.normal(size=(200, d)).astype("float32")
Q = (Q / np.linalg.norm(Q, axis=1, keepdims=True)).astype("float32")
print(X.shape, Q.shape, f"{X.nbytes / 1e6:.0f}MB")(100000, 384) (200, 384) 154MB2단계. Flat 으로 정답 만들기
flat = faiss.IndexFlatIP(d)
flat.add(X)
t = time.time()
_, truth = flat.search(Q, 10)                            # 모두 견준 결과가 "정확한 상위 10개"
flat_ms = (time.time() - t) / len(Q) * 1000


def recall(found):
    """정확한 상위 10개 가운데 몇 개를 찾았나(질문마다 잰 뒤 평균)"""
    return np.mean([len(set(a) & set(b)) / 10 for a, b in zip(truth, found)])


rows = [{"인덱스": "Flat", "손잡이": "-", "만들기(초)": 0.0, "질문당(ms)": flat_ms, "재현율": 1.0}]
print(f"Flat: 질문 하나에 {flat_ms:.2f}ms")Flat: 질문 하나에 4.48ms3단계. IVF 와 HNSW 재기
# IVF: 칸 256개로 나누고, 볼 칸 수(nprobe)를 바꿔 가며 잰다
t = time.time()
ivf = faiss.IndexIVFFlat(faiss.IndexFlatIP(d), d, 256, faiss.METRIC_INNER_PRODUCT)
ivf.train(X)                                             # 칸을 나누는 기준을 배운다
ivf.add(X)
build = time.time() - t
for nprobe in (1, 8, 32, 64):
    ivf.nprobe = nprobe
    t = time.time()
    _, found = ivf.search(Q, 10)
    rows.append({"인덱스": "IVF", "손잡이": f"nprobe {nprobe}", "만들기(초)": build,
                 "질문당(ms)": (time.time() - t) / len(Q) * 1000, "재현율": recall(found)})

# HNSW: 이웃 32개씩 잇는 그물을 만들고, 살펴볼 후보 수(efSearch)를 바꿔 가며 잰다
t = time.time()
hnsw = faiss.IndexHNSWFlat(d, 32)                        # 길이 1 인 벡터라 거리(L2) 순서가 내적 순서와 같다
hnsw.add(X)
build = time.time() - t
for ef in (16, 64, 128):
    hnsw.hnsw.efSearch = ef
    t = time.time()
    _, found = hnsw.search(Q, 10)
    rows.append({"인덱스": "HNSW", "손잡이": f"efSearch {ef}", "만들기(초)": build,
                 "질문당(ms)": (time.time() - t) / len(Q) * 1000, "재현율": recall(found)})

result = pd.DataFrame(rows).round({"만들기(초)": 1, "질문당(ms)": 3, "재현율": 3})
print(result.to_string(index=False)) 인덱스 손잡이 만들기(초) 질문당(ms) 재현율
Flat - 0.0 4.484 1.000
IVF nprobe 1 2.1 0.033 0.223
IVF nprobe 8 2.1 0.211 0.572
IVF nprobe 32 2.1 0.787 0.872
IVF nprobe 64 2.1 1.507 0.958
HNSW efSearch 16 18.7 0.079 0.931
HNSW efSearch 64 18.7 0.239 0.973
HNSW efSearch 128 18.7 0.432 0.9964단계. 그래프로 보기
for name, g in result.groupby("인덱스", sort=False):
    plt.plot(g["질문당(ms)"], g["재현율"], "o-", label=name)       # 손잡이를 올릴수록 오른쪽 위로 간다
plt.xscale("log")
plt.gca().xaxis.set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}"))
plt.xlabel("질문 하나의 검색 시간(ms, 로그 눈금)")
plt.ylabel("재현율(상위 10개)")
plt.title("벡터 10만 개에서 인덱스별 속도와 정확도")
plt.legend()
plt.grid(alpha=0.3)
plt.show()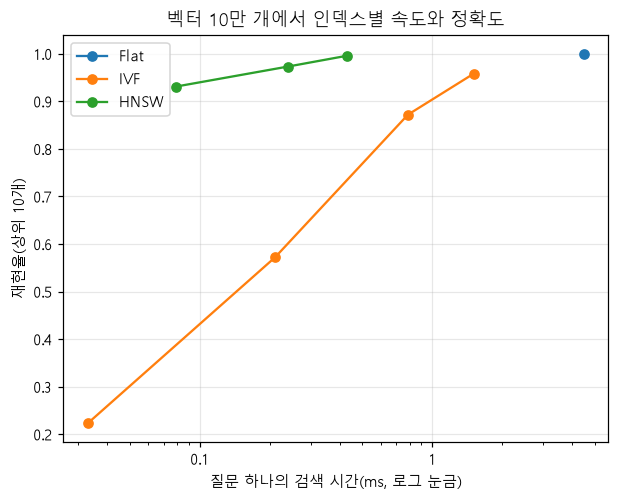
이 실습이 뜻하는 것
이 실습은 도서관에서 책을 찾는 세 가지 방법을 견주는 일과 같습니다. 책 10만 권과 찾을 책 200권의 목록을 만들고(1단계), 먼저 서가를 처음부터 끝까지 다 훑어 정답을 정하고(2단계), 서가를 256칸으로 나눠 가까운 칸 몇 개만 보는 방법과 비슷한 책끼리 이어 둔 안내 줄을 따라가는 방법을 손잡이를 바꿔 가며 재고(3단계), 그래프로 그립니다(4단계). 여기서 다 훑기가 Flat, 칸 나누기가 IVF(Inverted File Index, 칸마다 든 벡터 목록을 적어 두는 색인), 안내 줄 따라가기가 HNSW(Hierarchical Navigable Small World, 층층이 이은 이웃 그물)이고, 정답 10권 가운데 몇 권을 찾았는지가 재현율입니다. 비유와 다른 점은, 여기서 책은 실제 문서가 아니라 연습용으로 지어낸 숫자 벡터라는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 벡터 | (100000, 384) (200, 384) 154MB | 숫자 384개로 된 벡터 10만 개와 질문 200개를 만들었습니다. 벡터만으로 메모리 154MB 를 차지합니다 |
| 2. Flat | Flat: 질문 하나에 4.48ms | 10만 개를 모두 견주면 질문 하나에 4.5ms(1,000분의 4.5초)쯤 걸립니다. 이 결과를 정답으로 삼습니다 |
| 3. IVF nprobe 1 | 0.033ms, 재현율 0.223 | 한 칸만 보니 Flat 보다 130배쯤 빠르지만, 정답 10개 가운데 2개쯤만 찾습니다 |
| 3. IVF nprobe 64 | 1.507ms, 재현율 0.958 | 64칸을 보면 거의 다 찾지만 시간이 Flat 의 3분의 1쯤으로 늘었습니다 |
| 3. HNSW efSearch 16 | 0.079ms, 재현율 0.931 | 아주 빠른데도 정답의 93%를 찾습니다 |
| 3. HNSW efSearch 128 | 0.432ms, 재현율 0.996 | 거의 모두 찾으면서도 Flat 보다 10배 넘게 빠릅니다 |
| 3. 만들기 시간 | IVF 2.1초, HNSW 18.7초 | HNSW 는 그물을 만드는 데 IVF 의 9배쯤 시간이 듭니다 |
| 4. 그래프 | 인덱스별 검색 시간과 재현율 | 왼쪽 위에 있을수록 빠르고 정확합니다. 초록 선(HNSW)이 주황 선(IVF)보다 왼쪽 위에 있습니다 |
한 줄로 줄이면, 벡터가 많을 때는 "얼마나 빨리"와 "얼마나 빠짐없이"를 맞바꾸는 손잡이가 있고, 이 데이터에서는 HNSW 가 같은 시간에 더 정확했다는 실습입니다. 시간은 이 PC 에서 잰 값이라 PC 마다, 실행마다 달라집니다. 벡터도 지어낸 것이라 실제 문서 임베딩에서 같은 숫자가 나온다는 뜻은 아닙니다. 이 장의 사내 문서처럼 조각이 수십 개면 Flat 으로 충분합니다.
코드 설명
- Flat 은 질문 하나에 4.5ms 쯤 걸렸고 재현율은 정의대로 1 입니다. 10만 개를 모두 견주는 시간이므로, 벡터가 10배가 되면 시간도 거의 10배가 됩니다.
- IVF 는 nprobe 1 에서 0.033ms 로 Flat 보다 100배 넘게 빠르지만 재현율이 0.223 입니다. nprobe 를 64 로 올리면 재현율이 0.958 까지 오르는 대신 1.5ms 로 느려집니다. 256칸 가운데 볼 칸이 늘수록 Flat 에 가까워집니다.
- HNSW 는 efSearch 16 에서 0.08ms 에 재현율 0.931, 128 에서 0.43ms 에 0.996 입니다. 같은 시간이면 IVF 보다 훨씬 정확합니다. 대신 그물을 만드는 데 18.7초가 걸려 IVF(2.1초)의 아홉 배쯤입니다. 그래프에서 초록 선(HNSW)이 주황 선(IVF)보다 왼쪽 위에 있는 것이 이 차이입니다.
- 시간은 이 PC 에서 잰 것이라 PC 마다 다르고 다시 돌려도 조금씩 달라집니다(먼저 돌렸을 때 Flat 은 5.07ms). 재현율은 씨앗이 같으면 같습니다. 이 장의 사내 문서처럼 조각이 수십 개면 어느 인덱스든 차이가 없으므로 Flat 이면 됩니다. 벡터가 수십만 개를 넘고 자주 다시 만들지 않으면 HNSW, 자주 다시 만들거나 메모리를 아껴야 하면 IVF 를 우리 데이터로 재어 봅니다.