21장. AI 거버넌스와 보안, 온프레미스 인프라
실습 6 — GPU 메모리 셈하기
Qwen2.5 계열 일곱 크기(0.5B~72B)의 공개 설정값으로 가중치와 KV 캐시에 드는 GPU 메모리를 셈하고, 이 PC 의 Ollama 가 실제로 쓰는 메모리와 견줍니다. 동시 사용자 수에 따라 어느 GPU 가 맞는지 표와 그래프로 봅니다. 설정값은 Hugging Face 에 공개된 각 모델의 config.json 에서 교안을 만들 때 확인한 값이고, 파라미터 수는 모델 카드의 값입니다.
1단계. 모델 설정과 가중치 메모리
import matplotlib.pyplot as plt
import pandas as pd

plt.rcParams["font.family"] = "Malgun Gothic"        # 한글 글꼴(4단계의 그래프)
plt.rcParams["axes.unicode_minus"] = False

# 크기: (파라미터 수(십억), 층 수, KV 헤드 수, 헤드 크기)
MODELS = {"0.5B": (0.49, 24, 2, 64), "1.5B": (1.54, 28, 2, 128), "3B": (3.09, 36, 2, 128), "7B": (7.61, 28, 4, 128),
          "14B": (14.7, 48, 8, 128), "32B": (32.5, 64, 8, 128), "72B": (72.7, 80, 8, 128)}


def weights_gb(params_b, bits):
    return params_b * bits / 8                 # 십억 × 비트 ÷ 8 = GB


# Ollama 의 Q4_K_M 은 가중치마다 평균 5비트쯤 쓴다(3B 파일 1.93GB ÷ 30.9억 파라미터, 3단계에서 확인)
table = pd.DataFrame({bits_name: {m: weights_gb(v[0], bits) for m, v in MODELS.items()}
                      for bits_name, bits in [("fp16", 16), ("8비트", 8), ("4비트(Q4_K_M)", 5)]})
# 결과: 크기와 정밀도마다 가중치가 차지하는 메모리(GB)
print(table.round(1)) fp16 8비트 4비트(Q4_K_M)
0.5B 1.0 0.5 0.3
1.5B 3.1 1.5 1.0
3B 6.2 3.1 1.9
7B 15.2 7.6 4.8
14B 29.4 14.7 9.2
32B 65.0 32.5 20.3
72B 145.4 72.7 45.42단계. KV 캐시와 동시 사용자
def kv_gb(layers, kv_heads, head_dim, tokens, users, bytes_=2):
    return 2 * layers * kv_heads * head_dim * bytes_ * tokens * users / 1e9


rows = []
for m, (p, layers, kvh, hd) in MODELS.items():
    per_token_kb = 2 * layers * kvh * hd * 2 / 1e3
    rows.append({"모델": m, "토큰 하나 KB": round(per_token_kb, 1),
                 **{f"{u}명×4,096": kv_gb(layers, kvh, hd, 4096, u) for u in [1, 8, 32]}})
kv = pd.DataFrame(rows).set_index("모델")
# 결과: 문맥 4,096 토큰을 동시에 몇 명이 쓰느냐에 따른 KV 캐시(GB, fp16)
print(kv.round(2)) 토큰 하나 KB 1명×4,096 8명×4,096 32명×4,096
모델
0.5B 12.3 0.05 0.40 1.61
1.5B 28.7 0.12 0.94 3.76
3B 36.9 0.15 1.21 4.83
7B 57.3 0.23 1.88 7.52
14B 196.6 0.81 6.44 25.77
32B 262.1 1.07 8.59 34.36
72B 327.7 1.34 10.74 42.953단계. 이 PC 에서 재어 보기
import json
import urllib.request

import torch


def get(path):
    with urllib.request.urlopen("http://127.0.0.1:11434" + path, timeout=30) as r:
        return json.loads(r.read())


# 모델을 올려 둔다(문맥 4,096 토큰). 올라간 뒤 /api/ps 가 GPU 에 올린 크기를 알려 준다
req = urllib.request.Request("http://127.0.0.1:11434/api/generate", data=json.dumps(
    {"model": "qwen2.5:3b", "prompt": "안녕", "stream": False, "options": {"num_predict": 1, "num_ctx": 4096}}).encode(),
    headers={"Content-Type": "application/json"})
urllib.request.urlopen(req, timeout=120).read()
file_size = next(m["size"] for m in get("/api/tags")["models"] if m["name"] == "qwen2.5:3b")
loaded = next(m for m in get("/api/ps")["models"] if m["name"] == "qwen2.5:3b")
p, layers, kvh, hd = MODELS["3B"]
estimate = file_size / 1e9 + kv_gb(layers, kvh, hd, 4096, 1)
print(f"파일 {file_size / 1e9:.2f}GB → 가중치 하나에 {file_size * 8 / (p * 1e9):.2f}비트")
print(f"셈: 파일 + KV(4,096토큰) = {estimate:.2f}GB · Ollama 가 GPU 에 올린 크기 {loaded['size_vram'] / 1e9:.2f}GB")
# 결과: 이 PC 의 GPU 와 전체 메모리
props = torch.cuda.get_device_properties(0)
print(f"{props.name} · {props.total_memory / 1e9:.1f}GB")파일 1.93GB → 가중치 하나에 5.00비트
셈: 파일 + KV(4,096토큰) = 2.08GB · Ollama 가 GPU 에 올린 크기 2.16GB
NVIDIA GeForce GTX 1650 · 4.3GBOllama 의 qwen2.5:3b 파일은 가중치 하나에 5.00비트를 씁니다. 파일 크기에 문맥 4,096 토큰의 KV 캐시를 더한 셈은 2.08GB 였고, Ollama 가 GPU 에 실제로 올린 크기는 2.16GB 였습니다. 남은 0.08GB 는 계산에 쓰는 임시 메모리로 보입니다. 셈법이 실제와 4% 안쪽으로 맞으므로, 4단계에서는 여유를 20% 두고 GPU 를 고릅니다.
4단계. 어떤 GPU 가 맞나
GPUS = {"GTX 1650": 4, "RTX 4090": 24, "L40S": 48, "A100·H100": 80}
need = pd.DataFrame({m: {"4비트, 1명": weights_gb(v[0], 5) + kv_gb(*v[1:], 4096, 1),
                         "4비트, 8명": weights_gb(v[0], 5) + kv_gb(*v[1:], 4096, 8),
                         "fp16, 8명": weights_gb(v[0], 16) + kv_gb(*v[1:], 4096, 8)} for m, v in MODELS.items()}).T
need = need * 1.2                              # 계산 여유 20%
print(need.round(1))
# 결과: 경우마다 한 장에 들어가는 가장 작은 GPU
print(need.apply(lambda col: col.map(lambda g: next((n for n, c in GPUS.items() if g <= c), "여러 장"))))

ax = need.plot(kind="bar", logy=True, figsize=(9, 4), rot=0)
for name, cap in GPUS.items():
    ax.axhline(cap, linestyle="--", color="gray", linewidth=0.8)
    ax.text(6.6, cap, name, va="bottom", ha="right", fontsize=8)
ax.yaxis.set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}"))
ax.set_ylabel("필요한 GPU 메모리(GB, 로그 눈금)")
ax.set_title("모델 크기와 사용자 수에 따른 GPU 메모리")
plt.tight_layout()
plt.show() 4비트, 1명 4비트, 8명 fp16, 8명
0.5B 0.4 0.9 1.7
1.5B 1.3 2.3 4.8
3B 2.5 3.8 8.9
7B 6.0 8.0 20.5
14B 12.0 18.8 43.0
32B 25.7 34.7 88.3
72B 56.1 67.4 187.4
4비트, 1명 4비트, 8명 fp16, 8명
0.5B GTX 1650 GTX 1650 GTX 1650
1.5B GTX 1650 GTX 1650 RTX 4090
3B GTX 1650 GTX 1650 RTX 4090
7B RTX 4090 RTX 4090 RTX 4090
14B RTX 4090 RTX 4090 L40S
32B L40S L40S 여러 장
72B A100·H100 A100·H100 여러 장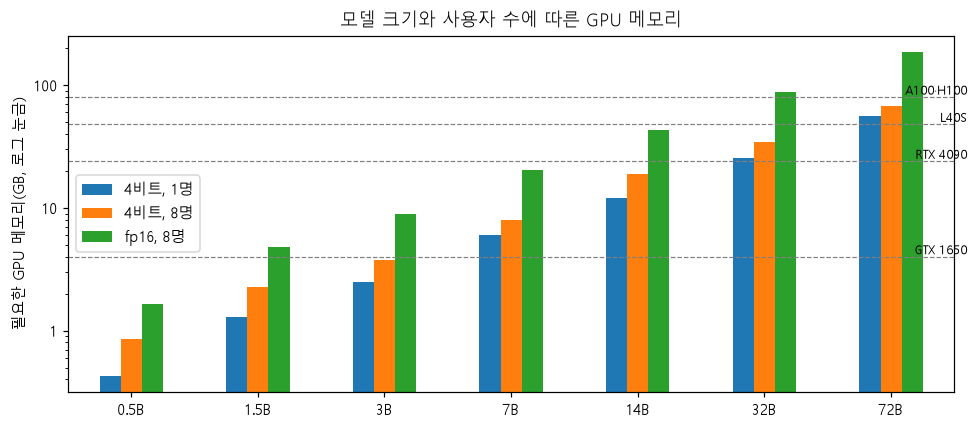
이 실습이 뜻하는 것
이 실습은 이삿짐에 맞는 트럭을 고르는 일과 같습니다. 가구의 부피를 재고(1단계), 손님마다 따로 싣는 짐 상자의 부피를 더하고(2단계), 실제 트럭에 실어 셈이 맞는지 보고(3단계), 여유를 두고 트럭을 고릅니다(4단계). 여기서 가구가 모델의 가중치, 손님마다의 짐 상자가 사용자마다의 KV 캐시(Key-Value cache, 앞의 글을 다시 계산하지 않으려고 기억해 두는 값), 트럭이 GPU(Graphics Processing Unit, 그래픽 처리 장치)의 메모리, 압축 포장이 4비트 양자화입니다. 비유와 다른 점은, 이삿짐 상자는 크기가 미리 정해지지만 KV 캐시는 대화가 길어질수록 커진다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 가중치 | 3B fp16 6.2, 4비트 1.9 | 단위는 GB(기가바이트)입니다. fp16(16비트 부동소수점)으로 적으면 6.2GB 인 모델이 4비트로는 3분의 1 아래로 줄어듭니다 |
| 1. 가장 큰 모델 | 72B fp16 145.4 | 가중치만으로 이 PC 의 GPU(4.3GB)의 30배가 넘습니다 |
| 2. KV 캐시 | 3B 토큰 하나 36.9KB, 32명×4,096 4.83GB | 대화를 기억하는 메모리도 사용자 수에 비례해 늘어, 32명이면 4비트 가중치(1.9GB)보다 커집니다 |
| 2. 14B 의 KV | 토큰 하나 196.6KB | 7B(57.3KB)의 3배가 넘습니다. 층과 KV 헤드가 더 많기 때문입니다 |
| 3. 파일 | 파일 1.93GB → 가중치 하나에 5.00비트 | 4비트 양자화라고 해도 실제 파일은 가중치 하나에 평균 5비트를 씁니다 |
| 3. 셈과 실제 | 셈 2.08GB, 실제 2.16GB | 셈이 실제와 0.08GB(4% 안쪽) 차이로 맞았습니다. 이 셈법을 믿고 써도 된다는 확인입니다 |
| 3. 이 PC | NVIDIA GeForce GTX 1650 · 4.3GB | 이 PC 의 GPU 와 메모리입니다 |
| 4. 필요한 메모리 | 3B 4비트 8명 3.8, fp16 8명 8.9 | 여유 20% 를 더한 값입니다. 같은 3B 라도 fp16 으로 8명이 쓰면 이 PC 에 들어가지 않습니다 |
| 4. GPU 고르기 | 7B 는 세 경우 모두 RTX 4090, 32B·72B 의 fp16 8명은 여러 장 | 모델이 크고, 정밀도가 높고, 사용자가 많을수록 더 큰 GPU 나 여러 장이 필요합니다 |
| 4. 그래프 | 막대와 회색 점선 | 막대가 점선(GPU 의 메모리)보다 낮으면 그 GPU 한 장에 들어갑니다. 세로축은 로그 눈금이라 칸이 오를 때마다 몇 배씩 커집니다 |
한 줄로 줄이면, GPU 메모리는 "가중치 + 사용자 수만큼의 KV 캐시 + 여유"로 셈할 수 있고, 그 셈이 이 PC 에서 4% 안쪽으로 맞았다는 실습입니다. 이 셈은 프로젝트의 용량 점검(3B 4비트, 동시 4명)에 그대로 쓰입니다. 다만 셈을 실제와 맞춰 본 것은 3B 하나이고, 셈은 메모리에 들어가는지만 알려 줍니다. 들어간다고 응답이 충분히 빠르다는 뜻은 아니므로, 속도는 16장처럼 따로 재야 합니다.
코드 설명
weights_gb(파라미터 수, 비트)는 파라미터 수(십억)에 비트를 곱하고 8 로 나눠 GB 를 냅니다. 4비트 양자화(15장)는 fp16 의 4분의 1쯤입니다.kv_gb()는 토큰 하나마다 층마다 K 와 V 를 하나씩 담는 크기에 토큰 수와 사용자 수를 곱합니다. KV 헤드가 적은 모델(GQA)은 KV 캐시가 작습니다.- 3단계의
/api/ps의size_vram은 Ollama 가 GPU 에 올린 크기입니다. 셈과 잰 값을 견줘 셈법을 확인합니다. - 4단계는 셈한 값에 20% 의 여유를 더한 뒤, 한 장에 들어가는 가장 작은 GPU 를 고릅니다. 넘으면 여러 장에 나눠 올리는(텐서 병렬) 구성이 필요합니다.