4장. LLM 을 완성하는 3단계와 Hugging Face
GPU 메모리 어림하기
이삿짐 트럭을 부를 때 짐의 양부터 어림합니다. 모델을 GPU 에 올릴 때도 같습니다. "파라미터 수 × 한 개에 드는 바이트"로 대략의 크기를 미리 셈하면, 트럭(GPU)이 모자라 실패하는 일을 줄일 수 있습니다.
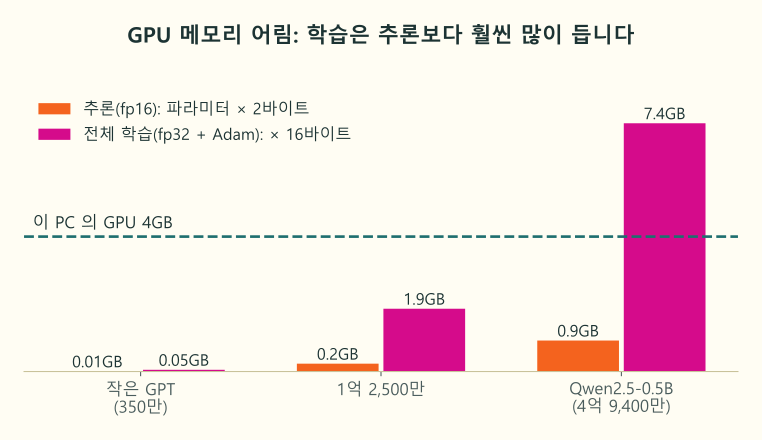
다홍 막대가 추론(fp16), 마젠타 막대가 전체 학습(fp32 와 Adam)에 드는 어림값이고, 청록 점선이 이 PC 의 GPU 4GB 입니다. Qwen2.5-0.5B 는 추론에 0.9GB 면 되지만 전체 학습에는 7.4GB 가 들어 4GB 에 들어가지 않습니다. 실제로는 여기에 계산 중간값(활성화)이 더 붙습니다. 여기서 이삿짐이 파라미터, 트럭이 GPU 메모리입니다.
한 개에 드는 바이트
| 쓰임 | 파라미터 하나에 | 까닭 |
|---|---|---|
| 추론, float32 | 4바이트 | 32비트 숫자 |
| 추론, float16 | 2바이트 | 16비트 숫자 |
| 전체 학습, float32 + Adam | 16바이트쯤 | 가중치 4 + 기울기 4 + Adam 의 기억 두 개 8 |
def gpu_gb(params, bytes_per_param):
    """파라미터 수 × 바이트를 GB 로 바꾼다(1GB = 1024³ 바이트)."""
    return params * bytes_per_param / 1024 ** 3

for name, n in [("작은 GPT", 3.5e6), ("Qwen2.5-0.5B", 494e6), ("7B 모델", 7e9)]:
    print(f"{name}: 추론 fp16 {gpu_gb(n, 2):.2f}GB, 전체 학습 {gpu_gb(n, 16):.1f}GB")
7B 모델은 추론에만 13.04GB, 전체 학습에는 104.3GB 가 듭니다. 이 PC 의 4GB GPU 로는 0.5B 모델의 전체 학습도 어렵고, 7B 는 추론도 어렵습니다. 그래서 5장의 LoRA(일부만 학습)와 15장의 양자화(숫자를 더 작게)가 필요합니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
def gpu_gb(params, bytes_per_param) | 파라미터 수와 하나에 드는 바이트를 받아 GB 로 바꾸는 함수를 만든다 |
1024 ** 3 | 1024 를 세 번 곱한 수다. 바이트 → KB → MB → GB 로 1024 씩 세 번 나눈다 |
3.5e6, 494e6, 7e9 | 350만, 4억 9,400만, 70억을 짧게 적은 꼴이다. e6 은 10의 6제곱, e9 는 10의 9제곱이다 |
f"{값:.2f}" | 소수 둘째 자리까지 찍는다. .1f 는 첫째 자리까지다 |
이 코드가 뜻하는 것
이삿짐 상자 수에 상자 하나의 부피를 곱해 트럭 크기를 정하는 셈과 같습니다. 파라미터 수가 상자 수, 하나에 드는 바이트가 상자 부피입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
params * bytes_per_param / 1024 ** 3 | 전체 바이트를 구해 GB 로 바꾼다 | 상자 수 × 부피를 트럭 단위로 바꾼다 |
for name, n in [...] | 작은 GPT, Qwen2.5-0.5B, 7B 모델을 차례로 셈한다 | 원룸, 투룸, 큰 집의 이삿짐 |
gpu_gb(n, 2) | 추론(fp16)에 드는 크기 | 짐만 옮길 때 |
gpu_gb(n, 16) | 전체 학습(float32 와 Adam)에 드는 크기 | 짐에 포장재와 예비 상자까지 실을 때 |
같은 모델이라도 학습은 추론보다 8배(16 ÷ 2) 큰 트럭이 필요합니다. 학습할 때는 가중치 말고도 기울기와 Adam 의 기억을 함께 GPU 에 올려 두기 때문입니다.
작게 줄여서 눈으로 보기
"float32 는 4바이트, float16 은 2바이트"를 PyTorch 로 직접 재 보고, 작은 층 하나의 메모리를 셈해 봅니다. fp16 은 16-bit floating point(16비트 부동소수점)의 줄임말입니다.
import torch

# 같은 숫자 하나가 차지하는 바이트를 dtype 별로 잰다
for dtype in [torch.float32, torch.float16]:
    print(dtype, torch.zeros(1, dtype=dtype).element_size(), "바이트")

layer = torch.nn.Linear(1000, 1000)             # 1000 × 1000 가중치 + 1000 편향
n = sum(p.numel() for p in layer.parameters())
print(f"파라미터 수: {n:,}")
print(f"float32: {n * 4 / 1024**2:.2f}MB, float16: {n * 2 / 1024**2:.2f}MB, 학습(16바이트): {n * 16 / 1024**2:.2f}MB")torch.float32 4 바이트
torch.float16 2 바이트
파라미터 수: 1,001,000
float32: 3.82MB, float16: 1.91MB, 학습(16바이트): 15.27MB| 결과 | 읽는 법 |
|---|---|
torch.float32 4 바이트 | 32비트 숫자 하나는 4바이트입니다(8비트가 1바이트) |
torch.float16 2 바이트 | 16비트 숫자 하나는 2바이트로 절반입니다 |
| 파라미터 수 | 가로 1,000 × 세로 1,000 가중치 100만 개에 편향 1,000개를 더해 1,001,000 개입니다 |
| 세 가지 MB | 같은 층이 float32 로 3.82MB, float16 으로 1.91MB, 전체 학습으로 15.27MB 입니다. 2배, 4배 관계가 표의 바이트 수와 같습니다 |
element_size() 는 텐서의 숫자 하나가 차지하는 바이트 수를 돌려주고, dtype 은 data type(자료형)의 줄임말입니다. 모델 전체의 메모리도 이렇게 층마다의 숫자 개수를 모두 더한 뒤 바이트를 곱한 것입니다.
주의할 점
- 이 계산은 어림입니다. 배치 크기와 글 길이가 클수록 활성화 메모리가 커지고, 라이브러리가 쓰는 여유분도 있습니다. 어림값의 1.2~1.5배를 잡아 둡니다.
- 메모리가 모자라면
CUDA out of memory가 납니다. 배치 크기부터 줄여 봅니다.