4장. LLM 을 완성하는 3단계와 Hugging Face
생성 설정
식당에서 메뉴를 고르는 방법을 떠올려 보세요. 늘 1등 인기 메뉴만 시키는 사람, 인기 3위 안에서 고르는 사람, 인기 순서로 더해 손님의 90% 가 시키는 메뉴들 안에서 고르는 사람이 있습니다. 언어모델이 다음 토큰을 고르는 방법도 이렇게 나뉩니다.
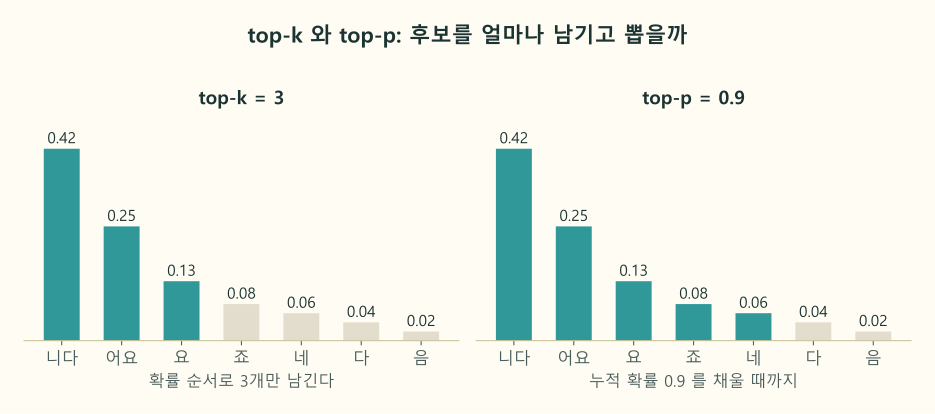
일곱 후보의 확률이 같을 때, 왼쪽 top-k = 3 은 확률 순서로 세 개(니다, 어요, 요)만 청록으로 남깁니다. 오른쪽 top-p = 0.9 는 확률을 더해 0.9 를 넘길 때까지인 다섯 개(니다부터 네까지)를 남깁니다. 회색 후보는 뽑히지 않습니다. 여기서 1등만 시키기가 탐욕적 선택, 3위 안에서가 top-k, 90% 안에서가 top-p 입니다.
생성 설정 모음
| 인자 | 하는 일 | 흔한 값 |
|---|---|---|
do_sample=False | 늘 1등 토큰(탐욕적 선택). 다시 돌려도 같은 답 | 정해진 답이 필요할 때 |
do_sample=True | 확률대로 뽑는다 | 대화, 글쓰기 |
temperature | 확률을 뾰족하게(작게) 또는 평평하게(크게) | 0.7 |
top_k | 위의 k 개 안에서만 | 50 |
top_p | 누적 확률 p 까지의 후보 안에서만 | 0.9 |
repetition_penalty | 이미 나온 토큰의 점수를 깎는다 | 1.1~1.3 |
max_new_tokens | 새로 만들 토큰 수의 한도 | 50~500 |
설정을 코드로 묶기
from transformers import GenerationConfig

# 자주 쓰는 설정을 이름 붙여 묶어 둘 수 있다
greedy = GenerationConfig(do_sample=False, max_new_tokens=50)
creative = GenerationConfig(do_sample=True, temperature=0.8, top_p=0.9, top_k=50,
                            repetition_penalty=1.2, max_new_tokens=50)
print(greedy.do_sample, creative.temperature, creative.top_p)
model.generate(**입력, generation_config=creative) 처럼 넘기면 묶어 둔 설정이 한꺼번에 적용됩니다. 실습 2에서 기본 모델에 여러 설정을 써 봅니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
GenerationConfig(...) | 글을 만들 때의 설정을 한 묶음으로 담는 객체다. 설정만 담을 뿐 모델은 필요 없어 내려받기도 없다 |
do_sample=False | 뽑기를 하지 않고 늘 1등 토큰을 고른다. sample 은 "표본을 뽑다"라는 뜻이다 |
temperature=0.8 | 온도다. 1보다 작으면 1등 쪽으로 더 쏠리고, 1보다 크면 고르게 퍼진다 |
top_p=0.9, top_k=50 | 뽑을 후보를 누적 확률 0.9 안쪽, 위에서 50개 안쪽으로 좁힌다 |
repetition_penalty=1.2 | 이미 나온 토큰의 점수를 1.2배만큼 불리하게 깎는다. 1.0 이면 벌점이 없다 |
max_new_tokens=50 | 새로 만들 토큰을 50개까지로 끊는다. 입력 토큰은 세지 않는다 |
이 코드가 뜻하는 것
커피 전문점의 "나만의 메뉴" 저장을 떠올려 보세요. 샷 추가, 시럽 반, 얼음 적게를 한 번 저장해 두면 다음부터는 이름만 말하면 됩니다. greedy 와 creative 가 그렇게 저장해 둔 두 메뉴입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
greedy = GenerationConfig(do_sample=False, ...) | 늘 1등만 고르는 설정을 묶는다 | "늘 먹던 걸로" 메뉴 |
creative = GenerationConfig(do_sample=True, ...) | 온도, top-p, top-k, 반복 벌점을 함께 쓰는 뽑기 설정을 묶는다 | "오늘은 조금 색다르게" 메뉴 |
print(greedy.do_sample, creative.temperature, creative.top_p) | 묶음 안의 값을 꺼내 본다 | 저장한 메뉴의 옵션을 확인한다 |
이 코드는 설정을 담아 두기만 하고 글은 만들지 않습니다. 실제 글은 모델의 generate 에 이 묶음을 넘길 때 만들어집니다.
작게 줄여서 눈으로 보기
top-k, top-p, 온도가 후보를 어떻게 바꾸는지 다섯 후보로 직접 계산해 봅니다. 확률은 설명용으로 정한 값이고, 그림의 확률과는 다릅니다.
import torch

words = ["니다", "어요", "요", "죠", "네"]
probs = torch.tensor([0.50, 0.25, 0.10, 0.08, 0.07])   # 설명용으로 정한 확률

# top-k = 3: 확률이 높은 3개만 남긴다
top3 = torch.topk(probs, k=3)
print("top-k 3  :", [words[i] for i in top3.indices])

# top-p = 0.9: 높은 순서로 더해 0.9 에 닿을 때까지 남긴다
cum = torch.cumsum(probs, dim=0)        # 누적 합
print("누적 합  :", [round(v, 2) for v in cum.tolist()])
keep = int((cum < 0.9).sum()) + 1       # 0.9 미만인 것 + 0.9 를 넘기는 첫 하나
print("top-p 0.9:", words[:keep])

# temperature: log 확률을 온도로 나눈 뒤 다시 softmax
for t in [0.5, 1.0, 2.0]:
    p = torch.softmax(torch.log(probs) / t, dim=0)
print(f"온도 {t} :", [round(v, 2) for v in p.tolist()])top-k 3 : ['니다', '어요', '요']
누적 합 : [0.5, 0.75, 0.85, 0.93, 1.0]
top-p 0.9: ['니다', '어요', '요', '죠']
온도 0.5 : [0.75, 0.19, 0.03, 0.02, 0.01]
온도 1.0 : [0.5, 0.25, 0.1, 0.08, 0.07]
온도 2.0 : [0.34, 0.24, 0.15, 0.14, 0.13]| 결과 | 읽는 법 |
|---|---|
| top-k 3 | 확률 순서로 위의 셋(니다, 어요, 요)만 남습니다. 나머지 둘은 뽑히지 않습니다 |
| 누적 합, top-p 0.9 | 더해 가면 0.5, 0.75, 0.85 까지는 0.9 에 못 미치고, 넷째 "죠"에서 0.93 으로 넘깁니다. 그래서 넷이 남고 "네"만 빠집니다 |
| 온도 0.5 | 1등 "니다"가 0.5 에서 0.75 로 커집니다. 한쪽으로 쏠려 늘 비슷한 답이 나옵니다 |
| 온도 1.0 | 원래 확률 그대로입니다 |
| 온도 2.0 | 1등이 0.34 로 줄고 꼴찌가 0.13 으로 커집니다. 고르게 퍼져 답이 다양해집니다 |
torch.topk 는 큰 값 k 개와 그 자리(indices)를, torch.cumsum 은 cumulative sum(누적 합)을 돌려줍니다. top-k 와 top-p 는 후보 수를 줄이고, 온도는 남은 후보 사이의 확률 차이를 키우거나 줄입니다. 실제 generate 는 남긴 후보의 확률을 다시 합이 1 이 되게 맞춘 뒤 뽑습니다.
주의할 점
temperature,top_k,top_p는do_sample=True일 때만 효과가 있습니다. 탐욕적 선택에서는 무시됩니다.- 기본 모델이 같은 말을 되풀이할 때 반복 벌점이 도움이 되지만, 너무 크게 주면 필요한 낱말까지 피해서 문장이 어색해집니다.