4장. LLM 을 완성하는 3단계와 Hugging Face
사전학습
도서관의 책을 처음부터 끝까지 다 읽는 사람을 떠올려 보세요. 무엇을 외우라고 시킨 사람은 없지만, 읽다 보면 말투, 문법, 상식이 쌓입니다. 사전학습이 이렇게 "다음 낱말 맞히기"만으로 엄청난 글을 읽히는 일입니다.
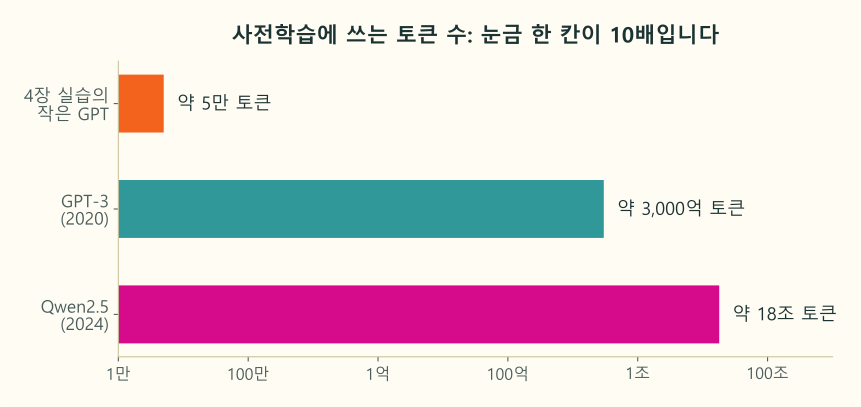
가로축은 눈금 한 칸이 10배인 로그 눈금입니다. 다홍 막대인 이 장 실습의 작은 GPT 는 약 5만 토큰으로 배우고, 청록 막대의 GPT-3(2020)는 약 3,000억 토큰, 마젠타 막대의 Qwen2.5(2024)는 약 18조 토큰으로 배웠습니다. 큰 두 모델의 숫자는 각 회사가 공개한 보고서의 값입니다. 여기서 도서관의 책이 사전학습 데이터입니다.
사전학습이 하는 일
3장의 미니 GPT 가 한 일이 사전학습입니다. 글을 토큰으로 바꾸고, 자리마다 다음 토큰을 정답으로 삼아 교차 엔트로피 손실을 줄여 나갑니다.
| 항목 | 3장 미니 GPT | 4장 실습 5 | 실제 LLM |
|---|---|---|---|
| 토크나이저 | 글자 단위, 직접 만듦 | BPE, 직접 학습 | BPE 등, 수만~수십만 어휘 |
| 모델 만들기 | 직접 쓴 클래스 | GPT2Config 로 설정만 | 수십억 파라미터 |
| 학습 | 직접 쓴 루프 | Trainer | 수천 개의 GPU 로 수 주 |
| 데이터 | 대화 8만 글자 | 쇼핑몰 글 약 5만 토큰 | 수조 토큰 |
라벨 없는 글이 정답이 되는 법
사전학습은 사람이 정답을 달지 않습니다. 글 자체를 한 칸 밀면 정답이 되기 때문입니다.
tokens = ["배송", "은", "결제", "후", "1~3일", "안에", "도착"]

# 입력은 마지막 토큰을 뺀 것, 정답은 첫 토큰을 뺀 것(한 칸 민 것)
inputs, targets = tokens[:-1], tokens[1:]
for x, y in zip(inputs, targets):
    print(f"{x:>5} 다음에는 → {y}")
토큰 일곱 개짜리 문장 하나에서 "배송 다음에는 은", "은 다음에는 결제"처럼 문제 여섯 개가 저절로 생깁니다. 글이 많을수록 문제도 많아집니다. Hugging Face 의 언어모델은 labels 에 입력과 같은 토큰을 주면 이 한 칸 밀기를 안에서 해 줍니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
tokens[:-1] | 목록에서 마지막 하나만 빼고 가져온다. 모델이 "보는" 쪽이다 |
tokens[1:] | 목록에서 첫 하나만 빼고 가져온다. 모델이 "맞혀야 하는" 쪽이다 |
zip(inputs, targets) | 두 목록을 같은 자리끼리 짝지어 하나씩 꺼낸다. 첫째는 ("배송", "은"), 둘째는 ("은", "결제") 꼴이다 |
f"{x:>5}" | 글을 다섯 칸 너비에 오른쪽으로 붙여 찍는다. 줄을 가지런히 맞추려는 것이라 계산과는 관계없다 |
이 코드가 뜻하는 것
받아쓰기 연습장을 떠올려 보세요. 문장을 한 낱말씩 가려 가며 "다음 낱말은 무엇일까"를 스스로 묻고 답을 확인합니다. 문제를 내 줄 선생님이 없어도 문장 자체가 문제와 답이 됩니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
tokens = [...] | 문장 하나를 토큰 일곱 개로 적는다 | 연습장에 적은 문장 |
inputs, targets = tokens[:-1], tokens[1:] | 같은 문장을 한 칸 어긋나게 두 줄로 만든다 | 윗줄은 읽은 낱말, 아랫줄은 그다음 낱말 |
for x, y in zip(...) | 같은 자리끼리 짝지어 문제를 하나씩 꺼낸다 | "배송 다음은?" → "은" 처럼 문제와 답을 맞춘다 |
토큰 일곱 개에서 문제 여섯 개가 나온 것은, 마지막 토큰 "도착" 뒤에는 맞힐 다음 토큰이 없기 때문입니다. 토큰이 N 개면 문제는 N-1 개입니다.
작게 줄여서 눈으로 보기
Hugging Face 의 언어모델에 labels 로 입력과 똑같은 번호를 주면, 모델 안에서 위의 한 칸 밀기가 일어납니다. 토큰 번호 다섯 개(설명용)로 그 모습을 흉내 내 봅니다.
# 한 문장의 토큰 번호(설명용)
input_ids = [5, 9, 7, 3, 8]
labels = input_ids                   # 사전학습: labels 에 입력을 그대로 준다

# 모델 안에서 일어나는 한 칸 밀기
seen = input_ids[:-1]                # 모델이 보는 쪽: 마지막 하나를 뺀다
answer = labels[1:]                  # 맞혀야 할 쪽: 첫 하나를 뺀다
print("labels 로 준 것:", labels)
print("보는 쪽        :", seen)
print("맞힐 쪽        :", answer)
print("문제 수 :", len(answer))labels 로 준 것: [5, 9, 7, 3, 8]
보는 쪽 : [5, 9, 7, 3]
맞힐 쪽 : [9, 7, 3, 8]
문제 수 : 4| 결과 | 읽는 법 |
|---|---|
| labels 로 준 것 | 입력과 똑같습니다. 우리가 정답을 따로 만들 필요가 없습니다 |
| 보는 쪽, 맞힐 쪽 | 위아래를 같은 자리끼리 읽으면 "5 다음은 9", "9 다음은 7"처럼 문제가 됩니다 |
| 문제 수 | 토큰 다섯 개에서 문제 네 개가 나옵니다. 실습 5의 DataCollatorForLanguageModeling 이 labels 에 입력을 그대로 복사해 주기만 하는 까닭이 이것입니다 |
주의할 점
- 사전학습 데이터에 틀린 내용이 있으면 모델도 그대로 배웁니다. 데이터의 품질과 저작권, 개인정보를 먼저 살핍니다.
- 작은 데이터로 사전학습하면 모델은 그 데이터의 문장을 거의 외웁니다. 실습 5의 작은 GPT 가 그렇습니다. 일반 지식을 갖추려면 실제 LLM 처럼 아주 많은 글이 필요합니다.