2장. 신경망과 딥러닝의 기본 원리
손실 함수
다트 게임을 떠올려 보세요. 화살이 과녁 한가운데에서 얼마나 떨어졌는지로 점수를 매깁니다. 신경망이 고쳐 나가려면 먼저 "지금 얼마나 틀렸나"를 숫자 하나로 알아야 합니다. 그 숫자를 내는 것이 손실 함수입니다.
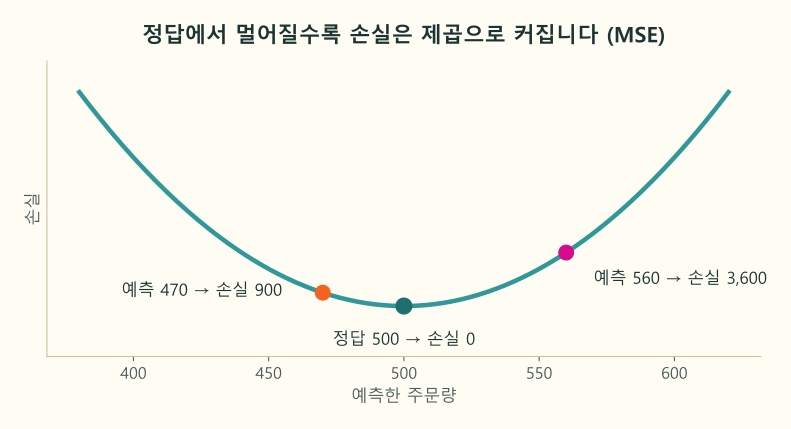
가로축은 예측한 주문량, 세로축은 손실입니다. 정답이 500 일 때, 30 빗나간 470 은 손실이 900 이고, 60 빗나간 560 은 손실이 3,600 입니다. 두 배 빗나가면 손실은 네 배가 됩니다. 여기서 과녁 한가운데가 정답, 화살이 예측, 떨어진 거리의 제곱이 손실입니다.
MSE 는 무엇의 약자인가
MSE 는 Mean Squared Error 의 약자로, 우리말로 평균 제곱 오차입니다. 1장의 MAE, RMSE 처럼 이름을 뒤에서부터 읽으면 계산 차례가 됩니다.
| 글자 | 영어 | 뜻 | 계산 차례 |
|---|---|---|---|
| E | Error | 오차(예측 − 정답) | 1. 건마다 빗나간 만큼을 구한다 |
| S | Squared | 제곱 | 2. 오차를 제곱해 부호를 없애고 큰 실수를 크게 만든다 |
| M | Mean | 평균 | 3. 제곱한 값을 모두 평균 낸다 |
1장의 RMSE(Root Mean Squared Error)에서 맨 앞의 R(Root, 제곱근)만 뺀 것이 MSE 입니다. 그래서 MSE 에 제곱근을 씌우면 RMSE 가 됩니다. 학습에는 제곱근을 씌우지 않은 MSE 를 쓰는데, 계산이 단순하고 기울기를 구하기 쉬워서입니다.
문제에 맞는 손실 함수
| 문제 | 손실 함수 | PyTorch | 출력층 |
|---|---|---|---|
| 회귀(주문량) | MSE: 오차 제곱의 평균 | nn.MSELoss() | 뉴런 1개, 활성화 없음 |
| 분류(숫자 0~9) | 교차 엔트로피 | nn.CrossEntropyLoss() | 뉴런 10개(답의 수), 활성화 없음 |
| 둘 중 하나(지연 여부) | 이진 교차 엔트로피 | nn.BCEWithLogitsLoss() | 뉴런 1개, 활성화 없음 |
분류의 출력층에 활성화 함수를 넣지 않는 까닭은, PyTorch 의 분류 손실 함수가 안쪽에서 확률로 바꾸는 계산까지 해 주기 때문입니다.
텐서는 무엇인가
아래 코드부터 PyTorch 의 텐서(tensor)를 씁니다. 달걀을 떠올려 보세요. 달걀 한 알이 있고, 여러 알을 한 줄로 늘어놓을 수 있고, 그 줄을 여러 개 모으면 달걀판 한 판이 되고, 판을 여러 장 쌓으면 상자가 됩니다. 텐서는 달걀 대신 숫자를 이렇게 담는 그릇입니다.
왼쪽부터 0차원, 1차원, 2차원, 3차원 텐서입니다. 차원이 하나 늘 때마다 앞 카드의 것을 여러 개 모읍니다. 카드 아래의 shape 는 차원마다 칸이 몇 개인지를 적은 것입니다. 3차원 카드는 8×8 그림 5장을 담는 모양인데, 그리기 좋게 판 세 장과 칸 여섯 개로 줄여 그렸습니다. 여기서 달걀 한 알이 숫자 하나, 달걀판의 줄과 칸이 표의 행과 열입니다. 비유와 다른 점은, 텐서의 칸에는 같은 종류의 숫자만 들어가고 줄마다 칸 수가 똑같아야 한다는 것입니다.
| 차원 | 이름 | 달걀로 치면 | 이 장에서 본 예 | shape |
|---|---|---|---|---|
| 0차원 | 스칼라(숫자 하나) | 한 알 | 손실 값 1,500 | () |
| 1차원 | 벡터(숫자 한 줄) | 한 줄 | 예측 세 건 [470, 560, 500] | (3,) |
| 2차원 | 행렬(행과 열의 표) | 한 판 | "순전파" 절의 주문 2건 × 특성 3개 | (2, 3) |
| 3차원 | 3차원 텐서 | 판을 쌓은 상자 | 8×8 흑백 그림 여러 장 | (장 수, 8, 8) |
이름이 따로 있어 보여도 모두 텐서입니다. 0차원부터 몇 차원이든 숫자를 담는 칸의 묶음을 통틀어 텐서라고 부릅니다. 신경망의 입력, 가중치, 출력, 손실이 모두 텐서입니다.
import torch

loss = torch.tensor(1500.0)                         # 0차원: 숫자 하나
pred = torch.tensor([470.0, 560.0, 500.0])          # 1차원: 숫자 한 줄
X = torch.tensor([[0.8, 1.0, 0.0],
                  [0.2, 0.0, 1.0]])                 # 2차원: 행과 열의 표
imgs = torch.zeros(5, 8, 8)                         # 3차원: 8×8 그림 5장(칸은 모두 0)

for name, t in [("loss", loss), ("pred", pred), ("X", X), ("imgs", imgs)]:
    # ndim 은 차원 수, shape 는 차원마다의 칸 수, numel() 은 모든 칸의 수
    print(name, t.ndim, tuple(t.shape), t.numel())
실행하면 loss 0 () 1, pred 1 (3,) 3, X 2 (2, 3) 6, imgs 3 (5, 8, 8) 320 이 나옵니다. 칸의 수는 shape 의 숫자를 모두 곱한 값입니다(5 × 8 × 8 = 320).
NumPy 배열도 같은 모양의 숫자를 담는데 굳이 텐서를 쓰는 까닭은 둘입니다.
| 텐서만 할 수 있는 일 | 쓰는 곳 |
|---|---|
| GPU 로 옮겨 빠르게 계산한다 | 뒤의 "PyTorch 와 GPU" 절 |
| 계산 과정을 기록해 기울기를 자동으로 구한다 | 뒤의 "학습률", "역전파와 자동 미분" 절의 requires_grad, backward() |
코드로 재기
1장의 MAE 는 "얼마나 틀렸나"를 사람이 읽는 지표였습니다. 손실은 모델이 줄여 나갈 목표입니다. 둘은 비슷하지만 쓰임이 다릅니다.
import torch
from torch import nn

pred = torch.tensor([470.0, 560.0, 500.0])   # 예측 세 건
true = torch.tensor([500.0, 500.0, 500.0])   # 정답 세 건

loss_fn = nn.MSELoss()        # 오차를 제곱해 평균 내는 손실
loss = loss_fn(pred, true)    # 넣는 순서는 (예측, 정답)
print(loss.item())            # .item() 은 텐서 안의 숫자 하나를 꺼낸다
오차가 -30, 60, 0 이라 제곱은 900, 3,600, 0 이고, 평균인 1,500 이 손실로 나옵니다.
코드에 나오는 torch
torch 는 PyTorch 라이브러리를 불러올 때 쓰는 이름입니다. PyTorch 는 신경망을 만들고 학습시키는 라이브러리로, NumPy 처럼 숫자 배열을 다루면서 신경망에 필요한 층, 손실 함수, 기울기 계산을 함께 줍니다. "딥러닝이란" 절의 도구 표에 나온 그 도구이고, 바로 위 "텐서는 무엇인가"의 코드부터 쓰기 시작했습니다.
| 코드 | 뜻 | NumPy 로 치면 |
|---|---|---|
import torch | PyTorch 를 불러온다 | import numpy as np |
torch.tensor([...]) | 텐서를 만든다(위 "텐서는 무엇인가"). 소수로 적어 실수 텐서로 만든다 | np.array([...]) |
from torch import nn | 신경망 부품 상자 nn(neural network)을 꺼낸다. 층과 손실 함수가 여기 들어 있다 | 없음 |
nn.MSELoss() | MSE 를 재는 손실 함수 객체를 만든다 | 없음 |
loss.item() | 텐서 안의 숫자 하나를 파이썬 숫자로 꺼낸다 | 값.item() |
print(loss) 로 바로 찍으면 tensor(1500.) 처럼 텐서 꼴로 나옵니다. .item() 을 붙이면 1500.0 이라는 보통 숫자가 되어 표에 적거나 비교하기 쉽습니다.
loss_fn 을 따로 만드는 까닭
체중계를 떠올려 보세요. 체중계는 한 번 사서 욕실에 두고, 잴 때마다 올라갑니다. 잴 때마다 새로 사지 않습니다. loss_fn = nn.MSELoss() 가 체중계를 사 두는 일이고, loss_fn(pred, true) 가 올라가서 재는 일입니다. 다만 손실 함수 객체는 만드는 데 거의 시간이 들지 않아서, "비싸서 한 번만 만든다"는 점은 비유와 다릅니다.
까닭의 바탕은 파이썬의 클래스와 객체입니다. nn.MSELoss 는 클래스이고, 괄호를 붙인 nn.MSELoss() 가 객체를 만듭니다. PyTorch 의 손실 함수와 층은 객체를 함수처럼 불러 쓰게 되어 있습니다. 그래서 변수 없이 nn.MSELoss()(pred, true) 라고 한 줄로 써도 결과는 같습니다. 그래도 변수에 담아 두는 까닭은 셋입니다.
| 까닭 | 설명 |
|---|---|
| 여러 번 부른다 | 학습할 때는 데이터 묶음마다 손실을 재므로 수백, 수천 번 부른다. 한 번 만들어 두고 계속 쓴다 |
| 설정은 만들 때 정한다 | nn.MSELoss(reduction="sum") 처럼 평균 대신 합을 낼지 같은 옵션은 객체를 만들 때 준다. 부를 때는 예측과 정답만 넣는다 |
| 바꾸기 쉽다 | 손실 함수를 바꿀 때 loss_fn = ... 한 줄만 고치면 되고, 학습 코드의 나머지는 그대로 둔다 |
import torch
from torch import nn

pred = torch.tensor([470.0, 560.0, 500.0])
true = torch.tensor([500.0, 500.0, 500.0])

print(type(nn.MSELoss), type(nn.MSELoss()))      # 클래스와, 그 클래스로 만든 객체
print(nn.MSELoss()(pred, true).item())          # 변수 없이 만들고 바로 불러도 같다
print(nn.MSELoss(reduction="sum")(pred, true).item())   # 옵션: 평균 대신 합
print(nn.L1Loss()(pred, true).item())           # 다른 손실 함수: 오차 크기의 평균(MAE)
실행하면 첫 줄은 <class 'type'> <class 'torch.nn.modules.loss.MSELoss'> 로, 앞의 것은 클래스이고 뒤의 것은 그 클래스로 만든 객체입니다. 이어서 1500.0(변수 없이 써도 같다), 4500.0(합으로 바꾼 값, 1,500 × 3), 30.0(MAE)이 나옵니다. PyTorch 에는 객체를 만들지 않는 함수 꼴 torch.nn.functional.mse_loss(pred, true) 도 있지만, 이 과정에서는 층과 같은 방식인 객체 꼴을 씁니다.
이 코드가 뜻하는 것
이 코드는 "예측 세 건이 정답에서 얼마나 빗나갔나"를 숫자 하나로 요약합니다.
| 줄 | 하는 일 | 다트로 치면 |
|---|---|---|
pred, true | 예측 세 건과 정답 세 건을 텐서로 만든다 | 던진 화살 세 개와 과녁 한가운데 |
loss_fn = nn.MSELoss() | 채점 방법을 정한다 | "떨어진 거리의 제곱"으로 채점하기로 한다 |
loss_fn(pred, true) | 세 건을 채점해 평균 낸다 | 세 화살의 점수를 평균 낸다 |
loss.item() | 결과를 숫자로 꺼낸다 | 점수판에 1,500 이라고 적는다 |
1,500 은 "틀린 정도"를 나타내는 숫자입니다. 단위가 주문량의 제곱이라 "1,500 건"처럼 읽지는 않습니다. 0 이면 세 건 모두 맞힌 것이고, 클수록 많이 틀린 것입니다. 손실 4,500(합) 가운데 3,600 이 60 빗나간 한 건에서 나왔습니다. 제곱 때문에 크게 빗나간 예측이 손실을 거의 다 차지하므로, 학습은 이런 큰 실수부터 줄이려고 합니다. 다음 절의 경사하강법이 이 숫자를 줄이는 쪽으로 가중치를 고치는 방법입니다.
주의할 점
- MSE 는 단위가 제곱이라 읽기 어렵습니다. 사람에게 보여 줄 때는 MAE 나 RMSE 로 바꿔 알립니다.
- 손실 함수에 넣는 순서는 (예측, 정답)입니다. 1장의 scikit-learn 지표(실제, 예측)와 순서가 반대이니 헷갈리지 않게 합니다.