2장. 신경망과 딥러닝의 기본 원리
경사하강법
짙은 안개가 낀 산에서 길을 잃었다고 해 봅시다. 앞이 보이지 않으니 산 아래가 어디인지 모릅니다. 할 수 있는 일은 발밑의 경사를 더듬어, 내리막 쪽으로 한 걸음 옮기는 것뿐입니다. 이것을 되풀이하면 결국 골짜기 바닥에 닿습니다. 신경망이 손실을 줄이는 방법이 이것입니다.
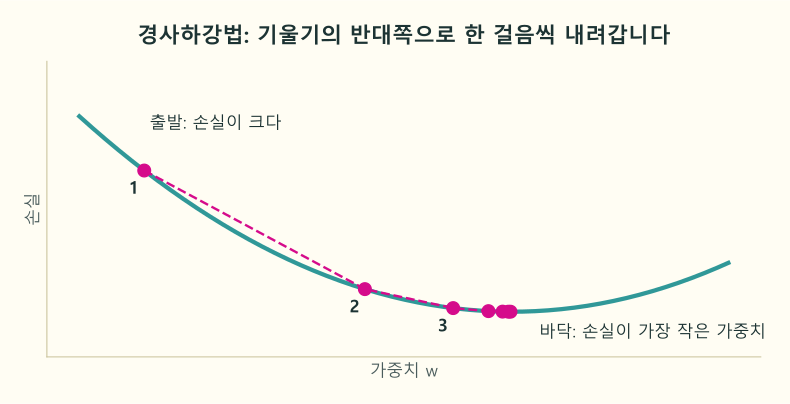
가로축은 가중치 하나, 세로축은 손실이고, 청록 곡선이 가중치에 따른 손실입니다. 마젠타 점이 1, 2, 3 의 순서로 내려가며 바닥에 가까워집니다. 바닥에 가까울수록 경사가 완만해서 걸음도 작아집니다. 여기서 발밑의 경사가 기울기, 한 걸음이 가중치 갱신, 골짜기 바닥이 손실이 가장 작은 가중치입니다.
이름의 유래와 뜻
영어 이름은 gradient descent 입니다. 우리말 이름은 이 영어를 낱말마다 옮긴 것이라, 낱말을 나눠 보면 뜻이 그대로 보입니다.
| 우리말 | 영어 | 뜻 |
|---|---|---|
| 경사 | gradient | 비탈의 기울기. 어느 쪽으로 얼마나 기울었나 |
| 하강 | descent | 내려가기 |
| 법 | (method) | 방법 |
이어 붙이면 "기울기를 보고 내려가는 방법"입니다. gradient 는 "걸음, 계단"을 뜻하는 라틴어 gradus 에서 나온 낱말로, 수학에서는 함수가 가장 가파르게 올라가는 방향과 그 가파름을 말합니다. 경사하강법은 그 반대쪽, 곧 가장 가파르게 내려가는 쪽으로 걷습니다. 그래서 영어로 steepest descent(가장 가파른 내려가기)라고도 부릅니다.
방법 자체는 신경망보다 훨씬 오래되었습니다. 프랑스의 수학자 코시(Augustin-Louis Cauchy)가 1847년에 방정식을 푸는 방법으로 내놓은 것이 처음으로 알려져 있습니다. 컴퓨터가 생긴 뒤 여러 분야에서 "값을 조금씩 고쳐 가장 낮은 곳을 찾는" 기본 방법으로 쓰였고, 신경망 학습도 이 방법 위에 서 있습니다. 뒤의 "학습률" 절에서 볼 옵티마이저 SGD 도 Stochastic Gradient Descent(확률적 경사하강법)의 약자입니다.
한 걸음의 식
| 기호 | 뜻 | 안개 산으로 치면 |
|---|---|---|
| w | 지금의 가중치 | 지금 선 자리 |
| 기울기 | 손실이 w 에 따라 바뀌는 정도 | 발밑의 경사 |
| 학습률 | 한 번에 고칠 크기 | 보폭 |
| 새 w = w - 학습률 × 기울기 | 경사의 반대쪽으로 옮긴다 | 내리막으로 한 걸음 |
기울기가 양수면 w 를 키울 때 손실이 커진다는 뜻이므로 w 를 줄입니다. 그래서 식에 빼기가 들어갑니다.
손으로 몇 걸음
손실이 (w - 3)² 인 아주 간단한 경우로 직접 걸어 봅니다. 바닥은 w = 3 입니다.
w = -0.4              # 출발점
lr = 0.3              # 학습률(보폭)

for step in range(1, 6):
    grad = 2 * (w - 3)          # (w - 3)² 의 기울기
    w = w - lr * grad           # 기울기 반대쪽으로 한 걸음
    print(step, round(w, 3), "손실", round((w - 3) ** 2, 3))
w 가 -0.4 에서 1.64, 2.456, 2.782, 2.913, 2.965 로 3 에 다가가고, 손실은 1.85 에서 0.001 까지 줄어듭니다. 그림과 같이 처음엔 크게, 바닥 근처에서는 작게 움직입니다.
이 코드가 뜻하는 것
손실 (w - 3)² 은 "정답이 3 인데 w 라고 예측했을 때의 제곱 오차"입니다. 앞 절의 MSE 를 주문 한 건, 가중치 하나로 줄인 모양입니다. 그래서 w 가 3 이면 손실이 0 이고, 3 에서 멀수록 커집니다. 코드는 이 w 를 정답 3 쪽으로 다섯 걸음 옮기는 학습을 아주 작게 흉내 낸 것입니다.
| 줄 | 하는 일 | 안개 산으로 치면 |
|---|---|---|
w = -0.4 | 아무 데서나 출발한다 | 산 중턱 아무 곳에 선다 |
lr = 0.3 | 한 번에 얼마나 움직일지 정한다 | 보폭을 정한다 |
grad = 2 * (w - 3) | 지금 자리의 기울기를 잰다 | 발밑의 경사를 더듬는다 |
w = w - lr * grad | 기울기 반대쪽으로 옮긴다 | 내리막으로 한 걸음 |
for step in range(1, 6) | 이것을 다섯 번 되풀이한다 | 다섯 걸음 걷는다 |
걸음마다 숫자를 풀어 보면 이렇습니다.
| 걸음 | 출발한 w | 기울기 | 옮긴 만큼(-0.3 × 기울기) | 새 w | 손실 |
|---|---|---|---|---|---|
| 1 | -0.4 | -6.8 | +2.04 | 1.64 | 1.85 |
| 2 | 1.64 | -2.72 | +0.816 | 2.456 | 0.296 |
| 3 | 2.456 | -1.088 | +0.326 | 2.782 | 0.047 |
| 4 | 2.782 | -0.435 | +0.131 | 2.913 | 0.008 |
| 5 | 2.913 | -0.174 | +0.052 | 2.965 | 0.001 |
표에서 세 가지를 읽을 수 있습니다.
- 기울기의 부호가 방향을 정합니다. w 가 3 보다 작은 동안 기울기는 음수입니다. 빼기에 음수를 넣으면 더하기가 되어 w 가 커집니다. 그래서 오른쪽(3 쪽)으로 갑니다. w 가 3 을 넘었다면 기울기가 양수가 되어 왼쪽으로 돌아옵니다.
- 기울기의 크기가 보폭을 정합니다. 멀리 있을 때는 기울기가 커서(-6.8) 한 번에 2.04 를 옮기고, 가까워지면 기울기가 작아져(-0.174) 0.052 만 옮깁니다. 학습률은 그대로인데 걸음이 저절로 줄어듭니다.
- 바닥에서는 멈춥니다. w 가 3 이면 기울기가 0 이라 더 움직이지 않습니다. 기울기 0 인 곳이 손실이 가장 작은 곳입니다.
기울기 2 × (w - 3) 은 어디서 왔나
기울기는 "w 를 아주 조금 바꿨을 때 손실이 얼마나 바뀌나"입니다. 미분 공식을 몰라도, w 를 0.001 만큼 옮겨 손실의 변화를 재 보면 같은 값이 나옵니다.
def loss(w):
    return (w - 3) ** 2

for w in [-0.4, 3.0, 4.0]:
    # w 를 0.001 옮겼을 때 손실이 바뀐 양 ÷ 0.001 = 기울기의 어림값
    slope = (loss(w + 0.001) - loss(w)) / 0.001
    print(w, round(slope, 3), 2 * (w - 3))
w 가 -0.4 일 때 어림값 -6.799 와 식 -6.8, 3 일 때 0.001 과 0, 4 일 때 2.001 과 2 로 거의 같습니다. 실제 신경망은 가중치가 수백 개를 넘어 이렇게 하나씩 잴 수 없으므로, 뒤의 "역전파와 자동 미분" 절에서 볼 자동 미분이 기울기를 한꺼번에 구해 줍니다.
주의할 점
- 실제 신경망에는 가중치가 수백 개에서 수십억 개 있습니다. 산의 방향이 그만큼 많은 셈이지만, 가중치마다 같은 식을 한꺼번에 적용할 뿐입니다.
- 안개 산처럼, 경사하강법이 닿은 곳이 가장 낮은 바닥이라는 보장은 없습니다. 그래도 신경망에서는 대개 충분히 좋은 곳에 닿습니다.