2장. 신경망과 딥러닝의 기본 원리
실습 3 — 주문량 데이터 준비하기
가상 쇼핑몰의 2년 치 하루 주문량 daily_orders.csv 를 읽어 살펴보고, 신경망에 넣을 수 있도록 나누고 크기를 맞춘 뒤 텐서로 바꿉니다. 연습용으로 만든 가상 데이터입니다. 실습 4부터 6까지 이 준비를 그대로 다시 씁니다.
1단계. 읽고 살펴보기
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

df = pd.read_csv("daily_orders.csv")
print(df.shape)
print(df.head(3))
# 주문량의 요약: 평균, 최솟값, 최댓값 등
print(df["주문량"].describe().round(1))(731, 8)
날짜 주말 공휴일 기온 강수mm 광고비만원 할인행사 주문량
0 2024-01-01 0 0 -1.8 0.0 86 0 233
1 2024-01-02 0 0 -1.4 0.0 89 1 303
2 2024-01-03 0 0 3.3 0.0 95 0 409
count 731.0
mean 506.1
std 102.5
min 181.0
25% 445.5
50% 521.0
75% 572.5
max 862.0
Name: 주문량, dtype: float64이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
plt.rcParams["font.family"] = "Malgun Gothic" | 그래프의 글꼴을 맑은 고딕으로 바꿔 한글이 깨지지 않게 한다 |
plt.rcParams["axes.unicode_minus"] = False | 눈금의 빼기 기호가 한글 글꼴에서 네모로 깨지지 않게 한다 |
pd.read_csv("daily_orders.csv") | csv 파일을 읽어 표(DataFrame)로 만든다 |
df.shape, df.head(3) | 표의 (행 수, 열 수)와 맨 앞 3줄 |
df["주문량"].describe() | 한 열의 요약: 개수(count), 평균(mean), 표준편차(std), 최솟값, 사분위수(25%, 50%, 75%), 최댓값 |
.round(1) | 소수 첫째 자리까지 반올림해 보기 좋게 한다 |
2단계. 특성과 주문량의 관계 그려 보기
# 기온과 광고비에 따라 주문량이 어떻게 달라지는지 점으로 찍어 본다
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].scatter(df["기온"], df["주문량"], s=8, alpha=0.5)
axes[0].set_title("기온과 주문량")
axes[0].set_xlabel("기온")
axes[1].scatter(df["광고비만원"], df["주문량"], s=8, alpha=0.5)
axes[1].set_title("광고비와 주문량")
axes[1].set_xlabel("광고비(만원)")
plt.tight_layout()
plt.show()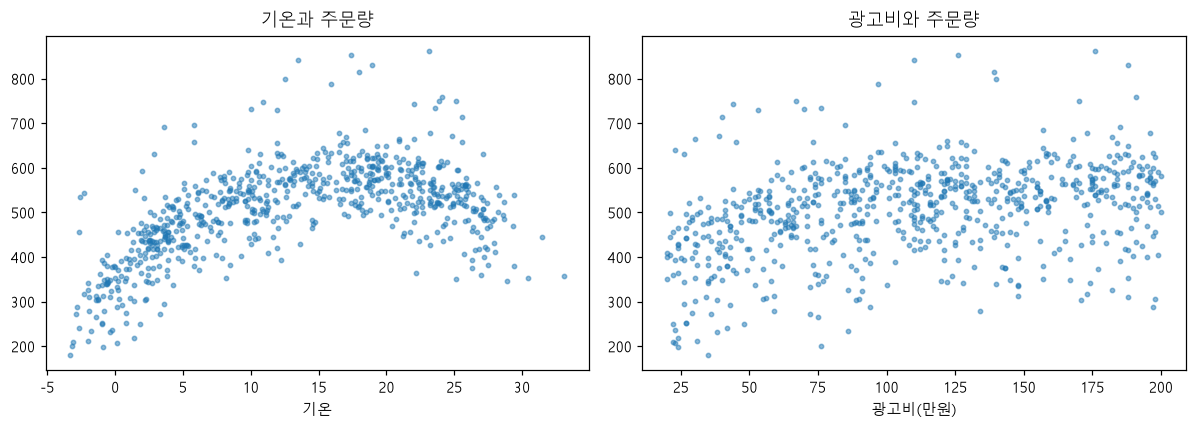
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
plt.subplots(1, 2, figsize=(11, 4)) | 가로 11, 세로 4 크기의 그림에 그래프 칸 두 개를 나란히 만든다. axes[0] 이 왼쪽, axes[1] 이 오른쪽 칸이다 |
axes[0].scatter(x, y, s=8, alpha=0.5) | 점을 찍는 산점도를 그린다. s 는 점 크기, alpha 는 투명도(0.5 는 반투명)라 겹친 점이 진하게 보인다 |
set_title, set_xlabel | 칸의 제목과 가로축 이름을 단다 |
plt.tight_layout() | 두 칸의 글자가 겹치지 않게 간격을 맞춘다 |
plt.show() | 그림을 화면에 띄운다 |
3단계. 특성 고르고 나누기
from sklearn.model_selection import train_test_split

# 날짜는 그대로 못 쓰므로 첫날부터 며칠째인지(일차)로 바꾼다
df["일차"] = range(len(df))
features = ["일차", "주말", "공휴일", "기온", "강수mm", "광고비만원", "할인행사"]
X = df[features]
y = df["주문량"]

# 학습용 80%, 시험용 20%. 회귀라서 stratify 는 쓰지 않는다
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print("학습용:", X_train.shape, "시험용:", X_test.shape)학습용: (584, 7) 시험용: (147, 7)이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
df["일차"] = range(len(df)) | 0, 1, 2, … 를 새 열로 붙인다. 날짜를 "첫날부터 며칠째"라는 숫자로 바꾼 것이다 |
df[features] | 고른 열 일곱 개만 뽑은 표. 이것이 특성 X 다 |
train_test_split(X, y, test_size=0.2, random_state=42) | 행을 섞어 학습용 80%, 시험용 20% 로 나눈다. random_state 는 섞는 순서의 씨앗이다 |
4단계. 크기 맞추고 텐서로 바꾸기
import torch
from sklearn.preprocessing import StandardScaler

# StandardScaler: 열마다 평균 0, 표준편차 1 로 맞춘다
# 광고비(20~200)와 공휴일(0, 1)처럼 크기가 다른 열을 같은 눈금으로 만들어 학습을 쉽게 한다
# fit 은 학습용에만 한다(시험용을 미리 보지 않도록)
scaler = StandardScaler().fit(X_train)
X_train_s = scaler.transform(X_train)
X_test_s = scaler.transform(X_test)
print("맞춘 뒤 학습용 평균:", X_train_s.mean(axis=0).round(2))

# 텐서로 바꾼다. 주문량은 100 으로 나눠 '백 건' 단위로 줄인다(예: 520건 → 5.2)
# view(-1, 1) 은 (건수,) 모양을 (건수, 1) 로 바꿔 모델의 출력 모양과 맞춘다
X_train_t = torch.tensor(X_train_s, dtype=torch.float32)
y_train_t = torch.tensor(y_train.to_numpy() / 100, dtype=torch.float32).view(-1, 1)
X_test_t = torch.tensor(X_test_s, dtype=torch.float32)
print(X_train_t.shape, y_train_t.shape, X_test_t.shape)맞춘 뒤 학습용 평균: [ 0. -0. -0. 0. -0. 0. -0.]
torch.Size([584, 7]) torch.Size([584, 1]) torch.Size([147, 7])이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
StandardScaler().fit(X_train) | 학습용에서 열마다 평균과 표준편차를 재어 기억해 둔다 |
scaler.transform(X) | 기억한 평균을 빼고 표준편차로 나눈다. 학습용과 시험용에 같은 잣대를 쓴다 |
.mean(axis=0) | 열마다(세로로) 평균을 낸다 |
y_train.to_numpy() / 100 | 주문량을 NumPy 배열로 꺼내 100 으로 나눈다 |
torch.tensor(..., dtype=torch.float32) | 배열을 float32 텐서로 바꾼다 |
.view(-1, 1) | 모양을 (건수, 1) 로 바꾼다. -1 은 "남은 칸 수에 맞춰 알아서"라는 뜻이다 |
이 실습이 뜻하는 것
이 실습은 요리를 하기 전에 재료를 손질하는 일과 같습니다. 장바구니에 무엇이 얼마나 들었는지 살펴보고(1단계), 재료끼리 어떻게 어울리는지 눈으로 확인하고(2단계), 쓸 재료를 골라 연습용과 시식용으로 나누고(3단계), 크기를 고르게 썰어 냄비에 담습니다(4단계). 여기서 장바구니가 daily_orders.csv, 연습용과 시식용이 학습용과 시험용, 고르게 썰기가 StandardScaler, 냄비가 텐서입니다. 연습용으로 만든 가상 데이터입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 표의 모양 | (731, 8) | 2년 치 731일, 항목 8개짜리 표입니다 |
| 1. 주문량 요약 | mean 506.1, min 181.0, max 862.0 | 하루 평균 506건쯤 주문이 들어오고, 적은 날은 181건, 많은 날은 862건입니다 |
| 2. 산점도 | 기온·광고비와 주문량 그림 | 기온은 가운데에서 주문이 많은 둥근 모양이고, 광고비는 늘수록 주문이 늘지만 점점 덜 늡니다. 둘 다 직선이 아닙니다 |
| 3. 나누기 | (584, 7), (147, 7) | 731일을 학습용 584일, 시험용 147일로 나눴습니다. 특성은 7개입니다 |
| 4. 크기 맞춤 | [ 0. -0. -0. 0. -0. 0. -0.] | 학습용의 열마다 평균이 0 이 되었습니다. -0. 은 아주 작은 음수를 반올림한 것으로 0 과 같습니다 |
| 4. 텐서 | [584, 7], [584, 1], [147, 7] | 특성과 정답이 신경망에 넣을 모양의 텐서가 되었습니다. 정답은 '백 건' 단위로 줄였습니다 |
한 줄로 줄이면, 주문량 표를 신경망이 먹을 수 있는 숫자 덩어리로 손질한 실습입니다. 실습 4부터 실습 6이 이 준비를 그대로 다시 적고 시작합니다. 아직 아무것도 학습하지 않았고, 그래프에서 본 곡선 모양은 "신경망이 쓸모 있을 것 같다"는 단서일 뿐 증명은 실습 6에서 기준선, 직선 모델과 견주어 합니다.
코드 설명
- 2년 치 731일, 열 8개입니다. 하루 주문량은 평균 506.1건이고, 가장 적은 날 181건, 가장 많은 날 862건입니다.
- 왼쪽 그래프에서 주문량은 기온이 너무 낮거나 높으면 줄고 가운데에서 많은 둥근 모양입니다. 오른쪽 그래프에서는 광고비가 늘수록 주문이 늘지만 점점 덜 늡니다. 둘 다 직선이 아닙니다. 이런 곡선 관계에서 신경망이 힘을 씁니다. 점의 색은 matplotlib 의 기본 색입니다.
StandardScaler는 열마다 평균을 빼고 표준편차로 나눕니다. 맞춘 뒤 학습용의 평균이 모두 0 이 된 것을 출력에서 확인할 수 있습니다.-0.은 아주 작은 음수가 반올림되어 찍힌 것으로, 0 과 같습니다. 시험용은 학습용의 평균과 표준편차로 바꾸므로 정확히 0 은 아닙니다.- 주문량을 100 으로 나눈 까닭은, 정답이 500 처럼 크면 처음에 0 근처를 내는 신경망이 거기까지 가는 데 오래 걸리기 때문입니다. 예측한 뒤에는 100 을 곱해 되돌립니다.
- 시험용 정답(
y_test)은 텐서로 바꾸지 않았습니다. 채점은 원래 단위(건)로 scikit-learn 의 MAE 함수로 하기 때문입니다.