2장. 신경망과 딥러닝의 기본 원리
실습 5 — 학습률 바꿔 보기
같은 신경망을 학습률 세 가지(0.0001, 0.01, 0.5)로 학습해, 손실이 줄어드는 모습과 시험용 MAE 를 견줍니다. "학습률" 절의 그림이 실제로도 그런지 확인하는 실습입니다.
1단계. 실습 3과 같은 준비
import pandas as pd
import torch
from torch import nn
import matplotlib.pyplot as plt
from torch.utils.data import TensorDataset, DataLoader
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_absolute_error

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

df = pd.read_csv("daily_orders.csv")
df["일차"] = range(len(df))
features = ["일차", "주말", "공휴일", "기온", "강수mm", "광고비만원", "할인행사"]
X_train, X_test, y_train, y_test = train_test_split(
    df[features], df["주문량"], test_size=0.2, random_state=42
)
scaler = StandardScaler().fit(X_train)
X_train_t = torch.tensor(scaler.transform(X_train), dtype=torch.float32)
X_test_t = torch.tensor(scaler.transform(X_test), dtype=torch.float32)
y_train_t = torch.tensor(y_train.to_numpy() / 100, dtype=torch.float32).view(-1, 1)
print(X_train_t.shape)torch.Size([584, 7])이 단계의 함수는 실습 3과 같습니다. 2단계에서 쓸 TensorDataset, DataLoader, mean_absolute_error 를 미리 불러 둔 것만 다릅니다.
2단계. 학습을 함수로 묶기
def train(lr, epochs=200):
    """학습률 lr 로 실습 4와 같은 신경망을 학습하고, (에포크별 손실, 시험용 MAE) 를 돌려준다."""
    torch.manual_seed(42)        # 세 학습률이 같은 출발점에서 시작하게 한다
    model = nn.Sequential(nn.Linear(7, 32), nn.ReLU(), nn.Linear(32, 16), nn.ReLU(), nn.Linear(16, 1))
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    loss_fn = nn.MSELoss()
    loader = DataLoader(TensorDataset(X_train_t, y_train_t), batch_size=32, shuffle=True,
                        generator=torch.Generator().manual_seed(42))
    history = []
    for epoch in range(epochs):
        total = 0.0
        for xb, yb in loader:
            opt.zero_grad()
            loss = loss_fn(model(xb), yb)
            loss.backward()
            opt.step()
            total += loss.item() * len(xb)
        history.append(total / len(X_train_t))
    with torch.no_grad():
        pred = model(X_test_t).numpy().ravel() * 100
    return history, mean_absolute_error(y_test, pred)

print("함수 준비 완료")함수 준비 완료이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
def train(lr, epochs=200): | 실습 4의 모델 만들기부터 채점까지를 함수 하나로 묶는다. 학습률만 바꿔 여러 번 부르려는 것이다 |
torch.manual_seed(42) (함수 안) | 부를 때마다 씨앗을 다시 고정해, 세 학습률이 똑같은 처음 가중치에서 출발하게 한다 |
nn.Sequential(...) 한 줄 | 실습 4와 같은 층을 한 줄로 적었다 |
return history, mean_absolute_error(...) | 에포크별 손실 리스트와 시험용 MAE 두 가지를 함께 돌려준다 |
3단계. 세 학습률로 학습하고 견주기
results = {}
for lr in [0.0001, 0.01, 0.5]:
    history, mae = train(lr)
    results[lr] = history
    # 마지막 에포크의 손실과 시험용 MAE 를 찍는다
    print(f"학습률 {lr:<6}  마지막 손실 {history[-1]:.4f}  시험용 MAE {mae:.1f}건")

# 세 손실 곡선을 한 그림에 겹쳐 그린다
plt.figure(figsize=(8, 3.5))
for lr, history in results.items():
    plt.plot(range(1, 201), history, label=f"학습률 {lr}")
plt.yscale("log")
plt.gca().yaxis.set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}"))   # 눈금을 보통 숫자로
plt.xlabel("에포크")
plt.ylabel("학습 손실(로그 눈금)")
plt.legend()
plt.title("학습률에 따른 손실 곡선")
plt.show()학습률 0.0001 마지막 손실 0.7626 시험용 MAE 76.1건
학습률 0.01 마지막 손실 0.0467 시험용 MAE 25.0건
학습률 0.5 마지막 손실 1.0930 시험용 MAE 77.8건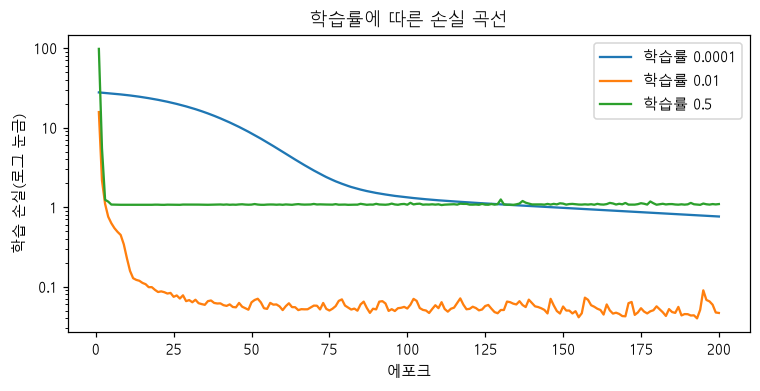
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
history, mae = train(lr) | 함수가 돌려준 두 값을 차례로 받는다 |
results[lr] = history | 학습률을 열쇠로 손실 리스트를 사전에 모아 둔다 |
f"{lr:<6}" | 학습률을 왼쪽 정렬로 여섯 칸에 맞춰 찍어 줄을 가지런히 한다 |
plt.plot(..., label=f"학습률 {lr}") | 선마다 이름표를 단다 |
plt.legend() | 이름표를 모아 범례(어느 색이 어느 학습률인지)를 그린다 |
이 실습이 뜻하는 것
이 실습은 안개 낀 산에서 걸음 폭만 바꿔 세 번 내려와 보는 일과 같습니다. 같은 산과 같은 출발점을 준비하고(1단계), 내려오는 방법을 한 가지 절차로 정해 둔 뒤(2단계), 아주 작은 걸음, 알맞은 걸음, 아주 큰 걸음으로 200걸음씩 내려와 어디까지 왔는지 견줍니다(3단계). 여기서 걸음 폭이 학습률, 산의 높이가 손실, 정해 둔 절차가 함수 train(lr) 입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | torch.Size([584, 7]) | 실습 3과 같은 재료입니다 |
| 2. 함수 | 함수 준비 완료 | 학습률만 바꿔 같은 학습을 되풀이할 준비가 되었습니다 |
| 3. 학습률 0.0001 | 손실 0.7626, MAE 76.1건 | 걸음이 너무 작아 200 에포크가 끝나도 아직 내려가는 중입니다 |
| 3. 학습률 0.01 | 손실 0.0467, MAE 25.0건 | 세 가지 가운데 가장 좋습니다. 실습 4와 같은 결과입니다 |
| 3. 학습률 0.5 | 손실 1.0930, MAE 77.8건 | 걸음이 너무 커서 흔들리다 내려가지 못했습니다. 77.8건은 실습 6의 "늘 평균을 말하는" 기준선과 같은 숫자입니다 |
| 3. 손실 곡선 | 세 선을 겹친 그래프 | 파랑(0.0001)은 천천히 내려가고, 주황(0.01)은 빠르게 떨어져 평평해지고, 초록(0.5)은 처음에 튀었다가 1 근처에 머뭅니다 |
한 줄로 줄이면, 같은 모델과 같은 출발점에서도 학습률 하나에 따라 MAE 가 25.0건에서 77.8건까지 달라진다는 것을 보인 실습입니다. 세 값만 200 에포크 동안 견준 결과라 "0.01 이 언제나 정답"이라는 뜻은 아니고, 0.0001 도 에포크를 훨씬 늘리면 더 좋아집니다. 다음 실습 6에서는 0.01 로 학습한 신경망을 다른 모델과 견줍니다.
코드 설명
- 학습을 함수
train(lr)로 묶어 두면 학습률만 바꿔 여러 번 부를 수 있습니다. 함수 안의 코드는 실습 4와 같습니다. - 세 번 모두
torch.manual_seed(42)로 같은 처음 가중치에서 출발하므로, 결과의 차이는 학습률에서만 옵니다. - 학습률 0.01 이 시험용 MAE 25.0건으로 가장 좋습니다. 그래프의 주황 선처럼 빠르게 떨어져 0.1 아래에서 평평해집니다.
- 0.0001 은 파랑 선처럼 아주 천천히 내려가 200 에포크가 끝나도 손실 0.7626, MAE 76.1건입니다. 보폭이 작아 아직 내려가는 중입니다. 에포크를 훨씬 늘리면 더 좋아집니다.
- 0.5 는 초록 선처럼 처음에 크게 튀었다가 손실 1 근처에서 더 내려가지 못합니다. MAE 77.8건은 실습 6의 기준선(늘 평균을 말하기)과 같은 숫자로, 큰 보폭에 흔들리다 사실상 평균만 말하는 모델이 되어 버린 것입니다.
- 그래프의 선 색은 matplotlib 의 기본 색입니다(파랑, 주황, 초록 순서).