2장. 신경망과 딥러닝의 기본 원리
학습률
안개 산에서 보폭을 정하는 일을 생각해 보세요. 보폭이 너무 작으면 해가 질 때까지 내려가지 못합니다. 너무 크면 골짜기를 건너뛰어 맞은편 비탈로 올라가 버립니다. 경사하강법의 보폭이 학습률입니다.
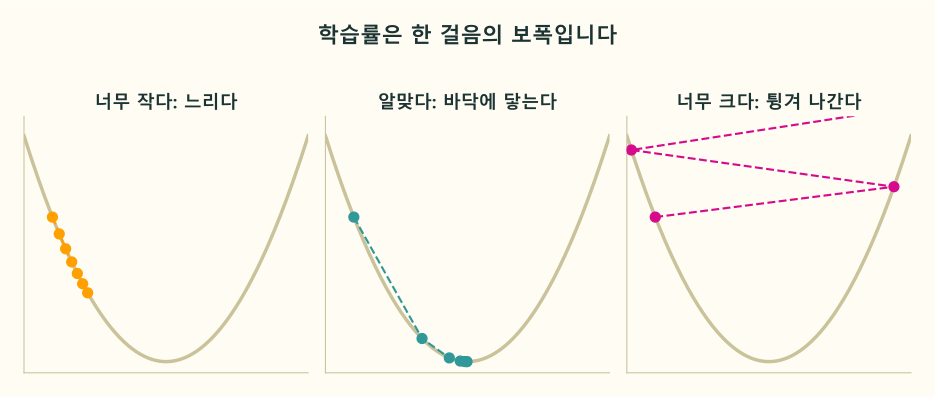
왼쪽 주황 점은 보폭이 너무 작아 여섯 걸음을 가도 아직 비탈 중간입니다. 가운데 청록 점은 몇 걸음 만에 바닥에 닿습니다. 오른쪽 마젠타 점은 보폭이 너무 커서 바닥을 건너뛰며 점점 위로 튕겨 나갑니다.
학습률 고르기
| 학습률 | 일어나는 일 | 손실 곡선의 모양 |
|---|---|---|
| 너무 작다(예: 0.0001) | 아주 느리게 줄어든다 | 거의 평평하게 천천히 내려간다 |
| 알맞다(예: 0.001~0.01, Adam 기준) | 빠르게 줄고 안정된다 | 처음에 크게 떨어지고 평평해진다 |
| 너무 크다(예: 0.5 이상) | 들쭉날쭉하거나 커진다 | 오르내리거나 줄지 않는다 |
알맞은 학습률은 옵티마이저와 데이터마다 다릅니다. 실습 5에서 세 가지 학습률로 직접 견주어 봅니다.
옵티마이저
가중치를 고치는 도구를 옵티마이저라고 합니다. 위의 "새 w = w - 학습률 × 기울기"를 그대로 하는 것이 SGD 이고, 걸음마다 보폭을 알아서 조절하는 것이 Adam 입니다.
| 옵티마이저 | 특징 | 흔히 쓰는 학습률 |
|---|---|---|
torch.optim.SGD | 식 그대로. 단순하다 | 0.01 ~ 0.1 |
torch.optim.Adam | 가중치마다 보폭을 조절한다. 처음 쓰기 좋다 | 0.001 ~ 0.01 |
import torch

w = torch.tensor([1.0], requires_grad=True)   # 학습할 가중치 하나
opt = torch.optim.SGD([w], lr=0.1)            # 이 가중치를 학습률 0.1 로 고치는 옵티마이저

loss = (w - 3) ** 2        # 바닥이 3 인 손실
loss.backward()            # 기울기 구하기: 2 × (1 - 3) = -4
opt.step()                 # w = 1 - 0.1 × (-4) = 1.4
print(w.item())
opt.step() 한 줄이 경사하강법 한 걸음입니다. w 는 1.0 에서 1.4 로 바닥 쪽(3)을 향해 움직입니다. 출력이 1.399999976158142 처럼 1.4 에 아주 조금 못 미치게 나오는데, PyTorch 텐서가 기본으로 소수를 float32(소수 7자리 안팎까지 정확한 형식)로 담기 때문에 생기는 작은 오차입니다.
requires_grad 와 backward() 를 짧게
두 가지는 다음 절 "역전파와 자동 미분"에서 자세히 봅니다. 여기서는 하는 일만 알아 둡니다.
| 코드 | 하는 일 | 안개 산으로 치면 |
|---|---|---|
requires_grad=True | "이 값은 학습할 값이니 기울기를 구해 달라"고 표시한다. 표시한 텐서는 계산 과정이 기록된다 | "내 자리는 움직일 수 있다"고 이름표를 단다 |
loss.backward() | 기록해 둔 계산을 거꾸로 따라가 기울기를 구하고, 표시한 텐서의 .grad 에 넣어 둔다 | 발밑의 경사를 더듬어 수첩에 적는다 |
opt.step() | .grad 에 적힌 기울기로 가중치를 고친다 | 수첩을 보고 한 걸음 옮긴다 |
앞 절에서는 기울기를 2 * (w - 3) 으로 사람이 직접 적었습니다. backward() 는 이 식을 몰라도 같은 값을 구해 줍니다. 표시하지 않은 텐서(requires_grad 를 주지 않은 텐서)는 기울기를 구하지 않으므로, 데이터처럼 바뀌면 안 되는 값에는 표시하지 않습니다.
이 코드가 뜻하는 것
이 코드는 앞 절 "경사하강법"의 손으로 걷기를 PyTorch 로 한 걸음만 다시 한 것입니다. 바닥이 3 인 같은 손실에서, 출발점 1.0, 학습률 0.1 로 걸었습니다. 달라진 것은 기울기 계산과 가중치 고치기를 사람이 적지 않고 PyTorch 에 맡겼다는 점입니다.
| 할 일 | 앞 절(손으로) | 이 코드(PyTorch) |
|---|---|---|
| 기울기 구하기 | grad = 2 * (w - 3) 을 직접 적는다 | loss.backward() 가 구한다 |
| 한 걸음 옮기기 | w = w - lr * grad 를 직접 적는다 | opt.step() 이 한다 |
| 학습률 정하기 | lr = 0.3 | SGD([w], lr=0.1) 에 넣어 둔다 |
과정 안에 숨은 값을 하나씩 찍어 보면 무슨 일이 일어나는지 보입니다.
import torch

w = torch.tensor([1.0], requires_grad=True)
opt = torch.optim.SGD([w], lr=0.1)

loss = (w - 3) ** 2
print("backward 전 기울기:", w.grad)        # 아직 구하지 않아 None
loss.backward()
print("backward 후 기울기:", w.grad)        # 2 × (1 - 3) = -4
opt.step()
print("step 후 가중치:", w)                 # 1 - 0.1 × (-4) = 1.4
실행하면 기울기는 backward() 전에는 None, 뒤에는 tensor([-4.]) 이고, step() 뒤의 가중치는 tensor([1.4000], requires_grad=True) 입니다. 기울기 -4 는 "w 를 키우면 손실이 줄어든다"는 뜻이라, 옵티마이저가 w 를 0.1 × 4 = 0.4 만큼 키웠습니다.
실제 학습은 이 세 줄(손실 계산, backward(), step())을 데이터를 바꿔 가며 수천 번 되풀이합니다. 가중치가 수백만 개여도 코드는 같고, backward() 가 모든 가중치의 기울기를, step() 이 모든 가중치의 갱신을 한꺼번에 해 줍니다. 되풀이할 때 꼭 필요한 한 줄(기울기 지우기)은 뒤의 "학습 루프" 절에서 봅니다.
주의할 점
- 손실이 줄지 않고
nan(숫자가 아님)이 나오면 학습률부터 낮춰 봅니다. 대부분 보폭이 너무 커서 튕겨 나간 경우입니다. - 학습률도 사람이 정하는 설정이라, 원래는 검증용 데이터로 고릅니다.