2장. 신경망과 딥러닝의 기본 원리
실습 4 — 주문량 예측 신경망 학습하기
실습 3과 같은 준비를 한 뒤, 은닉층 둘(32개, 16개)짜리 신경망을 만들어 200 에포크 동안 학습합니다. 손실이 줄어드는 모습을 그래프로 보고, 시험용으로 MAE 를 잽니다. 결과를 똑같이 맞추려고 CPU 에서 학습합니다.
1단계. 실습 3과 같은 준비
import pandas as pd
import torch
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 실습 3과 똑같이 준비한다
df = pd.read_csv("daily_orders.csv")
df["일차"] = range(len(df))
features = ["일차", "주말", "공휴일", "기온", "강수mm", "광고비만원", "할인행사"]
X_train, X_test, y_train, y_test = train_test_split(
    df[features], df["주문량"], test_size=0.2, random_state=42
)
scaler = StandardScaler().fit(X_train)
X_train_t = torch.tensor(scaler.transform(X_train), dtype=torch.float32)
X_test_t = torch.tensor(scaler.transform(X_test), dtype=torch.float32)
y_train_t = torch.tensor(y_train.to_numpy() / 100, dtype=torch.float32).view(-1, 1)
print(X_train_t.shape, y_train_t.shape)torch.Size([584, 7]) torch.Size([584, 1])이 단계는 실습 3의 1·3·4단계를 한 칸에 모은 것이라, 함수도 실습 3의 표와 같습니다.
2단계. 신경망 만들기
from torch import nn

torch.manual_seed(42)   # 가중치의 처음 난수를 고정해서 언제 돌려도 같게 한다

# nn.Sequential: 층을 적은 순서대로 이어 붙인다
model = nn.Sequential(
    nn.Linear(7, 32),    # 입력 7 → 은닉층 1 의 뉴런 32개 (가중합)
    nn.ReLU(),           # 활성화 함수
    nn.Linear(32, 16),   # 은닉층 1 → 은닉층 2 의 뉴런 16개
    nn.ReLU(),
    nn.Linear(16, 1),    # 은닉층 2 → 출력 1개(주문량). 회귀라 활성화 없음
)
print(model)

# 파라미터(가중치와 편향)가 모두 몇 개인지 센다. numel() 은 텐서 안의 숫자 개수
print("파라미터 수:", sum(p.numel() for p in model.parameters()))Sequential(
(0): Linear(in_features=7, out_features=32, bias=True)
(1): ReLU()
(2): Linear(in_features=32, out_features=16, bias=True)
(3): ReLU()
(4): Linear(in_features=16, out_features=1, bias=True)
)
파라미터 수: 801이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
torch.manual_seed(42) | 가중치를 채울 난수의 씨앗을 고정한다. 언제 돌려도 같은 출발점에서 시작한다 |
nn.Sequential(층, 층, ...) | 적은 순서대로 층을 이어 붙여 모델 하나로 만든다. 입력이 위에서 아래로 차례로 지나간다 |
nn.Linear(7, 32) | 입력 7개를 받아 뉴런 32개의 가중합을 내는 층. 가중치 7×32 개와 편향 32 개를 갖는다 |
nn.ReLU() | 음수는 0, 양수는 그대로 넘기는 활성화 함수 층 |
print(model) | 모델의 층 목록을 찍는다. (0), (1) 은 층의 번호다 |
model.parameters() | 모델 안의 모든 가중치와 편향 텐서를 차례로 내준다 |
p.numel() | 텐서 하나에 든 숫자의 개수. 모두 더하면 파라미터 수다 |
3단계. 학습하기
from torch.utils.data import TensorDataset, DataLoader

loss_fn = nn.MSELoss()                                     # 회귀 손실
opt = torch.optim.Adam(model.parameters(), lr=0.01)        # 옵티마이저와 학습률

# DataLoader: 학습용을 32건씩 배치로 나눠 준다. shuffle=True 는 에포크마다 순서를 섞는다
# generator 에 씨앗을 줘서 섞는 순서도 고정한다
loader = DataLoader(TensorDataset(X_train_t, y_train_t), batch_size=32, shuffle=True,
                    generator=torch.Generator().manual_seed(42))

history = []                                # 에포크마다의 손실을 모아 둔다
for epoch in range(1, 201):
    total = 0.0
    for xb, yb in loader:                   # 배치마다
        opt.zero_grad()                     # 1) 지난 기울기 지우기
        loss = loss_fn(model(xb), yb)       # 2) 순전파, 3) 손실
        loss.backward()                     # 4) 역전파
        opt.step()                          # 5) 가중치 고치기
        total += loss.item() * len(xb)      # 배치 손실 × 건수를 더해 둔다
    history.append(total / len(X_train_t))  # 에포크 평균 손실
    if epoch in (1, 10, 50, 100, 200):
print(f"에포크 {epoch:3d} 손실 {history[-1]:.4f}")에포크 1 손실 15.6704
에포크 10 손실 0.2280
에포크 50 손실 0.0636
에포크 100 손실 0.0531
에포크 200 손실 0.0467이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
nn.MSELoss() | 회귀용 손실 함수(평균 제곱 오차) |
torch.optim.Adam(model.parameters(), lr=0.01) | 모델의 모든 파라미터를 학습률 0.01 로 고칠 옵티마이저 |
TensorDataset(X, y) | 특성 텐서와 정답 텐서를 줄마다 짝지어 묶는다. i 번째를 꺼내면 (X 의 i 번째 줄, y 의 i 번째 줄)이 나온다 |
DataLoader(..., batch_size=32, shuffle=True) | 묶은 데이터를 32건씩 나눠 차례로 내준다. shuffle=True 는 에포크마다 순서를 섞는다 |
generator=torch.Generator().manual_seed(42) | 섞는 순서의 씨앗을 고정한다. 다시 돌려도 같은 순서로 섞인다 |
for xb, yb in loader: | 배치 하나씩 (특성 32건, 정답 32건)을 받는다. 584건이면 마지막 배치는 8건이다 |
loss_fn(model(xb), yb) | 배치를 모델에 넣어 예측하고(순전파) 정답과 견줘 손실을 낸다 |
loss.item() * len(xb) | 배치의 평균 손실에 건수를 곱해 합계로 되돌린다. 크기가 다른 마지막 배치도 바르게 평균 내려는 것이다 |
history.append(...) | 에포크마다의 평균 손실을 리스트에 모아 둔다. 4단계에서 그래프로 그린다 |
4단계. 손실 곡선 보고 채점하기
from sklearn.metrics import mean_absolute_error

# 에포크에 따른 학습 손실을 그린다
plt.figure(figsize=(8, 3.5))
plt.plot(range(1, 201), history)
plt.yscale("log")             # 처음과 나중의 차이가 커서 세로축을 로그 눈금으로
# 눈금을 0.1, 1, 10 처럼 보통 숫자로 적는다(10의 거듭제곱 꼴은 한글 글꼴에서 빼기 기호가 깨진다)
plt.gca().yaxis.set_major_formatter(plt.FuncFormatter(lambda v, _: f"{v:g}"))
plt.xlabel("에포크")
plt.ylabel("학습 손실(MSE, 로그 눈금)")
plt.title("에포크가 지날수록 손실이 줄어듭니다")
plt.show()

# 평가: 학습이 아니므로 기울기 기록을 끈다(no_grad). 예측에 100 을 곱해 '건' 단위로 되돌린다
model.eval()
with torch.no_grad():
    pred = model(X_test_t).numpy().ravel() * 100
print("시험용 MAE:", round(mean_absolute_error(y_test, pred), 1), "건")시험용 MAE: 25.0 건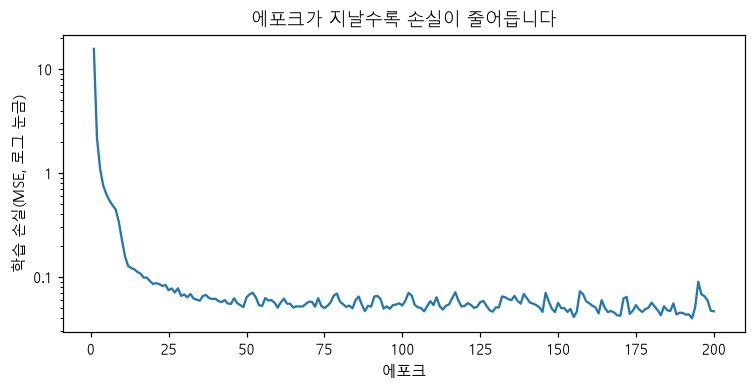
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
plt.figure(figsize=(8, 3.5)) | 가로 8, 세로 3.5 크기의 새 그림을 연다 |
plt.plot(range(1, 201), history) | 가로축 에포크 1~200, 세로축 손실로 선을 그린다 |
plt.yscale("log") | 세로축을 로그 눈금으로 바꾼다. 15 와 0.05 처럼 크기가 아주 다른 값을 한 그림에 보이게 한다 |
plt.gca().yaxis.set_major_formatter(...) | 지금 그래프(gca)의 세로축 눈금 글자를 0.1, 1, 10 같은 보통 숫자로 적게 한다 |
model.eval() | 모델을 평가 모드로 바꾼다는 표시 |
with torch.no_grad(): | 평가 계산은 기록하지 않는다. 기울기가 필요 없어 빠르고 메모리도 덜 쓴다 |
model(X_test_t).numpy().ravel() * 100 | 시험용을 예측해 NumPy 배열로 바꾸고, (147, 1) 을 (147,) 한 줄로 편 뒤(ravel), 100 을 곱해 '건' 단위로 되돌린다 |
mean_absolute_error(실제, 예측) | scikit-learn 의 MAE. 빗나간 크기의 평균이다 |
이 실습이 뜻하는 것
이 실습은 신입 직원에게 하루 주문량 맞히기를 가르치는 일과 같습니다. 손질한 자료를 받고(1단계), 판단에 쓸 머릿속 구조를 정하고(2단계), 32일치씩 묶어 문제를 풀고 틀린 만큼 고치기를 자료 전체로 200바퀴 되풀이하고(3단계), 연습 기록을 그래프로 본 뒤 처음 보는 날로 시험을 봅니다(4단계). 여기서 머릿속 구조가 은닉층 둘짜리 신경망, 32일치 묶음이 배치, 한 바퀴가 에포크, 시험 점수가 MAE(Mean Absolute Error, 평균 절대 오차)입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | [584, 7], [584, 1] | 실습 3과 같은 재료가 준비되었습니다 |
| 2. 모델 | 파라미터 수 801 | 학습으로 고칠 숫자가 801개입니다. 층마다 256개, 528개, 17개를 더한 값입니다 |
| 3. 학습 | 손실 15.6704 → 0.2280 → 0.0467 | 처음에는 크게 빗나가다가 10바퀴 만에 손실이 크게 줄고, 200바퀴 뒤에는 0.0467 까지 내려갔습니다 |
| 4. 손실 곡선 | 로그 눈금 그래프 | 처음 20 에포크 안에 크게 떨어지고, 그 뒤로는 조금씩 오르내리며 평평해집니다 |
| 4. 시험 | MAE 25.0 건 | 처음 보는 날의 주문량을 평균 25건쯤 빗나가게 맞힙니다. 하루 평균 506건에 견주면 5%쯤입니다 |
한 줄로 줄이면, 층 두 개짜리 작은 신경망이 하루 주문량을 평균 25건쯤 차이로 맞히도록 학습되었다는 것을 보인 실습입니다. 손실 0.0467 은 '백 건' 단위의 제곱이라 그대로 읽기 어렵고, 사람이 읽는 숫자는 MAE 입니다. 25건이 좋은 점수인지는 이 숫자만으로 알 수 없으며, 실습 5에서 학습률을 바꿔 보고 실습 6에서 기준선, 직선 모델과 견주어 판단합니다.
코드 설명
nn.Linear(7, 32)는 가중치 7×32 개와 편향 32 개를 가진 층입니다. 순전파 절에서 NumPy 로 한x @ W1 + b1을 대신 해 줍니다.- 파라미터 수는 801개로, "층을 쌓은 신경망" 절에서 손으로 센 숫자와 같습니다.
- 손실은 첫 에포크 15.6704 에서 10번째 0.2280, 200번째 0.0467 로 줄었습니다. 그래프에서 처음 20 에포크 안에 크게 떨어지고, 그 뒤로는 조금씩 오르내리며 평평해집니다. 오르내리는 것은 배치마다 섞인 순서가 달라서입니다.
- 시험용 MAE 는 25.0건입니다. 처음 보는 날의 주문량을 평균 25건쯤 빗나가게 맞힌다는 뜻입니다. 손실 0.0467 은 '백 건' 단위의 제곱이라 바로 읽기 어렵고, MAE 로 바꿔야 사람이 읽을 수 있습니다.
- 학습 루프 안의 다섯 줄은 "학습 루프" 절의 그림 그대로입니다. 2)와 3)을
loss_fn(model(xb), yb)한 줄로 합쳤습니다. model.eval()은 "이제 평가한다"는 표시입니다. 이 모델에서는 결과가 달라지지 않지만, 4장부터 쓰는 층 가운데 학습과 평가 때 다르게 움직이는 것이 있어 습관으로 붙입니다.