2장. 신경망과 딥러닝의 기본 원리
프로젝트 1 — 손글씨 숫자 분류하기
우편물의 손글씨 우편번호를 자동으로 읽는다고 해 봅시다. 8×8 칸짜리 흑백 손글씨 숫자 그림 1,797장을 0부터 9까지의 숫자로 분류하는 신경망을 만들어 보세요. 데이터는 scikit-learn 에 들어 있는 load_digits 로, 실제 사람이 쓴 손글씨를 모은 공개 자료입니다. 인터넷 없이 바로 불러올 수 있습니다.
| 항목 | 내용 |
|---|---|
| 그림 | 8×8 칸. 칸마다 0(흰색) ~ 16(검은색)의 진하기 |
| 특성 | 칸 64개를 한 줄로 편 값 |
| 레이블 | 0 ~ 9 의 숫자 |
| 건수 | 1,797장 |
요구사항은 다섯 가지입니다.
- 데이터를 불러와 그림 몇 장을 그려 봅니다.
- 진하기를 0~1 로 맞추고, 학습용 80%, 시험용 20% 로 나눕니다. 숫자마다의 비율을 맞춰 나눕니다.
- 은닉층 하나(뉴런 64개)짜리 신경망을 만들어 학습합니다. 출력은 숫자 10개입니다.
- 시험용 정확도와 혼동행렬을 구합니다.
- 틀린 그림을 몇 장 그려 보고, 왜 헷갈렸을지 한두 문장으로 적습니다.
단계별 힌트입니다.
from sklearn.datasets import load_digits로 불러오고,digits.data가 특성(1797, 64),digits.target이 레이블,digits.images가 그림용 (1797, 8, 8) 입니다.- 진하기의 최댓값이 16 이므로 16 으로 나누면 0~1 이 됩니다. 나눌 때
stratify=y를 줍니다. - 분류이므로 손실은
nn.CrossEntropyLoss()이고, 출력층은nn.Linear(64, 10)에 활성화 함수 없이 둡니다. 레이블은dtype=torch.long(정수) 텐서로 만듭니다. - 예측한 숫자는 출력 10개 가운데 가장 큰 칸의 번호입니다.
model(X).argmax(dim=1)로 구합니다. - 혼동행렬은 1장의
ConfusionMatrixDisplay.from_predictions를 그대로 씁니다.
확인할 것: 다 풀었으면 항목마다 스스로 확인해 체크해 보세요.
실제 데이터로 해 보려면
같은 방법을 더 큰 손글씨 자료로 넓혀 볼 수 있습니다. 내려받기 전에 자료의 이용 조건을 확인하세요.
| 자료 | 구하는 곳 | 내용 |
|---|---|---|
| MNIST | torchvision.datasets.MNIST 로 내려받기 | 28×28 손글씨 숫자 7만 장. 특성이 784개가 된다 |
| Fashion-MNIST | torchvision.datasets.FashionMNIST | 옷, 신발, 가방 같은 상품 그림 7만 장. 10가지로 분류 |
| AI Hub 의 한글 손글씨 데이터 | AI Hub 누리집(회원 가입 후 신청) | 한글 손글씨 그림. 신청과 승인이 필요하다 |
MNIST 를 내려받는 모양은 아래와 같습니다. 이 PC 에서 실행하지 않은 안내 코드이고, torchvision 을 따로 설치해야 합니다. 그림이 28×28 이므로 입력층을 nn.Linear(784, 64) 로 바꾸면 아래 풀이를 거의 그대로 쓸 수 있습니다.
from torchvision import datasets, transforms
train = datasets.MNIST("mnist", train=True, download=True, transform=transforms.ToTensor())
코드의 흐름
예시 풀이의 코드가 어떤 차례로 흘러가는지 한 장으로 그렸습니다. 풀기 전에 큰 줄기를 먼저 보고, 풀다가 막히면 지금 어느 상자에 있는지 확인해 보세요.
주황 화살표가 실행 차례이고, 상자의 번호는 예시 풀이의 단계 번호와 같습니다. 다만 마지막 상자는 5~6단계를 묶었습니다. 1단계(청록)에서 load_digits() 로 그림을 불러와 10장을 그려 보고, 2단계(마젠타)에서 진하기를 16 으로 나눠 0~1 로 맞춘 뒤 stratify=y 로 나눕니다. 3단계(다홍)는 nn.Sequential 로 만든 신경망을 CrossEntropyLoss 로 30 에포크 학습하고, 4단계(빨강)는 argmax 로 고른 숫자로 정확도와 혼동행렬을 구합니다. 5~6단계(짙은 청록)는 np.where 로 틀린 그림을 골라 그리고, 숫자별 정확도와 확신 정도를 봅니다.
결과 보기 (예시 풀이)
1단계. 불러와서 그려 보기
import numpy as np
import torch
from torch import nn
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

digits = load_digits()
print(digits.data.shape, digits.target.shape)

# 앞의 그림 10장을 2줄 5칸으로 그린다. cmap="gray_r" 은 0 을 흰색, 큰 값을 검은색으로
fig, axes = plt.subplots(2, 5, figsize=(8, 3.6))
for ax, img, label in zip(axes.ravel(), digits.images, digits.target):
    ax.imshow(img, cmap="gray_r")
    ax.set_title(f"정답 {label}")
    ax.axis("off")
plt.tight_layout()
plt.show()(1797, 64) (1797,)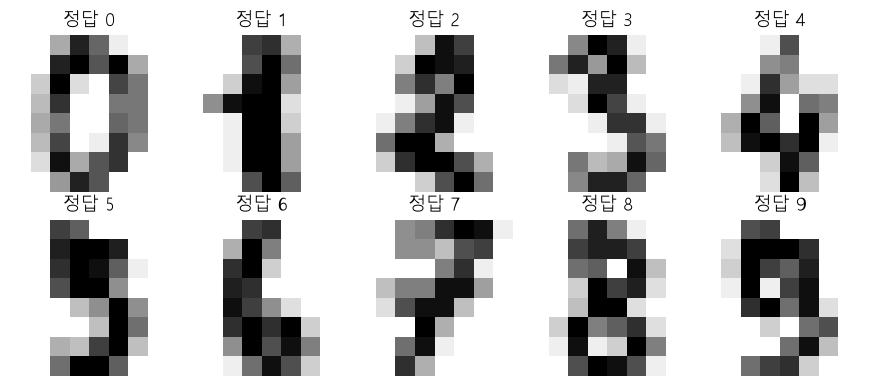
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
load_digits() | scikit-learn 에 들어 있는 손글씨 숫자 자료를 불러온다. 인터넷 없이 바로 된다 |
digits.data | 그림마다 8×8 칸 64개를 한 줄로 편 표. 모양은 (1797, 64) 다 |
digits.target | 그림마다의 정답 숫자(0~9). 모양은 (1797,) 다 |
digits.images | 같은 그림을 8×8 모양 그대로 둔 것. 그림을 그릴 때 쓴다 |
plt.subplots(2, 5, figsize=(8, 3.6)) | 2줄 5칸, 그래프 칸 10개를 만든다 |
axes.ravel() | 2줄 5칸의 칸 묶음을 한 줄 10개로 편다. zip 으로 그림과 하나씩 짝짓기 위해서다 |
ax.imshow(img, cmap="gray_r") | 숫자 표를 그림으로 그린다. gray_r 은 회색조를 뒤집어 0 은 흰색, 큰 값은 검은색이다 |
ax.axis("off") | 칸의 눈금과 테두리를 없앤다 |
2단계. 맞추고 나누기
from sklearn.model_selection import train_test_split

X = digits.data / 16.0          # 진하기 0~16 을 0~1 로
y = digits.target

# 숫자마다의 비율을 맞춰 학습용 80%, 시험용 20% 로 나눈다
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)

# 특성은 float32, 분류 레이블은 정수(long) 텐서로
X_train_t = torch.tensor(X_train, dtype=torch.float32)
y_train_t = torch.tensor(y_train, dtype=torch.long)
X_test_t = torch.tensor(X_test, dtype=torch.float32)
print(X_train_t.shape, y_train_t.shape, X_test_t.shape)torch.Size([1437, 64]) torch.Size([1437]) torch.Size([360, 64])이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
digits.data / 16.0 | 칸의 진하기 0~16 을 0~1 로 줄인다. 2장 실습 3의 StandardScaler 처럼 숫자의 크기를 고르게 맞추는 일이다 |
train_test_split(..., stratify=y) | 학습용과 시험용에 0~9 가 같은 비율로 들어가게 나눈다 |
torch.tensor(X, dtype=torch.float32) | 그림의 칸 값을 소수 텐서로 바꾼다 |
torch.tensor(y, dtype=torch.long) | 정답을 정수 텐서로 바꾼다. 분류 손실 함수는 정답을 "몇 번 칸이 정답인가"라는 정수로 받는다 |
3단계. 분류 신경망 학습하기
from torch.utils.data import TensorDataset, DataLoader

torch.manual_seed(42)
model = nn.Sequential(
    nn.Linear(64, 64),   # 칸 64개 → 은닉층 뉴런 64개
    nn.ReLU(),
    nn.Linear(64, 10),   # → 숫자 10개의 점수. 활성화 없음(손실 함수가 확률로 바꿔 준다)
)
loss_fn = nn.CrossEntropyLoss()     # 분류 손실
opt = torch.optim.Adam(model.parameters(), lr=0.01)
loader = DataLoader(TensorDataset(X_train_t, y_train_t), batch_size=64, shuffle=True,
                    generator=torch.Generator().manual_seed(42))

for epoch in range(1, 31):
    for xb, yb in loader:
        opt.zero_grad()
        loss = loss_fn(model(xb), yb)
        loss.backward()
        opt.step()
    if epoch in (1, 10, 30):
print(f"에포크 {epoch:2d} 마지막 배치 손실 {loss.item():.4f}")에포크 1 마지막 배치 손실 0.5397
에포크 10 마지막 배치 손실 0.0274
에포크 30 마지막 배치 손실 0.0050이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
nn.Linear(64, 64) | 칸 64개를 받아 은닉층 뉴런 64개의 가중합을 낸다 |
nn.Linear(64, 10) | 숫자 0~9 의 점수 10개를 낸다. 점수가 클수록 그 숫자일 가능성이 크다 |
nn.CrossEntropyLoss() | 분류용 손실 함수(교차 엔트로피). 점수 10개를 안에서 확률로 바꾼 뒤, 정답 칸의 확률이 낮을수록 손실을 크게 낸다 |
loss_fn(model(xb), yb) | 점수 (64, 10) 와 정답 번호 (64,) 를 넣는다. 정답은 확률 표가 아니라 번호 하나로 준다 |
batch_size=64 | 64장씩 묶어 고친다. 1437장이면 에포크마다 23번 고친다 |
loss.item() | 그 에포크의 마지막 배치 손실을 숫자로 꺼낸다 |
나머지 줄(manual_seed, Adam, DataLoader, 다섯 줄 학습 루프)은 2장 실습 4와 같습니다.
4단계. 정확도와 혼동행렬
from sklearn.metrics import accuracy_score, ConfusionMatrixDisplay

with torch.no_grad():
    # 출력 10칸 가운데 가장 큰 칸의 번호가 예측한 숫자다
    pred = model(X_test_t).argmax(dim=1).numpy()
print("시험용 정확도:", round(accuracy_score(y_test, pred), 3))

ConfusionMatrixDisplay.from_predictions(y_test, pred)
plt.title("손글씨 숫자 혼동행렬")
plt.show()시험용 정확도: 0.969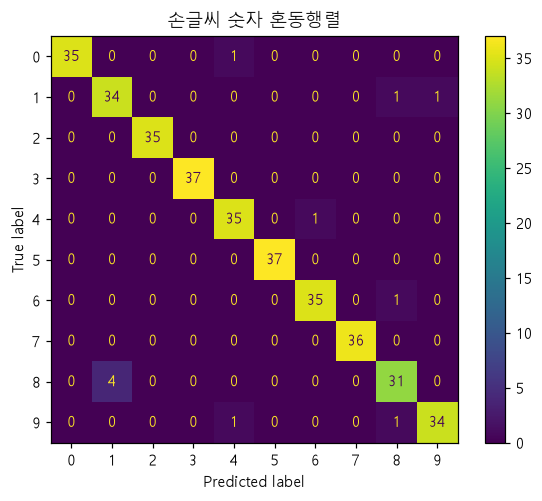
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
with torch.no_grad(): | 평가할 때는 기울기를 기록하지 않는다 |
model(X_test_t) | 시험용 360장의 점수를 낸다. 모양은 (360, 10) 이다 |
.argmax(dim=1) | 줄마다 가장 큰 점수가 있는 칸의 번호를 고른다. 그 번호가 예측한 숫자다. dim=1 은 "가로(칸 10개) 방향으로 견준다"는 뜻이다 |
.numpy() | 예측 텐서를 NumPy 배열로 바꿔 scikit-learn 함수에 넣는다 |
accuracy_score(실제, 예측) | 맞힌 비율(정확도) |
ConfusionMatrixDisplay.from_predictions(실제, 예측) | 혼동행렬을 그림으로 그린다. 1장에서 본 것과 같고, 칸이 10×10 으로 커졌을 뿐이다 |
혼동행렬의 대각선(왼쪽 위에서 오른쪽 아래)이 맞힌 수이고, 대각선 밖의 칸이 "정답 몇을 몇으로 읽었나"입니다.
5단계. 틀린 그림 보기
wrong = np.where(pred != y_test)[0]      # 틀린 그림의 위치(번호)
print("틀린 그림:", len(wrong), "장")

# 틀린 그림을 최대 8장 그린다. 제목에 정답과 예측을 적는다
fig, axes = plt.subplots(1, 8, figsize=(10, 1.9))
for ax, i in zip(axes, wrong[:8]):
    ax.imshow(X_test[i].reshape(8, 8), cmap="gray_r")
    ax.set_title(f"정답{y_test[i]}→{pred[i]}", fontsize=10)
    ax.axis("off")
for ax in axes[len(wrong):]:
    ax.axis("off")
plt.tight_layout()
plt.show()틀린 그림: 11 장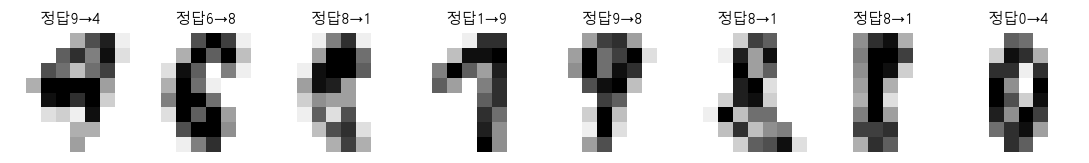
이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
pred != y_test | 예측과 정답이 다른 자리만 True 인 배열을 만든다 |
np.where(...)[0] | True 인 자리의 번호들을 꺼낸다. 틀린 그림의 위치 목록이다 |
wrong[:8] | 앞에서부터 최대 8개만 쓴다 |
X_test[i].reshape(8, 8) | 한 줄로 펴 둔 칸 64개를 다시 8×8 그림 모양으로 접는다 |
ax.set_title(..., fontsize=10) | 칸 위에 "정답→예측"을 작은 글씨로 적는다 |
for ax in axes[len(wrong):]: ax.axis("off") | 틀린 그림이 8장보다 적을 때 남는 빈 칸의 테두리를 지운다 |
6단계. 숫자별 정확도와 확신 정도 보기
from sklearn.metrics import confusion_matrix

with torch.no_grad():
    # 학습용도 예측해 본다. 학습용과 시험용의 차이로 과적합을 가늠한다
    train_pred = model(X_train_t).argmax(dim=1).numpy()
    # softmax 로 점수 10개를 확률로 바꾸고, 고른 숫자의 확률(가장 큰 값)만 남긴다
    prob = torch.softmax(model(X_test_t), dim=1).max(dim=1).values.numpy()
print("학습용 정확도:", round(accuracy_score(y_train, train_pred), 3))

# 혼동행렬의 대각선(맞힌 수) ÷ 줄의 합(그 숫자의 그림 수) = 숫자별 맞힌 비율
cm = confusion_matrix(y_test, pred)
print("숫자별 맞힌 비율(0~9):", (cm.diagonal() / cm.sum(axis=1)).round(3))

right = pred == y_test
print("고른 숫자의 확률 평균  맞힌 그림:", round(prob[right].mean(), 3), " 틀린 그림:", round(prob[~right].mean(), 3))
print("0.9 넘게 확신하고 틀린 그림:", (prob[~right] > 0.9).sum(), "장")학습용 정확도: 1.0
숫자별 맞힌 비율(0~9): [0.972 0.944 1. 1. 0.972 1. 0.972 1. 0.886 0.944]
고른 숫자의 확률 평균 맞힌 그림: 0.986 틀린 그림: 0.747
0.9 넘게 확신하고 틀린 그림: 4 장이 단계의 함수입니다.
| 코드 | 쉬운 뜻 |
|---|---|
torch.softmax(점수, dim=1) | 줄마다 점수 10개를 더해서 1 이 되는 확률로 바꾼다 |
.max(dim=1).values | 줄마다 가장 큰 확률, 곧 모델이 고른 숫자에 준 확률만 꺼낸다 |
confusion_matrix(실제, 예측) | 혼동행렬을 그림이 아닌 숫자 표(10×10 배열)로 돌려준다 |
cm.diagonal() | 대각선 칸, 곧 숫자마다 맞힌 그림 수 |
cm.sum(axis=1) | 줄마다의 합, 곧 숫자마다 시험용 그림 수 |
prob[right], prob[~right] | 맞힌 그림과 틀린 그림의 확률을 나눠 꺼낸다. ~ 는 True 와 False 를 뒤집는다 |
30 에포크 학습 뒤 시험용 정확도는 0.969 로, 360장 가운데 11장을 틀렸습니다. 혼동행렬에서 가장 많은 실수는 8 을 1 로 읽은 4장입니다. 틀린 그림을 보면 8 의 가운데가 좁고 길게 쓰여 세로 막대처럼 보이고, 9 는 위쪽 고리가 열려 4 처럼, 1 은 윗부분이 꺾여 9 처럼 보입니다. 사람도 8×8 칸만 보고는 헷갈릴 만한 그림들입니다. 이 신경망은 칸 64개를 한 줄로 펴서 보기 때문에 "위쪽에 고리가 있다" 같은 모양의 위치 관계를 직접 쓰지 못합니다. 그림의 모양을 잘 보는 신경망(합성곱 신경망)이나, 더 큰 MNIST 로 넓혀 보면 이런 실수가 줄어듭니다.
결과를 어떻게 읽나
찍기와 견줍니다. 숫자가 10종류이고 시험용 360장에 숫자마다 35~37장이 고르게 들어 있어서, 아무렇게나 찍거나 가장 흔한 숫자 하나만 말해도 10%쯤 맞습니다. 신경망은 96.9% 로, 시험지 33장마다 1장꼴로 틀립니다.
숫자마다 실력이 다릅니다. 6단계의 숫자별 맞힌 비율을 보면 2, 3, 5, 7 은 한 장도 틀리지 않았고, 8 이 88.6%(35장 가운데 31장)로 가장 약합니다. 틀린 8 네 장은 모두 1 로 읽었고, 거꾸로 1 을 8 로 읽은 것은 한 장뿐입니다. 전체 정확도 하나만 보면 이런 약점이 숨으므로 혼동행렬과 숫자별 비율을 함께 봅니다.
학습용은 다 외웠고, 시험용과의 차이는 작습니다. 학습용 정확도는 1.0, 시험용은 0.969 입니다. 차이가 3%p 남짓이라 과적합이 심하지는 않지만, 학습용을 이미 다 맞히고 있어 에포크를 늘려도 시험 점수가 오를 여지는 적습니다.
틀릴 때는 덜 확신합니다. 모델이 고른 숫자에 준 확률은 맞힌 그림에서 평균 0.986, 틀린 그림에서 0.747 입니다. 확률이 낮은 그림만 사람에게 넘겨 확인하게 하면 실수를 꽤 거를 수 있습니다. 다만 틀린 11장 가운데 4장은 0.9 넘게 확신하고 틀렸으므로 확률만 믿을 수는 없습니다.
| 조심할 점 | 까닭 |
|---|---|
| 시험지가 작다 | 360장이라 한 장만 더 틀려도 정확도가 0.3%p 쯤 바뀐다. 나누는 씨앗을 바꾸면 숫자가 달라진다 |
| 그림이 거칠다 | 8×8 칸, 점 64개뿐이라 사람에게도 헷갈리는 그림이 섞여 있다 |
| 모양의 위치를 직접 보지 않는다 | 칸 64개를 한 줄로 펴서 보므로 "위에 고리가 있다" 같은 위치 관계를 바로 쓰지 못한다 |
정리하면, 층 두 개짜리 작은 신경망도 손글씨 숫자를 97% 맞힐 만큼 쓸모가 있고, 남은 실수는 거친 그림과 모양을 보지 못하는 구조에서 옵니다.
이 프로젝트가 뜻하는 것
이 프로젝트는 우체국 신입 직원에게 손글씨 숫자 읽기를 가르치는 일과 같습니다. 연습 카드를 꺼내 몇 장 보고(1단계), 진하기를 고르게 맞춰 연습용과 시험용으로 나누고(2단계), 카드를 보고 0~9 가운데 하나를 고르도록 가르치고(3단계), 시험을 본 뒤 무엇을 무엇으로 읽었는지 표로 세고(4단계), 틀린 카드를 직접 보고(5단계), 숫자마다의 실력과 얼마나 확신했는지를 봅니다(6단계). 여기서 연습 카드가 load_digits 의 그림, 직원이 분류 신경망, "무엇을 무엇으로 읽었나" 표가 혼동행렬입니다. 숫자를 읽는 자세한 방법은 바로 위 "결과를 어떻게 읽나"에 있으므로 여기서는 출력의 뜻만 짧게 짚습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 불러오기 | (1797, 64) (1797,) | 그림 1,797장이 칸 64개씩의 숫자로 들어 있고, 정답도 1,797개입니다 |
| 2. 나누기 | [1437, 64], [360, 64] | 학습용 1,437장, 시험용 360장으로 나눴습니다 |
| 3. 학습 | 손실 0.5397 → 0.0274 → 0.0050 | 30 에포크 동안 마지막 배치의 손실이 꾸준히 줄었습니다 |
| 4. 정확도 | 0.969 | 시험용 360장 가운데 349장을 맞혔습니다 |
| 5. 틀린 그림 | 11 장 | 틀린 그림은 가운데가 좁은 8, 고리가 열린 9 처럼 사람도 헷갈릴 만한 그림이었습니다 |
| 6. 학습용 정확도 | 1.0 | 연습 카드는 모두 맞힙니다. 시험과의 차이는 3%p 남짓입니다 |
| 6. 숫자별 | 8 이 0.886 | 2, 3, 5, 7 은 다 맞혔고 8 이 가장 약합니다 |
| 6. 확신 정도 | 맞힘 0.986, 틀림 0.747, 0.9 넘게 틀린 4장 | 틀릴 때는 대체로 덜 확신하지만, 크게 확신하고 틀린 그림도 있습니다 |
한 줄로 줄이면, 실습에서 배운 학습 루프를 분류 문제로 바꿔 손글씨 숫자를 97%쯤 맞힌 프로젝트입니다. 360장으로 한 번 나눈 결과라 한 장만 달라져도 정확도가 0.3%p 쯤 바뀌고, 8×8 칸의 거친 그림이라 더 큰 실제 손글씨에서 같은 점수가 나온다는 뜻은 아닙니다.