16장. vLLM 서빙 벤치마킹과 RAG 최적화
실습 2 — 동시 요청을 늘려 가며 재기
사용자 여럿이 한꺼번에 묻는 상황을 흉내 내어, Ollama 서버에 동시에 1, 2, 4, 8개씩 요청을 보내고 처리량과 지연의 p50, p95 를 잽니다. 요청마다 출력 길이를 64토큰으로 맞춥니다. 실습 1과 같은 준비를 하고, 요청은 파이썬의 스레드로 동시에 보냅니다.
1단계. 준비(실습 1과 같은 함수)
import json, re, time, urllib.request, urllib.error

HOST = "http://127.0.0.1:11434"
MODEL = "qwen2.5:3b"


def post(path, body):
    req = urllib.request.Request(HOST + path, data=json.dumps(body).encode(), headers={"Content-Type": "application/json"})
    return json.loads(urllib.request.urlopen(req, timeout=300).read())


def unload_all():
    for m in json.loads(urllib.request.urlopen(HOST + "/api/ps").read())["models"]:
        post("/api/generate", {"model": m["name"], "keep_alive": 0})


BROKEN = re.compile(r"(.)\1{9,}")


def stream_chat(messages, num_predict=80, model=MODEL):
    """실습 1과 같은 함수: 스트리밍으로 TTFT, 지연, 출력 토큰 수를 잰다"""
    body = {"model": model, "messages": messages, "stream": True,
            "options": {"temperature": 0, "seed": 42, "num_predict": num_predict}}
    for _ in range(3):
        req = urllib.request.Request(HOST + "/api/chat", data=json.dumps(body).encode(),
                                     headers={"Content-Type": "application/json"})
        start, first, text, last = time.perf_counter(), None, "", {}
        try:
            with urllib.request.urlopen(req, timeout=300) as r:
                for line in r:
                    d = json.loads(line)
                    piece = d.get("message", {}).get("content", "")
                    if piece and first is None:
                        first = time.perf_counter() - start
                    text += piece
                    if d.get("done"):
                        last = d
        except urllib.error.HTTPError:
            last = {}
        if last and not BROKEN.search(text):
            break
        post("/api/generate", {"model": model, "keep_alive": 0})
    total = time.perf_counter() - start
    n = last["eval_count"]
    return {"답": text.strip(), "TTFT": first, "지연": total, "출력토큰": n}


# 벤치마크 질문: 7차시 규정 질문 16개. 세 문장으로 설명하게 해서 64토큰을 다 쓰게 한다
questions = [json.loads(l)["질문"] for l in open("company_rules_qa.jsonl", encoding="utf-8")][:16]
prompts = [[{"role": "user", "content": f"회사 규정에 대한 질문입니다. 세 문장으로 설명해 주세요.\n{q}"}] for q in questions]

unload_all()
stream_chat(prompts[0], num_predict=8)           # 몸풀기: 모델을 GPU 에 올려 둔다
print(len(prompts), "개 질문 준비")16 개 질문 준비2단계. 동시성 하나를 재는 함수
import numpy as np
from concurrent.futures import ThreadPoolExecutor


def bench(concurrency, n_tokens=64):
    """요청 16개를 concurrency 개씩 동시에 보내고 처리량과 지연의 분포를 잰다"""
    start = time.perf_counter()
    # ThreadPoolExecutor(max_workers=c): 스레드 c 개가 요청을 나눠 보낸다 = 동시에 c 개가 서버에 가 있다
    with ThreadPoolExecutor(max_workers=concurrency) as ex:
        results = list(ex.map(lambda m: stream_chat(m, num_predict=n_tokens), prompts))
    wall = time.perf_counter() - start                     # 16개를 다 받기까지 걸린 시간
    lat = np.array([r["지연"] for r in results])
    ttft = np.array([r["TTFT"] for r in results])
    tokens = sum(r["출력토큰"] for r in results)
    return {"동시성": concurrency, "걸린 시간(초)": round(wall, 1), "처리량(토큰/초)": round(tokens / wall, 1),
            # float(): NumPy 의 숫자를 파이썬 숫자로 바꿔 출력을 깔끔하게 한다
            "TTFT p50": round(float(np.percentile(ttft, 50)), 2), "TTFT p95": round(float(np.percentile(ttft, 95)), 2),
            "지연 p50": round(float(np.percentile(lat, 50)), 2), "지연 p95": round(float(np.percentile(lat, 95)), 2)}


# 결과: 동시성 1 의 처리량과 지연
print(bench(1)){'동시성': 1, '걸린 시간(초)': 22.2, '처리량(토큰/초)': 45.1, 'TTFT p50': 0.13, 'TTFT p95': 0.16, '지연 p50': 1.42, '지연 p95': 1.45}3단계. 동시성을 늘려 가며 재기
import pandas as pd

rows = [bench(c) for c in [1, 2, 4, 8]]
table = pd.DataFrame(rows)
# 결과: 동시성마다 처리량, TTFT 와 지연의 p50·p95
print(table.to_string(index=False)) 동시성 걸린 시간(초) 처리량(토큰/초) TTFT p50 TTFT p95 지연 p50 지연 p95
1 20.8 47.7 0.04 0.11 1.33 1.40
2 20.5 48.3 1.34 1.45 2.63 2.73
4 26.5 36.3 3.78 4.10 4.95 5.38
8 22.1 45.3 9.66 9.95 10.95 11.214단계. 그래프로 보기
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = "Malgun Gothic"        # 한글 글꼴
plt.rcParams["axes.unicode_minus"] = False

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))
ax1.plot(table["동시성"], table["처리량(토큰/초)"], marker="o")
ax1.set_xlabel("동시 요청 수"); ax1.set_ylabel("처리량(토큰/초)"); ax1.set_title("처리량")
ax1.set_ylim(0, table["처리량(토큰/초)"].max() * 1.3)
ax2.plot(table["동시성"], table["지연 p50"], marker="o", label="지연 p50")
ax2.plot(table["동시성"], table["지연 p95"], marker="o", label="지연 p95")
ax2.plot(table["동시성"], table["TTFT p95"], marker="o", label="TTFT p95")
ax2.set_xlabel("동시 요청 수"); ax2.set_ylabel("초"); ax2.set_title("지연"); ax2.legend()
plt.tight_layout()
plt.show()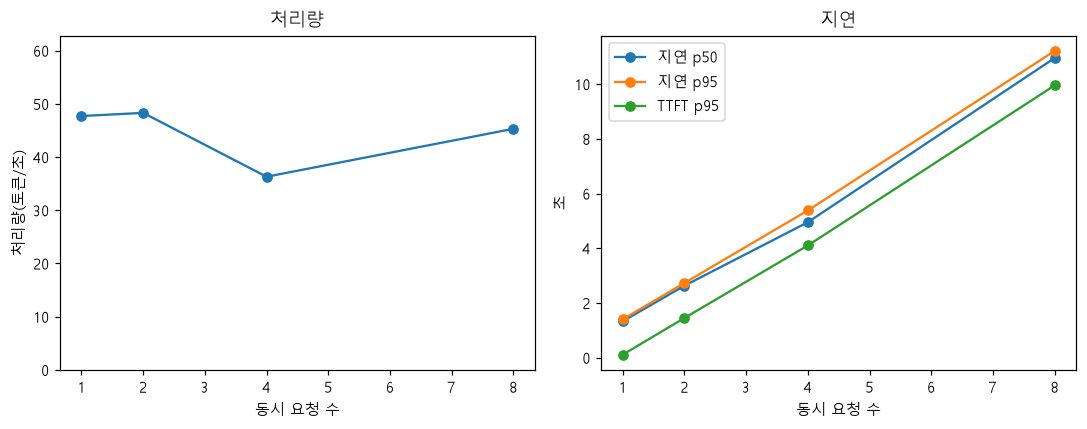
이 실습이 뜻하는 것
이 실습은 계산대가 하나뿐인 가게에 손님이 한꺼번에 몰리면 어떻게 되는지 재 보는 일과 같습니다. 손님 16명을 세워 두고 계산원을 먼저 출근시킵니다(1단계). 한 명씩 차례로 계산할 때의 빠르기를 재고(2단계), 1명, 2명, 4명, 8명이 한꺼번에 계산대에 올 때를 차례로 잽니다(3단계). 마지막으로 그 결과를 그래프로 봅니다(4단계). 여기서 계산대가 Ollama 서버, 손님이 요청, 한꺼번에 오는 손님 수가 동시성, 1초에 계산해 내는 양이 처리량, 손님 한 명이 기다린 시간이 지연입니다. 실제 가게라면 계산대를 늘릴 수 있지만, 이 실습에서는 서버 설정을 바꾸지 않았습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | 16 개 질문 준비 | 규정 질문 16개를 보낼 준비를 하고, 모델을 미리 올려 두었습니다 |
| 2. 동시성 1 | 처리량 45.1 · 지연 p50 1.42초 | 한 명씩 보내면 1초에 약 45토큰을 만들고, 요청 하나에 1.4초쯤 걸립니다. p50 은 50% 자리 값, 곧 가운데 값입니다 |
| 3. 처리량 | 47.7, 48.3, 36.3, 45.3 토큰/초 | 한꺼번에 보내는 수를 여덟 배로 늘려도 처리량은 늘지 않았습니다. 36.3 은 그 사이 다른 일로 느려진 흔들림으로 보입니다 |
| 3. 지연 p50 | 1.33, 2.63, 4.95, 10.95초 | 한꺼번에 많이 보낼수록 요청 하나가 끝나는 시간이 거의 비례해 늘었습니다. 서버 앞에서 줄을 서기 때문입니다 |
| 3. TTFT p95 | 0.11초 → 9.95초 | p95 는 느린 쪽 5% 가 시작되는 자리 값입니다. 8명이 함께 물으면 늦은 사람은 첫 글자를 10초 가까이 기다립니다 |
| 4. 그래프 | 처리량 그래프와 지연 그래프 | 왼쪽의 처리량은 제자리이고, 오른쪽의 세 선(지연 p50, 지연 p95, TTFT p95)은 함께 오릅니다 |
한 줄로 줄이면, 이 PC 의 Ollama 는 요청을 하나씩 처리해서 사람이 늘면 처리량은 그대로이고 기다림만 길어진다는 것을 보인 실습입니다. 여러 요청을 묶어서 처리하면 어떻게 달라지는지는 실습 3에서 봅니다. Ollama 의 기본 설정과 이 PC 에서 잰 숫자라, 설정을 바꾸거나 다른 서버에서 재면 결과가 다를 수 있습니다.
코드 설명
ThreadPoolExecutor(max_workers=c)의map은 스레드 c 개가 요청 16개를 나눠 보내게 합니다. 요청은 서버의 답을 기다리는 시간이 대부분이라 파이썬의 스레드로도 동시에 보낼 수 있습니다.np.percentile로 지연과 TTFT 의 50%, 95% 자리 값을 구했습니다.- 3단계의 처리량은 동시성 1, 2, 4, 8 에서 47.7, 48.3, 36.3, 45.3 토큰/초로 늘지 않았습니다. 16개를 다 받는 시간도 20~27초로 비슷했습니다. 이 PC 의 Ollama 가 요청을 하나씩 처리하기 때문입니다. 동시성 4 가 낮게 나온 것은 그 사이 다른 일로 느려진 한 번의 흔들림으로 보이며, 2단계의 동시성 1(45.1)과 3단계의 동시성 1(47.7)이 다른 것도 같은 흔들림입니다.
- 대신 지연이 늘었습니다. 지연 p50 은 1.33, 2.63, 4.95, 10.95초로 동시성에 거의 비례했고, TTFT p95 도 0.11초에서 9.95초가 되었습니다. 동시에 8명이 물으면 마지막 사람은 앞의 7명이 끝날 때까지 줄을 서서 첫 글자를 10초 가까이 기다립니다. 오른쪽 그래프의 세 선이 함께 오르는 것이 이 줄서기입니다.
- 처리량은 그대로이고 지연만 느는 것이 "하나씩" 처리하는 서버의 모습입니다. 사용자가 몇 명뿐이면 괜찮지만, 동시 사용자가 늘면 배치로 묶어 처리하는 엔진(실습 3, vLLM)이 필요합니다. 이 PC 에서는 Ollama 서버의 설정(
OLLAMA_NUM_PARALLEL)을 바꾸지 않았습니다.