16장. vLLM 서빙 벤치마킹과 RAG 최적화
실습 3 — 묶어서 생성하면 얼마나 빨라지나
서빙 엔진이 처리량을 높이는 핵심인 배치를 transformers 로 직접 확인합니다. Qwen2.5-0.5B-Instruct 를 GPU 에 fp16 으로 올리고, 같은 질문을 1개부터 32개까지 묶어 한 번에 생성하며 처리량과 메모리를 잽니다. GPU 를 혼자 쓰도록 먼저 Ollama 의 모델을 내립니다.
1단계. 모델 올리기
import json, time, urllib.request
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

# Ollama 가 올려 둔 모델을 내려 GPU 를 비운다
for m in json.loads(urllib.request.urlopen("http://127.0.0.1:11434/api/ps").read())["models"]:
    urllib.request.urlopen(urllib.request.Request("http://127.0.0.1:11434/api/generate",
                           data=json.dumps({"model": m["name"], "keep_alive": 0}).encode()))

name = "Qwen/Qwen2.5-0.5B-Instruct"
tok = AutoTokenizer.from_pretrained(name)
# padding_side="left": 길이가 다른 문장을 묶을 때 빈칸을 왼쪽에 채운다(생성은 오른쪽 끝에서 이어 가므로)
tok.padding_side = "left"
model = AutoModelForCausalLM.from_pretrained(name, dtype=torch.float16).to("cuda").eval()

questions = [json.loads(l)["질문"] for l in open("company_rules_qa.jsonl", encoding="utf-8")]
questions = (questions * 2)[:32]                     # 32개가 되게 두 번 이어 붙인다
texts = [tok.apply_chat_template([{"role": "user", "content": q}], tokenize=False, add_generation_prompt=True)
         for q in questions]
print(torch.cuda.get_device_name(0), "·", len(texts), "개 질문")NVIDIA GeForce GTX 1650 · 32 개 질문2단계. 묶음 하나를 생성하는 함수
NEW = 64                                              # 요청마다 새로 만들 토큰 수


def gen_batch(batch):
    """문장 묶음을 한 번의 generate 로 만들고 걸린 시간을 잰다"""
    x = tok(batch, return_tensors="pt", padding=True).to("cuda")
    torch.cuda.synchronize()                          # GPU 일이 끝날 때까지 기다린 뒤 시각을 잰다
    start = time.perf_counter()
    with torch.no_grad():
        # min_new_tokens 와 max_new_tokens 를 같게: 모든 요청이 꼭 64토큰을 만들게 해 공정하게 잰다
        out = model.generate(**x, max_new_tokens=NEW, min_new_tokens=NEW, do_sample=False)
    torch.cuda.synchronize()
    return time.perf_counter() - start, out[:, x["input_ids"].shape[1]:]


gen_batch(texts[:2])                                  # 몸풀기: 첫 generate 는 준비 시간이 섞인다
sec, out = gen_batch(texts[:1])
# 결과: 요청 하나를 만드는 데 걸린 시간과 앞부분
print(f"{sec:.2f}초 ·", tok.decode(out[0], skip_special_tokens=True)[:60])3.58초 · 네, 출근 시간을 늦추는 것은 불법입니다. 출근 시간이 너무 빠르면 인사와 관계를 허용하지 못할 수 있습니다3단계. 묶음 크기를 늘려 가며 재기
import pandas as pd

rows = []
for bs in [1, 2, 4, 8, 16, 32]:
    torch.cuda.reset_peak_memory_stats()               # 묶음마다 가장 많이 쓴 메모리를 새로 잰다
    sec, _ = gen_batch(texts[:bs])
    rows.append({"묶음 크기": bs, "걸린 시간(초)": round(sec, 2), "처리량(토큰/초)": round(bs * NEW / sec, 1),
                 "요청 하나의 지연(초)": round(sec, 2), "최대 메모리(MB)": torch.cuda.max_memory_allocated() // 2**20})
table = pd.DataFrame(rows)
# 결과: 묶음이 커질수록 처리량이 늘고, 지연과 메모리는 조금씩 는다
print(table.to_string(index=False)) 묶음 크기 걸린 시간(초) 처리량(토큰/초) 요청 하나의 지연(초) 최대 메모리(MB)
1 3.60 17.8 3.60 964
2 4.12 31.1 4.12 968
4 4.13 62.0 4.13 977
8 4.60 111.3 4.60 995
16 5.87 174.4 5.87 1031
32 10.96 186.9 10.96 11044단계. 그래프로 보고 GPU 비우기
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(table["묶음 크기"], table["처리량(토큰/초)"], marker="o")
ax.set_xscale("log", base=2)                         # 1, 2, 4, … 가 같은 간격으로 보이게 한다
ax.set_xticks(table["묶음 크기"]); ax.set_xticklabels(table["묶음 크기"])
ax.set_xlabel("묶음 크기(한 번에 생성한 요청 수)"); ax.set_ylabel("처리량(토큰/초)")
ax.set_title("묶어서 생성할 때의 처리량")
plt.tight_layout()
plt.show()

# 다음 실습의 Ollama 가 GPU 를 쓸 수 있게 모델을 지우고 메모리를 돌려준다
del model
torch.cuda.empty_cache()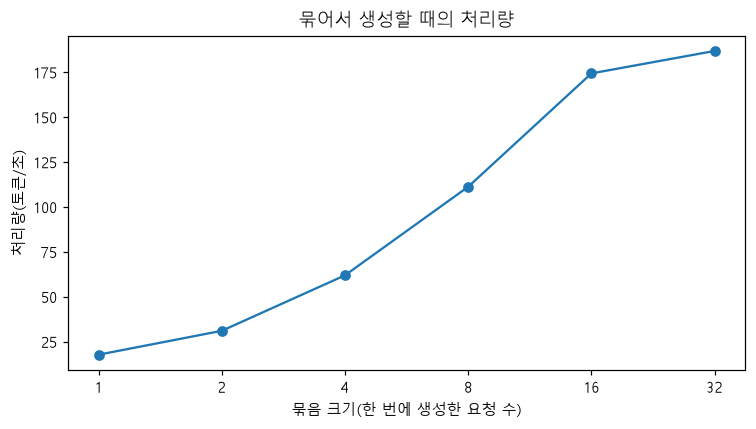
이 실습이 뜻하는 것
이 실습은 오븐에 빵을 한 판에 몇 개씩 올려 굽느냐에 따라 한 시간에 구워 내는 빵이 얼마나 달라지는지 재는 일과 같습니다. 오븐을 비우고 반죽 32개를 준비합니다(1단계). 한 판을 굽는 방법을 정하고 시험 삼아 한 번 굽습니다(2단계). 한 판에 1개부터 32개까지 올려 가며 굽는 시간과 차지하는 자리를 재고(3단계), 그래프로 본 뒤 오븐을 비웁니다(4단계). 여기서 오븐이 GPU, 한 판이 배치(묶음), 빵 하나가 요청 하나, 한 시간에 구운 빵 수가 처리량입니다. 실제 오븐과 다른 점은, 판에 많이 올릴수록 한 판 굽는 시간도 조금씩 길어지고 판마다 더 많은 메모리를 차지한다는 것입니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 모델 올리기 | NVIDIA GeForce GTX 1650 · 32 개 질문 | 이 PC 의 GPU 에 모델을 올렸고, 규정 질문 목록을 두 번 이어 붙여 32개를 만들었습니다 |
| 2. 묶음 하나 | 3.58초 · 네, 출근 시간을 늦추는 것은 불법입니다… | 요청 하나로 64토큰을 만드는 데 3.58초가 걸렸습니다. 답이 엉뚱한 것은 규정 없이 질문만 주었기 때문이고, 이 실습은 속도만 봅니다 |
| 3. 처리량 | 17.8 → 31.1 → 111.3 → 186.9 토큰/초 | 묶음 크기가 1, 2, 8, 32 로 커질수록 같은 시간에 훨씬 많이 만듭니다. 32개 묶음은 1개일 때의 약 10.5배입니다 |
| 3. 걸린 시간 | 3.60초 → 10.96초 | 32개를 함께 만드는 시간은 1개를 만드는 시간의 약 세 배입니다. 대신 요청 하나하나는 더 오래 기다립니다 |
| 3. 최대 메모리 | 964MB → 1104MB | 묶음이 커지면 메모리를 약 140MB(MB 는 megabyte) 더 썼습니다. 늘어난 몫이 KV 캐시(Key-Value cache, 앞 토큰의 계산을 저장해 둔 곳)입니다 |
| 3. 16에서 32로 | 174.4 → 186.9 토큰/초 | 묶음을 두 배로 늘려도 처리량은 조금만 늘었습니다. 이 GPU 의 계산 능력이 거의 찬 것입니다 |
| 4. 그래프 | 묶음 크기와 처리량의 꺾은선 | 처리량이 묶음 크기를 따라 오르다가 16 에서 32 사이에서 거의 평평해지는 모습을 한눈에 보여 줍니다 |
한 줄로 줄이면, 묶어서 만들면 같은 시간에 열 배 넘게 만들 수 있지만, 요청 하나가 기다리는 시간과 메모리도 함께 는다는 것을 보인 실습입니다. 하나씩 처리해 처리량이 늘지 않던 실습 2와 반대되는 결과입니다. 다만 이것은 정해진 묶음을 한꺼번에 만드는 정적 배치입니다. 요청이 제각각 들어오는 실제 서비스에서는 vLLM 같은 엔진이 연속 배치로 이 이점을 얻으며, 이 장에서 vLLM 은 실행하지 않고 안내 코드로만 다룹니다.
코드 설명
- 길이가 다른 질문을 한 텐서로 묶으려면 짧은 쪽을 빈칸(패딩)으로 채워야 합니다. 생성은 오른쪽 끝에서 이어 쓰므로
padding_side = "left"로 빈칸을 왼쪽에 둡니다.min_new_tokens와max_new_tokens를 같게 주어 모든 요청이 꼭 64토큰을 만들게 했습니다. 2단계의 답이 엉뚱한 것은 규정 없이 질문만 주었기 때문이고, 이 실습은 속도만 봅니다. - 묶음 크기 1에서 17.8 토큰/초이던 처리량이 2에서 31.1, 8에서 111.3, 32에서 186.9 로 늘었습니다. 32개를 묶어 만드는 시간(10.96초)이 하나를 만드는 시간(3.60초)의 세 배뿐이라, 같은 시간에 열 배 넘게 만든 셈입니다. 디코드는 가중치를 읽어 오는 데 시간이 들고, 한 번 읽은 가중치로 여러 요청을 함께 계산하면 그 비용을 나눠 내기 때문입니다.
- 묶음이 커지면 요청 하나의 지연도 3.60초에서 10.96초로 늘고, 최대 메모리는 964MB 에서 1,104MB 로 늘었습니다. 늘어난 몫이 KV 캐시입니다. 16에서 32 로 갈 때는 처리량이 174 에서 187 로 조금만 늘어, 이 GPU 의 계산 능력이 거의 찼습니다.
- 이것은 정해진 묶음을 한꺼번에 만드는 정적 배치입니다. 실제 서비스에서는 요청이 제각각 들어오고 답 길이도 달라서, vLLM 같은 엔진이 연속 배치로 끝난 자리를 바로 채워 이 처리량을 지연을 덜 늘리며 얻습니다. 같은 0.5B 를 Ollama 로 하나씩 만들 때(15장 실습 3, 153 토큰/초)보다 transformers 의 묶음 1이 느린 것은 엔진의 차이입니다.