16장. vLLM 서빙 벤치마킹과 RAG 최적화
실습 4 — 느린 RAG 의 병목 찾기
일부러 느리게 만든 사내 규정 RAG 를 단계마다 재어 병목을 찾습니다. 이 RAG 는 질문마다 조항 30개를 다시 임베딩하고, 조항 30개를 모두 재정렬하고, 조각 8개를 붙여, 자세히 답하게 합니다. 임베딩과 재정렬은 7장의 두 모델을 CPU 에서, 생성은 Ollama 의 qwen2.5:3b 로 합니다. 질문은 7장의 25개입니다.
1단계. 준비
import json, re, time, urllib.request, urllib.error
import numpy as np
from sentence_transformers import SentenceTransformer, CrossEncoder

HOST = "http://127.0.0.1:11434"
MODEL = "qwen2.5:3b"
BROKEN = re.compile(r"(.)\1{9,}")
retried = {"수": 0}


def post(path, body):
    req = urllib.request.Request(HOST + path, data=json.dumps(body).encode(), headers={"Content-Type": "application/json"})
    return json.loads(urllib.request.urlopen(req, timeout=300).read())


def unload_all():
    for m in json.loads(urllib.request.urlopen(HOST + "/api/ps").read())["models"]:
        post("/api/generate", {"model": m["name"], "keep_alive": 0})


def chat(messages, num_predict):
    """답과 Ollama 가 잰 숫자를 돌려준다. 서버 오류나 깨진 답이면 모델을 내렸다 두 번까지 다시 묻는다"""
    for _ in range(3):
        try:
            r = post("/api/chat", {"model": MODEL, "stream": False, "messages": messages,
                                   "options": {"temperature": 0, "seed": 42, "num_predict": num_predict}})
            if not BROKEN.search(r["message"]["content"]):
                return r
        except urllib.error.HTTPError:
            pass
        retried["수"] += 1
        post("/api/generate", {"model": MODEL, "keep_alive": 0})
    return r


def correct(answer, key):
    """정답열쇠(세로줄로 나눈 여러 낱말) 가운데 하나라도 답에 들어 있으면 맞힘"""
    return any(k in answer.replace(" ", "") for k in key.replace(" ", "").split("|"))


articles = [l.strip() for l in open("company_rules.txt", encoding="utf-8") if re.match(r"^제\d+조\(", l)]
qa = [json.loads(l) for l in open("company_rules_qa.jsonl", encoding="utf-8")]
SYSTEM = "당신은 솔내기술(가상 회사)의 규정 도우미입니다. [조항]에 있는 내용만으로 답하세요."

# 모델 불러오기는 처음 한 번만 드는 시간이라 따로 잰다
start = time.perf_counter()
emb = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")     # GPU 는 Ollama 에 비워 둔다
ce = CrossEncoder("cross-encoder/mmarco-mMiniLMv2-L12-H384-v1", device="cpu")
unload_all()
chat([{"role": "user", "content": "안녕"}], 5)                                 # 몸풀기: 생성 모델을 올려 둔다
print(f"모델 불러오기 {time.perf_counter() - start:.1f}초 · 조항 {len(articles)}개 · 질문 {len(qa)}개")모델 불러오기 14.8초 · 조항 30개 · 질문 25개2단계. 느린 RAG 를 단계마다 재기
def slow_rag(q):
    """일부러 느리게 만든 RAG. 단계마다 걸린 시간을 t 에 적는다"""
    t = {}
    s = time.perf_counter()
    # 1 색인: 질문마다 조항 30개를 다시 임베딩한다(낭비)
    A = emb.encode(["passage: " + a for a in articles], normalize_embeddings=True)
    t["색인"] = time.perf_counter() - s; s = time.perf_counter()
    # 2 검색: 질문을 임베딩해 모든 조항과의 가까움(내적)으로 줄 세운다
    qv = emb.encode(["query: " + q], normalize_embeddings=True)[0]
    cand = np.argsort(-(A @ qv))
    t["검색"] = time.perf_counter() - s; s = time.perf_counter()
    # 3 재정렬: 조항 30개를 모두 크로스 인코더에 넣는다(낭비)
    scores = ce.predict([(q, articles[i]) for i in cand])
    cand = cand[np.argsort(-scores)]
    t["재정렬"] = time.perf_counter() - s; s = time.perf_counter()
    # 4 생성: 조각 8개를 붙이고 자세히 설명하게 한다(입력도 출력도 길다)
    ctx = "\n".join(articles[i] for i in cand[:8])
    r = chat([{"role": "system", "content": SYSTEM},
              {"role": "user", "content": f"[조항]\n{ctx}\n\n[질문]\n{q}\n자세히 설명해 주세요."}], num_predict=300)
    t["생성"] = time.perf_counter() - s
    return r["message"]["content"].strip(), t, r["prompt_eval_count"], r["eval_count"]


answer, t, n_in, n_out = slow_rag(qa[0]["질문"])
# 결과: 질문 하나의 단계별 시간(초)과 입력·출력 토큰 수
print({k: round(v, 2) for k, v in t.items()}, "· 입력", n_in, "· 출력", n_out)
print(answer[:120]){'색인': 0.67, '검색': 0.03, '재정렬': 0.67, '생성': 3.91} · 입력 541 · 출력 83
[조항] 제2조(유연 근무)에 따르면, 오전 7시에서 10시 사이에 출근 시각을 선택할 수 있습니다. 이 조항은 유연 근무를 허용하며, 근무 시간을 늦출 수 있게 합니다. 따라서 출근 시간을 늦출 수 있습니다.3단계. 질문 25개로 병목 찾기
import pandas as pd

rows = []
for x in qa:
    a, t, n_in, n_out = slow_rag(x["질문"])
    rows.append({**t, "전체": sum(t.values()), "입력토큰": n_in, "출력토큰": n_out, "정답": correct(a, x["정답열쇠"])})
slow = pd.DataFrame(rows)
stages = ["색인", "검색", "재정렬", "생성"]
summary = pd.DataFrame({"평균(초)": slow[stages].mean().round(3), "몫": (slow[stages].sum() / slow["전체"].sum()).round(3)})
# 결과: 단계마다 평균 시간과 전체에서의 몫
print(summary.to_string())
print(f"질문 하나 평균 {slow['전체'].mean():.2f}초 · p95 {slow['전체'].quantile(0.95):.2f}초 · "
      f"평균 입력 {slow['입력토큰'].mean():.0f}토큰 · 평균 출력 {slow['출력토큰'].mean():.0f}토큰 · "
f"정답 {slow['정답'].sum()}/{len(qa)} · 다시 물음 {retried['수']}") 평균(초) 몫
색인 0.402 0.087
검색 0.022 0.005
재정렬 0.702 0.152
생성 3.505 0.757
질문 하나 평균 4.63초 · p95 5.74초 · 평균 입력 528토큰 · 평균 출력 75토큰 · 정답 24/25 · 다시 물음 04단계. 단계별 시간을 그래프로 보기
import matplotlib.pyplot as plt
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

fig, ax = plt.subplots(figsize=(7, 3.5))
ax.barh(stages[::-1], summary["평균(초)"][::-1])     # 위에서부터 단계 순서대로 보이게 뒤집는다
for i, v in enumerate(summary["평균(초)"][::-1]):
    ax.text(v, i, f" {v:.2f}초", va="center")
ax.set_xlabel("질문 하나의 평균 시간(초)")
ax.set_title("느린 RAG 의 단계별 시간")
ax.set_xlim(0, summary["평균(초)"].max() * 1.25)
plt.tight_layout()
plt.show()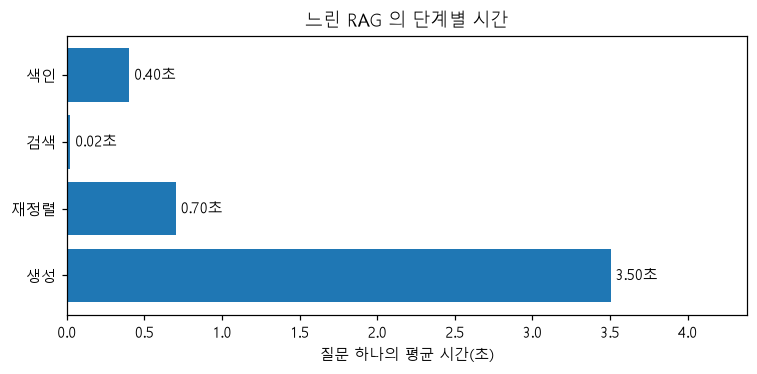
이 실습이 뜻하는 것
이 실습은 주문이 늦게 나오는 식당에서 어느 단계가 시간을 잡아먹는지 초시계로 찾는 일과 같습니다. 먼저 주방 기계를 모두 켭니다(1단계). 주문 하나를 받아 메뉴판 새로 인쇄하기, 메뉴 찾기, 후보 메뉴 모두 맛보기, 요리하기를 단계마다 잽니다(2단계). 같은 일을 주문 25개로 되풀이해 평균을 내고(3단계), 단계별 시간을 막대그래프로 봅니다(4단계). 여기서 주문마다 메뉴판을 새로 인쇄하는 일이 색인, 메뉴 찾기가 검색, 후보 30개를 모두 맛보는 일이 재정렬, 요리하기가 생성이고, 가장 오래 걸리는 단계가 병목입니다. 이 RAG(Retrieval-Augmented Generation, 검색으로 근거를 찾아 붙여 답을 만드는 방식)는 일부러 낭비하게 만든 것이라 실제 식당보다 하지 않아도 될 일이 많습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | 모델 불러오기 14.8초 · 조항 30개 · 질문 25개 | 모델 셋을 불러오는 데 15초쯤 걸렸습니다. 서버라면 처음 한 번만 드는 시간이라 질문마다의 시간에서 뺍니다 |
| 2. 질문 하나 | 색인 0.67 · 검색 0.03 · 재정렬 0.67 · 생성 3.91초 | 질문 하나만 봐도 생성이 가장 오래 걸리고, 검색은 거의 시간이 들지 않습니다 |
| 2. 토큰 수 | 입력 541 · 출력 83 | 조각 8개를 붙여 입력이 길고, "자세히"라고 해서 답도 깁니다 |
| 3. 단계별 몫 | 생성 0.757 · 재정렬 0.152 · 색인 0.087 · 검색 0.005 | 전체 시간의 4분의 3쯤이 생성입니다. 생성이 이 RAG 의 병목입니다 |
| 3. 전체 시간 | 평균 4.63초 · p95 5.74초 | 질문 하나에 평균 4.6초가 걸리고, 느린 편의 질문도 6초를 넘지 않았습니다 |
| 3. 평균 토큰 | 입력 528 · 출력 75 | 실습 1의 빠르기로 어림하면 입력에 약 2초, 출력에 약 1.5초가 들어 생성 시간과 맞습니다 |
| 3. 정답 | 정답 24/25 · 다시 물음 0 | 25개 가운데 24개를 맞혔습니다. 속도를 줄일 때 이 정답 수를 얼마나 지키는지가 기준이 됩니다 |
| 4. 그래프 | 단계별 평균 시간의 가로 막대 | 생성 막대가 가장 길고 검색 막대는 거의 보이지 않아, 어디부터 고칠지 한눈에 보입니다 |
한 줄로 줄이면, 느린 RAG 에서 시간의 대부분은 생성이 쓰고, 그다음은 할 필요가 없던 재정렬과 색인이라는 것을 찾아낸 실습입니다. 색인과 재정렬의 낭비는 실습 5에서, 생성의 입력과 출력 길이는 실습 6에서 줄이고, 프로젝트에서 이를 모두 묶어 고칩니다. 정답은 답에 열쇠 낱말이 들어 있는지만 본 것이라 24개도 답의 질을 다 보여 주지는 않습니다.
코드 설명
- 모델 셋(임베딩, 재정렬, 생성)을 불러오는 데 14.8초가 들었습니다. 서버라면 처음 한 번만 드는 시간이라 질문마다의 시간에서 뺍니다. 임베딩과 재정렬은 GPU 를 Ollama 에 비워 주려고 CPU 에서 돌립니다.
- 질문 25개의 평균은 4.63초(p95 5.74초)였고, 생성이 3.51초로 전체의 75.7%, 재정렬 0.70초(15.2%), 색인 0.40초(8.7%), 검색 0.02초(0.5%)였습니다. 가장 큰 병목은 생성이고, 질문마다 다시 하는 색인과 30개 모두의 재정렬은 할 필요가 없는 일입니다.
- 생성이 느린 것은 입력(평균 528토큰, 조각 8개)과 출력(평균 75토큰, "자세히")이 모두 길기 때문입니다. 실습 1의 숫자로 어림하면 입력에 약 2초, 출력에 약 1.5초가 듭니다.
- 정답은 25개 가운데 24개로 높았습니다. 조각을 많이 붙이고 길게 쓰게 하면 정답 낱말이 답에 들어갈 기회도 많아집니다. 그래서 속도를 줄일 때는 이 정답 수를 얼마나 지키는지 함께 봐야 합니다. 이번 실행에서 깨진 답이나 서버 오류로 다시 물은 일은 없었습니다.