5장. LoRA 파인튜닝과 DPO 정렬
메모리 아끼는 기술
작은 차에 이삿짐을 싣는다고 해 봅시다. 상자를 납작하게 접고, 자주 안 쓰는 물건은 나중에 다시 사기로 하고 버리고, 한 번에 다 못 실으면 여러 번 나눠 나릅니다. 4GB GPU 에서 5억 파라미터 모델을 학습하려면 이 세 가지를 모두 씁니다.
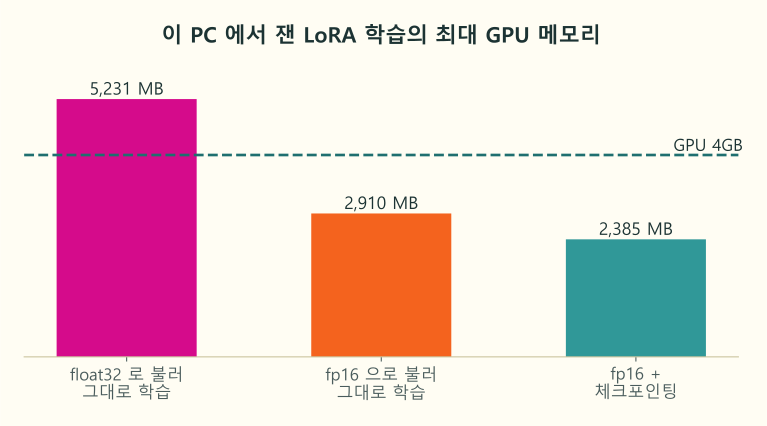
세 막대는 이 PC(GTX 1650)에서 Qwen2.5-0.5B 에 LoRA 를 붙여 배치 8로 학습할 때 잰 최대 메모리입니다. 마젠타 막대처럼 float32 로 불러오면 5,231MB 로 청록 점선(GPU 4GB)을 넘어, 오류는 나지 않았지만 시스템 메모리를 빌려 쓰느라 아주 느렸습니다. 다홍 막대처럼 fp16 으로 불러오면 2,910MB 로 들어가고, 청록 막대처럼 그래디언트 체크포인팅까지 켜면 2,385MB 로 더 줄지만 이 PC 에서는 에포크 하나가 1.5배쯤 오래 걸렸습니다. 이 장의 실습은 가운데 설정(fp16, 체크포인팅 없음)을 씁니다. 여기서 납작하게 접은 상자가 fp16, 버렸다가 다시 사기가 체크포인팅입니다.
세 가지 기술
| 기술 | 하는 일 | 이삿짐으로 치면 | 값 |
|---|---|---|---|
| fp16 으로 불러오기 | 기본 가중치를 16비트로 둔다 | 상자를 납작하게 접기 | 메모리 절반, 아주 작은 정밀도 손해 |
| 그래디언트 체크포인팅 | 순전파의 중간값을 버렸다가 역전파 때 다시 계산 | 버렸다가 다시 사기 | 메모리를 크게 줄이는 대신 30% 안팎 느려진다 |
| 배치 줄이기 | 한 번에 보는 건수를 줄인다 | 여러 번 나눠 나르기 | 메모리가 줄고 학습이 조금 흔들린다 |
혼합 정밀도(fp16=True) | 계산을 16비트로 하고 학습하는 값은 32비트 | 무거운 짐만 튼튼한 상자에 | 빠르고 메모리도 준다 |
GTX 1650 같은 Turing 세대 GPU 는 bf16(다른 16비트 형식)을 지원하지 않아 fp16 을 씁니다. 요즘 GPU 에서는 숫자가 덜 넘치는 bf16 을 더 많이 씁니다.
코드로 켜기
from transformers import TrainingArguments

args = TrainingArguments(
    "out_demo_mem",
    per_device_train_batch_size=4,             # 배치 줄이기
    fp16=False,                                # 혼합 정밀도(GPU 가 있을 때 True)
    gradient_checkpointing=True,               # 그래디언트 체크포인팅
    gradient_checkpointing_kwargs={"use_reentrant": False},   # 최근 판의 권장 방식
    report_to="none",
)
print(args.per_device_train_batch_size, args.gradient_checkpointing)
설정만 만든 것이라 학습은 하지 않습니다. 이 예는 GPU 가 없는 곳에서도 돌도록 fp16=False 로 두었고, 실습에서는 fp16=torch.cuda.is_available() 로 GPU 가 있을 때만 켭니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
TrainingArguments("out_demo_mem", ...) | 4장의 Trainer 에 줄 학습 설정을 만든다. 첫 값은 결과를 저장할 폴더 이름이다 |
per_device_train_batch_size=4 | GPU(장치) 하나가 한 번에 보는 학습 건수다. 줄이면 메모리가 준다 |
fp16=False | 혼합 정밀도를 끈다. GPU 가 없으면 켤 수 없어서 이 예에서는 꺼 두었다 |
gradient_checkpointing=True | 그래디언트 체크포인팅을 켠다. 중간값을 버렸다가 역전파 때 다시 계산한다 |
gradient_checkpointing_kwargs={"use_reentrant": False} | kwargs 는 keyword arguments(이름 붙은 인자들)의 줄임말이다. 체크포인팅에 넘길 세부 설정으로, 최근 PyTorch 가 권하는 방식을 고른다 |
report_to="none" | 학습 기록을 바깥 서비스로 보내지 않는다 |
이 코드가 뜻하는 것
이삿짐센터에 "작은 상자로, 짐은 네 개씩, 자주 안 쓰는 것은 버렸다가 다시 사기"라고 적은 작업 지시서를 건네는 일과 같습니다. 지시서만 만들었지 아직 짐을 옮기지는 않았습니다. 여기서 작업 지시서가 TrainingArguments 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
args = TrainingArguments(...) | 메모리 아끼는 설정을 담은 학습 설정을 만든다 | 작업 지시서를 쓴다 |
print(args.per_device_train_batch_size, args.gradient_checkpointing) | 지시서에 적힌 값을 다시 읽는다 | 지시서를 확인한다 |
결과 4 True 는 배치 4와 체크포인팅이 설정에 담겼다는 확인입니다.
작게 줄여서 눈으로 보기
"상자를 납작하게 접기", 곧 fp16 이 무엇을 얻고 무엇을 잃는지 숫자 세 개로 봅니다.
import torch

x32 = torch.tensor([0.1, 1000.0, 70000.0])          # float32
x16 = x32.to(torch.float16)                         # fp16 으로 바꾸기

print("숫자 하나의 바이트:", x32.element_size(), "→", x16.element_size())
print("float32:", x32.tolist())
print("fp16   :", x16.tolist())
print("fp16 이 담는 가장 큰 수:", torch.finfo(torch.float16).max)숫자 하나의 바이트: 4 → 2
float32: [0.10000000149011612, 1000.0, 70000.0]
fp16 : [0.0999755859375, 1000.0, inf]
fp16 이 담는 가장 큰 수: 65504.0| 결과 | 읽는 법 |
|---|---|
4 → 2 | 숫자 하나가 4바이트에서 2바이트로 줄었다. 모델 전체의 메모리가 절반이 되는 까닭이다 |
| 0.1 의 줄 | float32 도 0.1 을 정확히 담지 못해 0.10000000149… 로 적힌다. fp16 은 0.0999755… 로 오차가 더 크다. 이것이 "아주 작은 정밀도 손해"다 |
| 1000.0 | 이 정도 크기의 정수는 두 형식 모두 그대로 담는다 |
70000.0 → inf | fp16 이 담을 수 있는 가장 큰 수 65504 를 넘어 inf(infinity, 무한대)가 되었다. 학습 중 숫자가 이렇게 넘치면 손실이 nan 이 되기 쉽다 |
.to(torch.float16) 은 텐서를 fp16 으로 바꾸고, element_size() 는 숫자 하나의 바이트 수를, torch.finfo 는 floating point information(부동소수점 형식의 정보)으로 그 형식이 담는 가장 큰 수 같은 값을 알려 줍니다. 그래서 기본 가중치는 fp16 으로 두되, 학습하는 A, B 는 float32 로 두어 넘침을 피합니다.
주의할 점
- GPU 메모리가 모자라면 Windows 는 시스템 메모리를 빌려 쓰는데(공유 메모리), 이때 학습이 아주 느려집니다. 오류 없이 느리기만 하니
nvidia-smi로 메모리를 꼭 봅니다. - 메모리를 아끼는 기술은 대개 시간을 대가로 냅니다. 메모리가 넉넉하면 체크포인팅을 끄는 편이 빠릅니다.