5장. LoRA 파인튜닝과 DPO 정렬
LoRA 의 설정
메모지를 고를 때 두께와 붙일 쪽을 정합니다. 두꺼운 메모지는 많이 적을 수 있지만 무겁고, 모든 쪽에 붙이면 효과는 크지만 일이 많습니다. LoRA 의 설정도 이 두 가지가 핵심입니다.
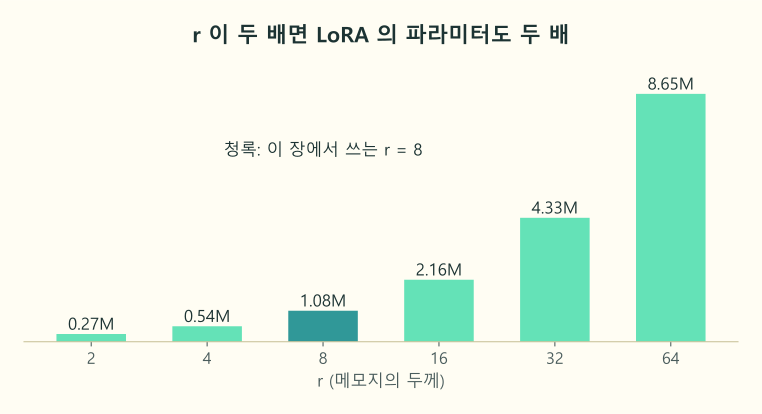
가로축이 r(메모지의 두께)이고, 막대가 Qwen2.5-0.5B 의 어텐션 층 넷(q, k, v, o)에 LoRA 를 붙였을 때 학습하는 파라미터 수입니다. r 이 두 배가 되면 파라미터도 정확히 두 배가 됩니다. 청록 막대가 이 장에서 쓰는 r = 8 로 108만 개입니다.
주요 설정
| 설정 | 뜻 | 흔한 값 | 이 장의 값 |
|---|---|---|---|
r | A, B 의 두께 | 4 ~ 64 | 8 |
lora_alpha | 더하는 값의 크기. 실제로는 alpha ÷ r 을 곱한다 | r 의 1~2배 | 16 |
lora_dropout | 학습 중 LoRA 길의 일부를 끄는 비율(과적합 막기) | 0.05 ~ 0.1 | 0.05 |
target_modules | 붙일 층의 이름 | 어텐션 층, 때로 FFN 층까지 | q_proj, k_proj, v_proj, o_proj |
task_type | 모델의 종류 | CAUSAL_LM(GPT 류) | CAUSAL_LM |
설정 만들어 보기
LoraConfig 는 모델 없이도 만들 수 있습니다.
from peft import LoraConfig

config = LoraConfig(
    r=8,                       # 메모지의 두께
    lora_alpha=16,             # 더할 때의 크기(alpha ÷ r = 2 배)
    lora_dropout=0.05,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],   # 어텐션의 네 층
    task_type="CAUSAL_LM",
)
print(config.r, config.lora_alpha, sorted(config.target_modules))
r 8, alpha 16, 대상 층 네 개가 담긴 설정이 만들어집니다. 층 이름은 모델마다 다르므로, 처음 쓰는 모델은 print(model) 로 층 이름을 확인하고 정합니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
from peft import LoraConfig | PEFT 라이브러리에서 LoRA 설정을 담는 틀을 불러온다. Config 는 configuration(설정)의 줄임말이다 |
r=8 | A, B 의 두께(rank)다. 8 이면 큰 행렬을 숫자 8개 폭으로 줄였다가 늘린다 |
lora_alpha=16 | 더하는 값의 크기다. 실제로 LoRA 길의 결과에 alpha ÷ r = 2 를 곱한다 |
lora_dropout=0.05 | dropout(떨어뜨리기)은 학습 중 LoRA 길의 숫자를 5% 씩 무작위로 0 으로 만든다. 데이터를 외워 버리는 과적합을 막는다 |
target_modules=[...] | 이름이 이 목록과 맞는 층에만 LoRA 를 붙인다 |
task_type="CAUSAL_LM" | causal language model(인과 언어 모델), 곧 앞 글자만 보고 다음 글자를 맞히는 GPT 류 모델이라고 알린다 |
sorted(config.target_modules) | 설정에 든 층 이름을 가나다(알파벳) 순으로 늘어놓는다. 설정 안에서는 순서가 정해지지 않은 묶음(집합)으로 담겨서 정렬해 찍었다 |
이 코드가 뜻하는 것
메모지를 사러 가기 전에 쓰는 장보기 목록과 같습니다. "두께 8짜리 메모지, 글씨 크기 2배, 붙일 쪽은 q·k·v·o 네 곳"을 적어 두기만 하고, 아직 책에 붙이지는 않습니다. 여기서 장보기 목록이 LoraConfig, 책이 모델입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
config = LoraConfig(...) | 설정값을 한 묶음으로 만든다 | 장보기 목록을 쓴다 |
print(config.r, config.lora_alpha, ...) | 목록에 적힌 값을 다시 읽어 찍는다 | 목록을 소리 내어 확인한다 |
결과의 8 16 ['k_proj', 'o_proj', 'q_proj', 'v_proj'] 는 적은 값이 그대로 담겼다는 확인입니다. 실제로 붙이는 일은 다음 절의 get_peft_model 이 합니다.
작게 줄여서 눈으로 보기
r 에 따라 학습하는 수가 어떻게 늘어나는지, Qwen2.5-0.5B 의 층 크기로 직접 세어 봅니다. 이 모델은 블록이 24개이고, 블록마다 q·k·v·o 네 층의 (입력, 출력) 크기가 아래 사전과 같습니다. k, v 층은 출력이 128 로 작습니다.
# Qwen2.5-0.5B 의 층 한 개 안에 있는 어텐션 층 넷의 (입력, 출력) 크기
layers = {"q_proj": (896, 896), "k_proj": (896, 128), "v_proj": (896, 128), "o_proj": (896, 896)}
n_blocks = 24                                     # 이 모델은 블록이 24개다

for r in [4, 8, 16]:
    # LoRA 는 층마다 A(입력 × r)와 B(r × 출력)를 붙인다
    per_block = sum(r * (d_in + d_out) for d_in, d_out in layers.values())
print(f"r={r:<2} 블록 하나 {per_block:>6,} 개, 모델 전체 {per_block * n_blocks:>9,} 개, alpha/r = {16 / r}")r=4 블록 하나 22,528 개, 모델 전체 540,672 개, alpha/r = 4.0
r=8 블록 하나 45,056 개, 모델 전체 1,081,344 개, alpha/r = 2.0
r=16 블록 하나 90,112 개, 모델 전체 2,162,688 개, alpha/r = 1.0| 결과 | 읽는 법 |
|---|---|
r=8 … 1,081,344 개 | 이 장에서 쓰는 설정이다. 위 그림의 청록 막대 108만 개와 같은 수다 |
| r=4, 8, 16 의 줄 | r 이 두 배가 될 때마다 학습하는 수도 정확히 두 배가 된다. 층마다 r × (입력 + 출력) 개라서 그렇다 |
alpha/r | lora_alpha 를 16 으로 두고 r 만 바꾸면 곱하는 배수가 4.0, 2.0, 1.0 으로 바뀐다. 그래서 r 을 바꿀 때 alpha 도 함께 바꿔 r 의 두 배로 맞추는 경우가 많다 |
{per_block:>6,} 은 숫자를 6칸 오른쪽 정렬로 찍고 세 자리마다 쉼표를 넣으라는 뜻입니다. 숫자 자체에는 영향이 없습니다.
주의할 점
- r 을 크게 한다고 늘 좋아지지는 않습니다. 데이터가 적으면 r 이 커도 성적은 비슷하고 과적합만 쉬워집니다. 8 이나 16 으로 시작합니다.
- 학습률은 전체 미세조정보다 크게 잡습니다. LoRA 는 1e-4 ~ 5e-4 를 흔히 씁니다.