5장. LoRA 파인튜닝과 DPO 정렬
DPO 지표 읽기
수영 강습에서 기록표를 보면 좋은 자세의 점수는 오르고 나쁜 습관의 점수는 내려가, 둘의 간격이 벌어지는 것이 보입니다. DPO 의 학습 기록도 이런 간격을 보여 줍니다.
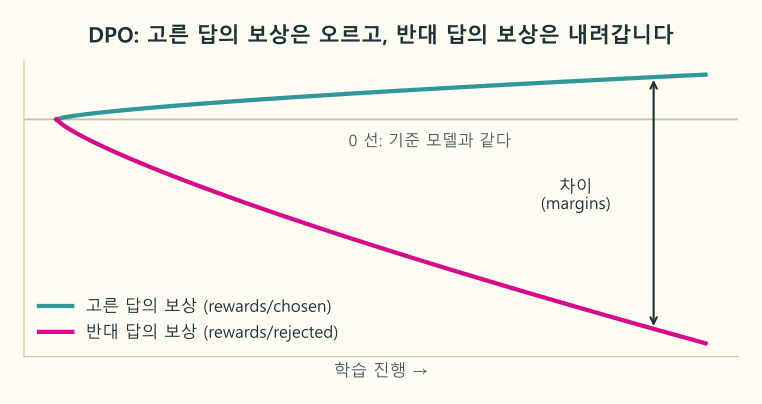
청록 선이 고른 답의 보상, 마젠타 선이 반대 답의 보상이고, 둘 사이의 간격이 차이(margins)입니다. 가운데 회색 선 0 은 기준 모델과 같다는 뜻입니다. 이 그림은 모양을 보이려고 그린 곡선이고, 실제 숫자는 실습 6의 기록에서 봅니다. 실제로는 이 장의 실습처럼 반대 답이 아주 크게 내려가고 고른 답은 조금만 움직이는 경우가 많습니다.
trl 이라는 이름 풀기
이 지표들은 trl 이 학습 중에 남깁니다. trl 은 Transformer Reinforcement Learning 의 머리글자이고, 보통 소문자로 적습니다. 우리말로 옮기면 "트랜스포머 강화학습"입니다.
| 글자 | 영어 | 뜻 |
|---|---|---|
| T | Transformer(트랜스포머) | 3장에서 본, 요즘 LLM 의 바탕이 되는 신경망 구조 |
| R | Reinforcement(강화) | 잘한 행동에 상을 주어 그 행동을 더 자주 하게 만든다는 뜻. 강아지에게 간식으로 "앉아"를 가르치는 것과 같다 |
| L | Learning(학습) | 데이터로 모델의 숫자를 고치는 일 |
trl 은 Hugging Face 가 만든 공개 라이브러리입니다. 처음에는 이름 그대로, 트랜스포머 언어모델(GPT-2)을 PPO 강화학습으로 학습시키는 도구로 시작했습니다. RLHF 를 해 보려는 사람이 많아지면서 정렬에 쓰는 학습 도구를 하나씩 더했습니다. 지금은 강화학습이 아닌 방법도 들어 있어서, 이름보다 하는 일이 넓습니다. "LLM 을 사람이 바라는 쪽으로 다듬는 학습 도구 모음"으로 이해하면 됩니다. 이 교안은 trl 1.16.0 에서 실행했습니다.
| trl 의 도구 | 하는 일 | 이 교안에서 |
|---|---|---|
SFTTrainer | 질문과 모범 답으로 지도 미세조정(SFT) | 쓰지 않는다. SFT 는 transformers 의 Trainer 로 했다(실습 3) |
DPOTrainer, DPOConfig | 선호 쌍으로 DPO 학습과 그 설정 | 실습 6, 프로젝트 |
RewardTrainer | RLHF 의 보상 모델 학습 | 쓰지 않는다 |
PPOTrainer 등 | 강화학습으로 정렬 | 쓰지 않는다 |
trl 은 transformers 의 Trainer 를 바탕으로 만들어서 쓰는 법이 비슷합니다. 설정(DPOConfig)을 만들고, 모델·데이터와 함께 DPOTrainer 에 넘긴 뒤 train() 을 부릅니다. loss 와 rewards/… 지표는 logging_steps 마다 기록됩니다. 공식 설명서는 huggingface.co/docs/trl, 코드는 github.com/huggingface/trl 에 있습니다.
trl 이 남기는 지표
| 지표 | 뜻 | 바라는 방향 |
|---|---|---|
loss | DPO 손실 | 0.693 에서 0 쪽으로 |
rewards/chosen | 고른 답의 보상 | 0 보다 크게 |
rewards/rejected | 반대 답의 보상 | 0 보다 작게 |
rewards/margins | 둘의 차이 | 커지게 |
rewards/accuracies | 고른 답의 보상이 더 큰 쌍의 비율 | 1 에 가깝게 |
# 학습 기록 한 줄의 예(설명용 숫자)
log = {"loss": 0.12, "rewards/chosen": 0.35, "rewards/rejected": -2.4,
       "rewards/margins": 2.75, "rewards/accuracies": 1.0}

ok = log["rewards/margins"] > 0 and log["rewards/accuracies"] > 0.9
print("고른 답 쪽으로 잘 기울고 있나:", ok)
print("차이 = 고른 답 - 반대 답 =", round(log["rewards/chosen"] - log["rewards/rejected"], 2))
True 가 나오고, 차이 2.75 는 두 보상의 차와 같습니다. 학습 기록에서 margins 가 오르지 않거나 accuracies 가 0.5 근처에 머물면 데이터나 학습률을 다시 봅니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
log = {"loss": 0.12, ...} | trl 이 학습 중에 남기는 기록 한 줄을 사전으로 흉내 냈다. 숫자는 설명용으로 정한 것이다 |
log["rewards/margins"] | 사전에서 이름이 rewards/margins 인 값을 꺼낸다. 이름 안의 / 는 나눗셈이 아니라 "rewards 묶음의 margins"라는 뜻의 글자다 |
A > 0 and B > 0.9 | 두 조건을 모두 만족해야 True 다. 차이가 양수이고 정확도가 0.9 를 넘는지 함께 본다 |
round(…, 2) | 소수 둘째 자리까지 줄인다. 0.35 - (-2.4) 를 계산하면 끝자리에 아주 작은 오차가 붙을 수 있어서 줄여 찍는다 |
이 코드가 뜻하는 것
수영 강습 기록표에서 두 칸만 보고 "잘 늘고 있나"를 판단하는 일과 같습니다. 좋은 자세와 나쁜 습관의 간격(margins)이 벌어졌는지, 그리고 대부분의 연습에서 좋은 자세가 이겼는지(accuracies)를 봅니다. 여기서 기록표가 trl 의 학습 기록입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
ok = ... | 차이가 양수이고 정확도가 0.9 보다 큰지 본다 | 간격이 벌어졌고, 거의 모든 연습에서 좋은 자세가 이겼나 |
log["rewards/chosen"] - log["rewards/rejected"] | 두 보상을 직접 빼 본다 | 기록표의 간격 칸이 맞게 적혔나 직접 셈해 본다 |
True 와 2.75 가 나와서, margins 는 chosen 에서 rejected 를 뺀 값이라는 것을 확인합니다. 실제 기록에서도 이 두 줄로 학습이 바른 쪽으로 가는지 빠르게 봅니다.
작게 줄여서 눈으로 보기
trl 은 쌍마다 보상을 잰 뒤 평균을 기록합니다. 쌍 넷의 로그 확률 변화를 손으로 정해 놓고, 기록의 네 지표가 어떻게 나오는지 직접 계산해 봅니다.
beta = 0.1
# 쌍 넷의 로그 확률 변화(학습 모델 - 기준 모델). 설명을 위해 손으로 정한 숫자다
changes = [  # (고른 답의 변화, 반대 답의 변화)
    (2.0, -20.0),
    (-1.0, -15.0),
    (0.5, 3.0),
    (1.0, -8.0),
]
chosen = [beta * c for c, r in changes]
rejected = [beta * r for c, r in changes]
margins = [c - r for c, r in zip(chosen, rejected)]

for i, (c, r, m) in enumerate(zip(chosen, rejected, margins), 1):
    print(f"쌍{i}: chosen {c:5.2f}, rejected {r:5.2f}, margin {m:5.2f}, 고른 답이 이김 {m > 0}")
print("rewards/chosen 평균:", round(sum(chosen) / 4, 3))
print("rewards/rejected 평균:", round(sum(rejected) / 4, 3))
print("rewards/margins 평균:", round(sum(margins) / 4, 3))
print("rewards/accuracies:", sum(m > 0 for m in margins) / 4)쌍1: chosen 0.20, rejected -2.00, margin 2.20, 고른 답이 이김 True
쌍2: chosen -0.10, rejected -1.50, margin 1.40, 고른 답이 이김 True
쌍3: chosen 0.05, rejected 0.30, margin -0.25, 고른 답이 이김 False
쌍4: chosen 0.10, rejected -0.80, margin 0.90, 고른 답이 이김 True
rewards/chosen 평균: 0.062
rewards/rejected 평균: -1.0
rewards/margins 평균: 1.062
rewards/accuracies: 0.75| 결과 | 읽는 법 |
|---|---|
| 쌍2 | 고른 답의 보상이 -0.10 으로 오히려 내려갔지만, 반대 답이 -1.50 으로 더 많이 내려가 margin 은 1.40 이다. 그래서 이긴 쌍으로 셈한다 |
| 쌍3 | 반대 답의 보상(0.30)이 고른 답(0.05)보다 커서 margin 이 -0.25 다. 넷 가운데 하나뿐인 진 쌍이다 |
| 평균 셋 | chosen 0.062, rejected -1.0, margins 1.062 다. margins 의 평균은 chosen 평균에서 rejected 평균을 뺀 것과 같다 |
rewards/accuracies: 0.75 | margin 이 양수인 쌍이 넷 가운데 셋이라 0.75 다. 정확도는 "얼마나 크게 이겼나"가 아니라 "이긴 쌍의 비율"이다 |
쌍2처럼 고른 답의 보상이 조금 내려가도 margin 이 벌어지면 손실은 줄어듭니다. 이 절의 주의할 점에 적은 "chosen 도 함께 내려가는 일"이 이런 모습입니다.
주의할 점
- 학습 기록의 지표는 학습용 쌍에서 잰 것입니다. accuracies 가 1 이어도 처음 보는 질문에서 잘한다는 보장은 없습니다. 실습 6처럼 학습에 쓰지 않은 질문으로 따로 잽니다.
- rejected 의 보상만 크게 내려가고 chosen 도 함께 내려가는 일이 있습니다. 둘 다 덜 내게 됐다는 뜻이라, 답이 이상해지지 않았는지 꼭 읽어 봅니다.