5장. LoRA 파인튜닝과 DPO 정렬
전체 미세조정의 비용
집의 분위기를 바꾸고 싶을 때 벽을 허물고 다시 짓는 리모델링도 있고, 커튼과 조명만 바꾸는 방법도 있습니다. 앞의 것은 돈과 시간이 많이 들고, 뒤의 것은 적게 들면서도 분위기는 크게 바뀝니다. 모델을 다듬을 때도 같은 선택이 있습니다.
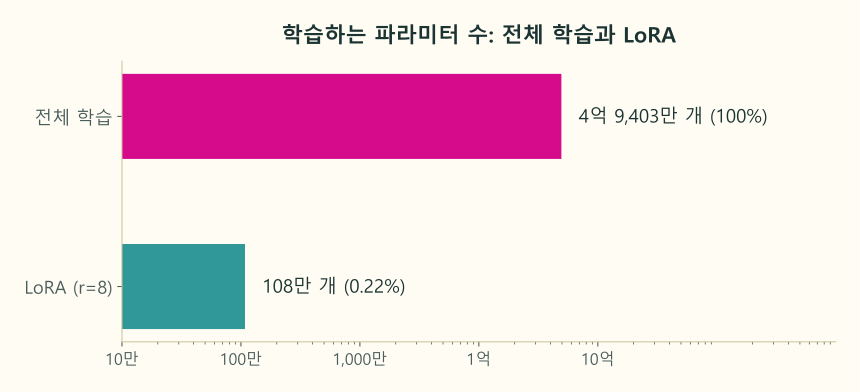
마젠타 막대가 전체 학습, 청록 막대가 LoRA(r=8)입니다. 전체 학습은 4억 9,403만 개를 모두 고치고, LoRA 는 108만 개(0.22%)만 고칩니다. 가로축이 로그 눈금이라 막대 길이는 비슷해 보여도 실제로는 450배 차이입니다. 여기서 리모델링이 전체 미세조정, 커튼과 조명이 LoRA 입니다.
무엇이 비싼가
4장의 어림대로, 전체 학습은 파라미터마다 가중치, 기울기, Adam 의 기억 두 개를 GPU 에 올려야 합니다. 학습하는 파라미터가 줄면 기울기와 Adam 의 기억도 함께 줄어듭니다.
| 항목 | 전체 학습(float32) | LoRA(r=8, 기본은 fp16) |
|---|---|---|
| 기본 가중치 | 494M × 4바이트 = 1.84GB | 494M × 2바이트 = 0.92GB |
| 기울기 | 494M × 4바이트 = 1.84GB | 1.08M × 4바이트 = 4MB |
| Adam 의 기억 | 494M × 8바이트 = 3.68GB | 1.08M × 8바이트 = 9MB |
| 합(활성화 빼고) | 7.4GB | 0.93GB |
| 저장할 파일 | 모델 전체 1GB~2GB | 어댑터만 몇 MB |
def train_gb(trainable, frozen, frozen_bytes=2):
    """학습하는 파라미터는 16바이트(가중치·기울기·Adam), 얼린 파라미터는 frozen_bytes 바이트로 셈한다."""
    return (trainable * 16 + frozen * frozen_bytes) / 1024 ** 3

total = 494_032_768
lora = 1_081_344
print(f"전체 학습: {train_gb(total, 0):.2f} GB")
print(f"LoRA 학습: {train_gb(lora, total):.2f} GB")
print(f"학습하는 비율: {lora / total:.2%}")
전체 학습은 7.36GB, LoRA 학습은 0.94GB 로 어림됩니다. 학습하는 비율은 0.22% 입니다. 실제로는 여기에 활성화 메모리가 더 붙습니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
def train_gb(trainable, frozen, frozen_bytes=2) | 학습하는 수와 얼린 수를 받아 GPU 메모리를 GB 로 어림하는 함수다. frozen_bytes=2 는 값을 주지 않으면 얼린 파라미터를 fp16(2바이트)으로 셈한다는 뜻이다 |
trainable * 16 | 학습하는 파라미터 하나에 16바이트를 셈한다. 가중치 4바이트, 기울기 4바이트, Adam 의 기억 둘 8바이트를 더한 값이다 |
frozen * frozen_bytes | 얼린 파라미터는 가중치만 있으면 된다. 기울기와 Adam 의 기억이 필요 없다 |
/ 1024 ** 3 | 바이트를 GB(기가바이트)로 바꾼다. 1GB 는 1024 × 1024 × 1024 바이트다 |
494_032_768 | 숫자 사이의 밑줄은 읽기 쉽게 끊어 쓴 것일 뿐 값에는 영향이 없다. 4억 9,403만 2,768 이다 |
f"{값:.2%}" | 소수를 백분율로 바꿔 소수 둘째 자리까지 찍는다. 0.0022 가 0.22% 로 나온다 |
이 코드가 뜻하는 것
식당 계산서를 떠올리면 쉽습니다. 메뉴마다 "개수 × 한 개 값"을 더하면 합계가 나옵니다. 이 코드도 파라미터를 학습하는 것과 얼린 것 두 메뉴로 나누고, 개수에 한 개당 바이트를 곱해 더합니다. 여기서 메뉴의 개수가 파라미터 수, 한 개 값이 바이트 수입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
train_gb(total, 0) | 모두 학습하고 얼린 것은 없다 | 비싼 메뉴(16바이트)를 4억 9천만 개 시킨다 |
train_gb(lora, total) | 108만 개만 학습하고 4억 9천만 개는 얼린다 | 비싼 메뉴는 108만 개, 싼 메뉴(2바이트)를 4억 9천만 개 시킨다 |
lora / total | 학습하는 몫의 비율을 구한다 | 비싼 메뉴가 전체 개수에서 차지하는 몫 |
결과의 7.36GB 와 0.94GB 는 위 표의 7.4GB, 0.93GB 와 같은 어림입니다(표는 항목마다 반올림해 더해서 끝자리가 조금 다릅니다). LoRA 쪽 0.94GB 는 거의 다 얼린 가중치(0.92GB)이고, 학습하는 몫은 아주 작습니다. 그래서 LoRA 에서는 "모델을 얼마나 작게 불러오느냐"가 메모리를 정합니다.
주의할 점
- LoRA 는 학습할 수 있는 양이 적어서, 모델이 전혀 모르는 큰 지식을 새로 넣는 데는 한계가 있습니다. 말투, 답의 꼴, 정해진 사실 몇 가지를 가르치는 데 알맞습니다.
- 전체 학습이 꼭 필요하면 큰 GPU 를 빌리거나, 더 작은 모델을 고릅니다.