1장. 머신러닝 프로세스와 기본 개념
과적합
기출문제 100개를 답까지 통째로 외운 학생을 떠올려 보세요. 기출문제로 다시 시험을 보면 100점입니다. 하지만 숫자만 바꾼 새 문제가 나오면 무너집니다. 머신러닝 모델도 너무 복잡하면 학습용 데이터를 외워 버립니다. 이 상태가 과적합입니다.
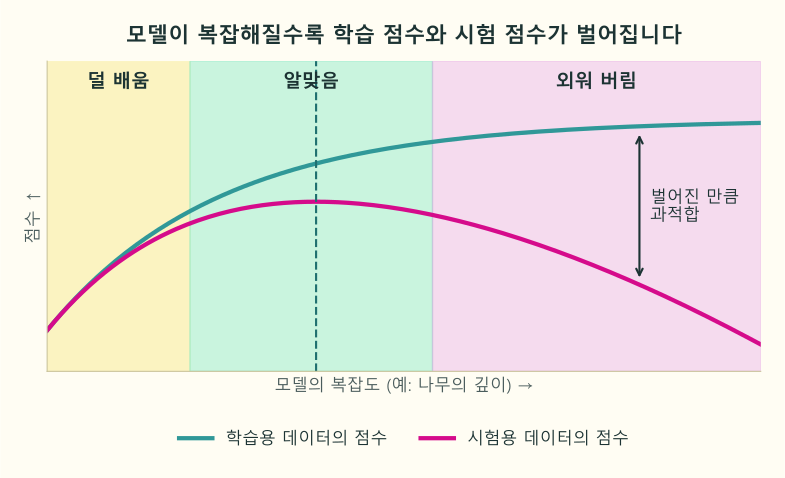
가로축은 모델이 얼마나 복잡한지, 세로축은 점수입니다. 잰 숫자가 아니라 모양을 보이려고 그린 곡선이고, 실제 숫자는 실습 6에서 확인합니다. 청록 선이 학습용 데이터의 점수, 마젠타 선이 시험용 데이터의 점수입니다. 왼쪽 "덜 배움" 구간에서는 둘 다 낮고, 가운데 "알맞음"에서 시험 점수가 가장 높습니다. 오른쪽 "외워 버림" 구간에서는 학습 점수만 계속 오르고 시험 점수는 떨어집니다. 여기서 기출문제가 학습용 데이터, 새 문제가 시험용 데이터입니다.
세 상태 알아보기
| 상태 | 학습 점수 | 시험 점수 | 시험 공부로 치면 | 손쓰는 법 |
|---|---|---|---|---|
| 덜 배움(과소적합) | 낮다 | 낮다 | 공부를 덜 했다 | 특성을 더하거나 모델을 조금 복잡하게 |
| 알맞음 | 높다 | 학습 점수와 비슷하게 높다 | 원리를 익혔다 | 이 설정을 쓴다 |
| 외워 버림(과적합) | 아주 높다 | 학습 점수보다 크게 낮다 | 답만 외웠다 | 모델을 단순하게, 데이터를 늘리기 |
의사결정나무는 어떻게 답하나
스무고개를 떠올려 보세요. "동물인가요?", "다리가 넷인가요?"처럼 예·아니요로 답할 질문을 차례로 던져 정답을 좁혀 갑니다. 의사결정나무도 같습니다. 배송 기록을 보고 "거리가 먼가?", "비가 오나?" 같은 질문을 스스로 만들고, 새 주문이 오면 그 질문을 차례로 따라가 "지연"이나 "정시"를 답합니다.
그림은 아래 예시 코드가 배송 주문 14건으로 실제로 학습한 나무입니다. 맨 위 1번이 첫 질문(뿌리), 주황 선의 2번이 "예"와 "아니요"로 갈라지는 가지, 3번이 그다음 질문, 4번처럼 더 묻지 않고 답을 내는 끝이 잎입니다. 마젠타 잎은 "지연", 청록 칠 잎은 "정시"라고 답하고, 잎 아래 글은 학습한 주문 가운데 그 잎에 닿은 주문 수입니다. 예를 들어 비 오는 날 60km 를 가는 주문은 "95km 넘나? 아니요 → 비가 오나? 예"를 지나 지연이라고 답합니다. 스무고개의 질문이 나무의 질문, 정답이 잎입니다. 스무고개와 다른 점은, 나무는 질문을 사람이 정하지 않고 데이터에서 지연과 정시를 가장 잘 가르는 질문을 골라 만든다는 것입니다.
| 부분 | 뜻 | 그림에서 |
|---|---|---|
| 뿌리 | 맨 처음 묻는 질문 | 거리가 95km 넘나? |
| 가지 | 질문의 답(예·아니요)에 따라 갈라지는 길 | 주황 선 |
| 잎 | 더 묻지 않고 답을 내는 끝 | 지연, 정시 |
| 깊이 | 뿌리에서 잎까지 이어지는 질문의 수 | 2 |
의사결정나무로 보는 과적합
max_depth 는 질문을 몇 번까지 이어 갈지(깊이) 정합니다. 깊이를 제한하지 않으면 나무는 학습용 주문을 하나도 틀리지 않을 때까지 질문을 늘립니다. 그러다 보면 주문 한 건만 가려내는 질문까지 만들어 외워 버립니다.
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, export_text

# 배송 주문 14건(설명용으로 지어낸 표). 비는 1 이 비 온 날, 0 이 안 온 날
orders = pd.DataFrame({
    "주문번호": [101, 102, 103, 104, 105, 106, 107, 108, 109, 110, 111, 112, 113, 114],
    "거리km":   [5, 180, 12, 150, 70, 90, 200, 25, 60, 80, 15, 45, 50, 100],
    "비":       [0, 0, 1, 1, 1, 0, 0, 0, 1, 0, 0, 1, 0, 1],
    "지연":     [0, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 1, 0, 1],
})
X = orders[["거리km", "비"]]   # 특성
y = orders["지연"]             # 레이블

# max_depth=2: 질문을 두 번까지만 이어 간다
tree = DecisionTreeClassifier(max_depth=2, random_state=0).fit(X, y)
# export_text: 나무가 만든 질문을 글로 보여 준다
print(export_text(tree, feature_names=["거리km", "비"]))
# 결과: 학습한 14건 가운데 맞힌 비율
print("깊이 2 · 학습 점수", round(tree.score(X, y), 3))

# max_depth=None: 깊이 제한을 푼다
deep = DecisionTreeClassifier(max_depth=None, random_state=0).fit(X, y)
# 결과: 실제로 자란 깊이, 잎의 수, 학습 점수
print("제한 없음 · 깊이", deep.get_depth(), "· 잎", deep.get_n_leaves(), "· 학습 점수", round(deep.score(X, y), 3))
깊이 2 의 나무는 위 그림의 질문 둘을 만듭니다. 출력에서 거리km <= 95.00 은 첫 질문에 "아니요"로 답한 쪽이고, 비 > 0.50 은 "비가 온다" 쪽입니다(비 열은 0 과 1 이라 0.5 를 경계로 가릅니다). 학습 점수는 0.857 로 14건 가운데 12건을 맞힙니다. 틀린 두 건은 비 오는 날인데 12km 라 제때 온 103번과, 맑은 날 15km 인데 우연히 늦은 111번입니다.
깊이 제한을 풀면 나무가 깊이 4, 잎 6개로 자라고 학습 점수는 1.000 이 됩니다. 늘어난 질문은 "거리가 10km 넘나?"(맑은 날 20km 이하에서), "거리가 28.5km 넘나?"(비 오는 날)처럼 103번과 111번 두 건만 따로 가려내는 질문입니다. 이 두 건에 맞춘 질문은 새 주문에서는 거의 도움이 되지 않습니다. 기출문제의 답을 외운 것과 같습니다.
max_depth | 질문 수 | 일어나기 쉬운 일 |
|---|---|---|
| 2 | 두 번까지 | 단순해서 덜 배울 수 있다 |
| 4 안팎 | 적당히 | 알맞을 때가 많다 |
None(제한 없음) | 끝까지 | 학습 점수 1.000, 시험 점수는 떨어진다 |
실제 배송 데이터로 깊이를 바꿔 보는 것은 실습 6에서 합니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
export_text(tree, feature_names=[...]) | 나무가 만든 질문을 글로 내보낸다. feature names(특성 이름)를 주면 질문에 열 이름이 나온다 |
max_depth=2 | max depth(최대 깊이). 질문을 많아야 두 번까지 이어 가게 한다 |
max_depth=None | None 은 "없음"이다. 깊이 제한을 두지 않는다 |
tree.score(X, y) | 학습한 14건으로 채점한 정확도다 |
deep.get_depth() | get depth(깊이 얻기). 나무가 실제로 자란 깊이를 돌려준다 |
deep.get_n_leaves() | n 은 number(개수)다. 잎(답을 내는 끝)의 개수를 돌려준다 |
이 코드가 뜻하는 것
스무고개를 두 사람에게 시킨다고 해 봅시다. 한 사람은 질문을 두 번까지만 할 수 있고, 다른 사람은 몇 번이든 할 수 있습니다. 질문이 끝없는 사람은 연습 문제 14개를 모두 맞히지만, 그중에는 "103번 문제만 가려내는 질문"처럼 다른 문제에는 쓸모없는 질문도 섞입니다. 여기서 질문 두 번짜리가 tree, 제한 없는 쪽이 deep 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
DecisionTreeClassifier(max_depth=2, ...) | 깊이 2 까지만 자라는 나무를 학습시킨다 | 질문 두 번까지만 허락한다 |
print(export_text(...)) | 나무의 질문을 글로 본다 | 어떤 질문을 골랐는지 받아 적는다 |
round(tree.score(X, y), 3) | 학습한 14건의 정확도를 본다 | 연습 문제 점수 |
DecisionTreeClassifier(max_depth=None, ...) | 제한 없이 자라는 나무를 학습시킨다 | 질문을 마음대로 하게 한다 |
deep.get_depth(), deep.get_n_leaves() | 실제 깊이와 잎 수를 센다 | 질문을 몇 번 이었고 답이 몇 갈래인가 |
깊이 2 의 0.857 과 제한 없음의 1.0 은 모두 연습 문제로 잰 점수입니다. 1.0 이 더 높다고 더 좋은 모델이라는 뜻은 아닙니다. 새 주문으로 시험해야 어느 쪽이 나은지 알 수 있고, 그 비교를 실습 6에서 합니다. 비유와 다른 점은, 사람은 쓸모없는 질문을 스스로 알아채지만 나무는 학습 점수만 보고 질문을 늘린다는 것입니다.
주의할 점
- 학습 점수가 1.000 에 가까우면 기뻐하기보다 먼저 과적합을 의심합니다.
- 알맞은 깊이는 데이터마다 다릅니다. 검증용 데이터로 골라야 하고, 시험용으로 고르면 안 됩니다.