1장. 머신러닝 프로세스와 기본 개념
혼동행렬
화재경보기를 떠올려 보세요. 경보기가 할 수 있는 실수는 두 가지입니다. 불이 났는데 울리지 않는 실수(놓침)와, 불이 안 났는데 울리는 실수(헛경보)입니다. 둘 다 실수지만 무게가 다릅니다. 놓침은 큰 사고로 이어지고, 헛경보는 귀찮을 뿐입니다. 모델의 성적도 "몇 개 맞혔나" 하나로는 부족하고, 어떤 실수를 했는지 나눠 봐야 합니다. 그 실수를 나눠 세는 표가 혼동행렬입니다.
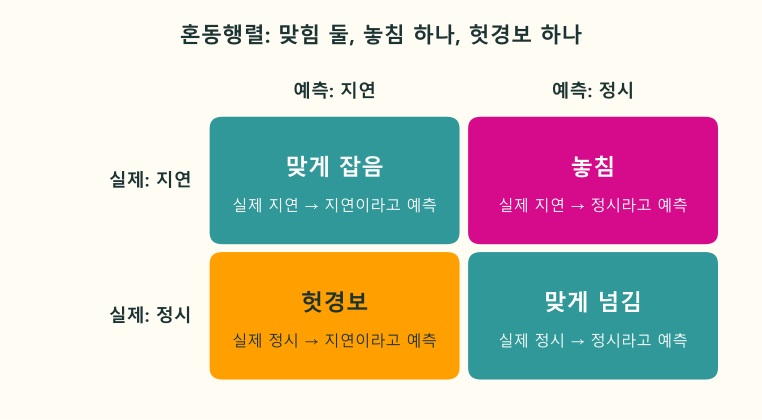
가로줄은 실제 답, 세로줄은 모델의 예측입니다. 청록 칸 둘이 맞힌 경우이고, 마젠타 칸이 놓침, 주황 칸이 헛경보입니다. 화재경보기에 견주면 불이 지연 주문이고, 경보가 "지연"이라는 예측입니다.
네 칸의 이름
책과 자료에서는 네 칸을 영어 약자로 부르는 일이 많습니다. 지연을 "양성(Positive)"으로 봅니다.
| 칸 | 약자 | 뜻 | 화재경보기로 치면 |
|---|---|---|---|
| 맞게 잡음 | TP(True Positive) | 실제 지연을 지연이라고 했다 | 불이 나서 울렸다 |
| 놓침 | FN(False Negative) | 실제 지연을 정시라고 했다 | 불이 났는데 조용했다 |
| 헛경보 | FP(False Positive) | 실제 정시를 지연이라고 했다 | 불이 없는데 울렸다 |
| 맞게 넘김 | TN(True Negative) | 실제 정시를 정시라고 했다 | 불이 없어서 조용했다 |
코드로 세기
실제 지연 4건, 정시 6건을 모델이 아래처럼 예측했다고 해 봅니다.
from sklearn.metrics import confusion_matrix

y_true = [1, 1, 1, 1, 0, 0, 0, 0, 0, 0]   # 실제: 지연 4건, 정시 6건
y_pred = [1, 1, 0, 0, 1, 0, 0, 0, 0, 0]   # 모델의 예측

cm = confusion_matrix(y_true, y_pred)
print(cm)

# ravel() 로 네 칸을 한 줄로 펴서 이름을 붙여 받는다. 순서는 TN, FP, FN, TP
tn, fp, fn, tp = cm.ravel()
print("맞게 잡음", tp, "놓침", fn, "헛경보", fp, "맞게 넘김", tn)
혼동행렬은 [[5 1] [2 2]] 로 나옵니다. 맞게 잡음 2, 놓침 2, 헛경보 1, 맞게 넘김 5 입니다. scikit-learn 은 첫 줄에 실제 0(정시), 둘째 줄에 실제 1(지연)을 두므로, 그림의 칸 순서와 위아래가 반대입니다. 그래서 숫자만 보지 말고 ravel() 로 이름을 붙여 읽는 편이 안전합니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
from sklearn.metrics import confusion_matrix | metrics(채점 지표) 묶음에서 불러온다. confusion(헷갈림)과 matrix(행렬)를 붙인 이름으로, 무엇을 무엇과 헷갈렸는지 세는 표다 |
confusion_matrix(y_true, y_pred) | (실제, 예측) 순서로 넣는다. 실제 0·1 과 예측 0·1 의 짝을 세어 2 × 2 표로 돌려준다 |
cm.ravel() | ravel 은 "엉킨 실을 풀다"라는 뜻이다. 2 × 2 표를 한 줄로 펴서 네 숫자로 만든다 |
tn, fp, fn, tp = ... | 편 네 숫자를 차례대로 네 이름에 나눠 담는다 |
이 코드가 뜻하는 것
화재경보기 열 번의 기록을 점검표에 옮겨 적는 일입니다. "불이 났고 울렸다", "불이 났는데 조용했다"처럼 경우마다 칸을 정해 바를 정(正) 자를 긋습니다. 여기서 점검표가 cm, 칸마다 그은 수가 네 숫자입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
y_true = [...] | 실제 답 10개 | 실제로 불이 났던 날의 기록 |
y_pred = [...] | 모델의 예측 10개 | 경보기가 울린 날의 기록 |
cm = confusion_matrix(y_true, y_pred) | 네 경우를 센다 | 점검표에 바를 정 자를 긋는다 |
tn, fp, fn, tp = cm.ravel() | 네 칸에 이름을 붙인다 | 칸마다 이름표를 붙여 읽는다 |
맞게 잡음 2, 놓침 2 는 실제 지연 4건 가운데 절반을 놓쳤다는 뜻입니다. 헛경보 1 은 정시 6건 가운데 1건을 괜히 지연이라고 한 것입니다.
그림과 같은 순서로 찍어 보기
labels 인자로 줄과 칸의 순서를 정할 수 있습니다. 1(지연)을 앞에 두면 위 그림과 같은 순서가 됩니다.
from sklearn.metrics import confusion_matrix

y_true = [1, 1, 1, 1, 0, 0, 0, 0, 0, 0]
y_pred = [1, 1, 0, 0, 1, 0, 0, 0, 0, 0]

# labels=[1, 0]: 1(지연)을 첫 줄·첫 칸에 두라고 순서를 정한다
print(confusion_matrix(y_true, y_pred, labels=[1, 0]))[[2 2]
[1 5]]| 결과 | 읽는 법 |
|---|---|
첫 줄 [2 2] | 실제 지연 4건이다. 2건은 지연이라고 맞게 잡았고(TP), 2건은 정시라고 놓쳤다(FN) |
둘째 줄 [1 5] | 실제 정시 6건이다. 1건은 지연이라고 헛경보를 냈고(FP), 5건은 정시라고 맞게 넘겼다(TN) |
기본 순서의 [[5 1] [2 2]] 와 숫자는 같고 자리만 뒤집혔습니다. 다만 labels 로 순서를 바꾸면 ravel() 이 펴는 순서도 바뀌므로, 위의 tn, fp, fn, tp 로 받는 줄은 기본 순서에서만 맞습니다.
주의할 점
- 혼동행렬의 위아래, 왼쪽 오른쪽 순서는 도구마다 다릅니다. 처음 보는 표는 줄과 칸의 이름부터 확인합니다.
- 놓침과 헛경보 가운데 무엇이 더 아픈지는 업무가 정합니다. 지연을 미리 알려 고객에게 문자를 보내는 일이라면 놓침이 더 아픕니다.