1장. 머신러닝 프로세스와 기본 개념
실습 3 — 조건별 지연 비율을 그래프로 보기
실습 2에서 저장한 out_delivery_clean.csv 를 읽어, 어떤 조건에서 지연이 많은지 세어 보고 그래프로 그립니다. 모델을 만들기 전에 "어떤 특성이 쓸모 있을까"를 눈으로 가늠하는 단계입니다. 실습 2를 먼저 실행해야 파일이 생깁니다.
1단계. 전체 지연 비율
import pandas as pd
import matplotlib.pyplot as plt

# 그래프의 한글이 깨지지 않게 글꼴을 정한다
plt.rcParams["font.family"] = "Malgun Gothic"
# 음수 부호(-)가 네모로 나오지 않게 한다
plt.rcParams["axes.unicode_minus"] = False

df = pd.read_csv("out_delivery_clean.csv")

# 지연 열은 0 과 1 이라서, 평균을 내면 곧 지연 비율이 된다
print("전체 지연 비율:", round(df["지연"].mean(), 3))전체 지연 비율: 0.2062단계. 조건별 지연 비율
# groupby("날씨") 로 날씨마다 묶고, 묶음마다 지연 열의 평균(=지연 비율)을 낸다
# sort_values(ascending=False) 로 비율이 높은 것부터 늘어놓는다
print(df.groupby("날씨")["지연"].mean().sort_values(ascending=False).round(3))
print(df.groupby("지역")["지연"].mean().sort_values(ascending=False).round(3))

# 18시 이후 주문인지 아닌지(True/False) 열을 잠깐 만들어 견준다
df["저녁주문"] = df["주문시각"] >= 18
print(df.groupby("저녁주문")["지연"].mean().round(3))날씨
눈 0.426
비 0.254
맑음 0.194
흐림 0.174
모름 0.120
Name: 지연, dtype: float64
지역
지방 0.404
인천 0.205
경기 0.140
서울 0.124
Name: 지연, dtype: float64
저녁주문
False 0.167
True 0.326
Name: 지연, dtype: float643단계. 그래프로 그리기
# 그림 한 장에 그래프 두 개를 나란히(1행 2열) 놓는다
fig, axes = plt.subplots(1, 2, figsize=(11, 4))

# 왼쪽: 날씨별 지연 비율을 가로 막대로
df.groupby("날씨")["지연"].mean().sort_values().plot.barh(ax=axes[0])
axes[0].set_title("날씨별 지연 비율")
axes[0].set_xlabel("지연 비율")
axes[0].set_ylabel("")

# 오른쪽: 정시 주문과 지연 주문의 거리를 히스토그램으로 겹쳐 그린다
# alpha=0.6 은 반투명이라서 겹친 부분도 보인다
for flag, label in [(0, "정시"), (1, "지연")]:
    axes[1].hist(df.loc[df["지연"] == flag, "거리km"], bins=30, alpha=0.6, label=label)
axes[1].set_title("지연 여부별 거리 분포")
axes[1].set_xlabel("거리(km)")
axes[1].legend()

plt.tight_layout()   # 두 그래프의 글자가 겹치지 않게 간격을 맞춘다
plt.show()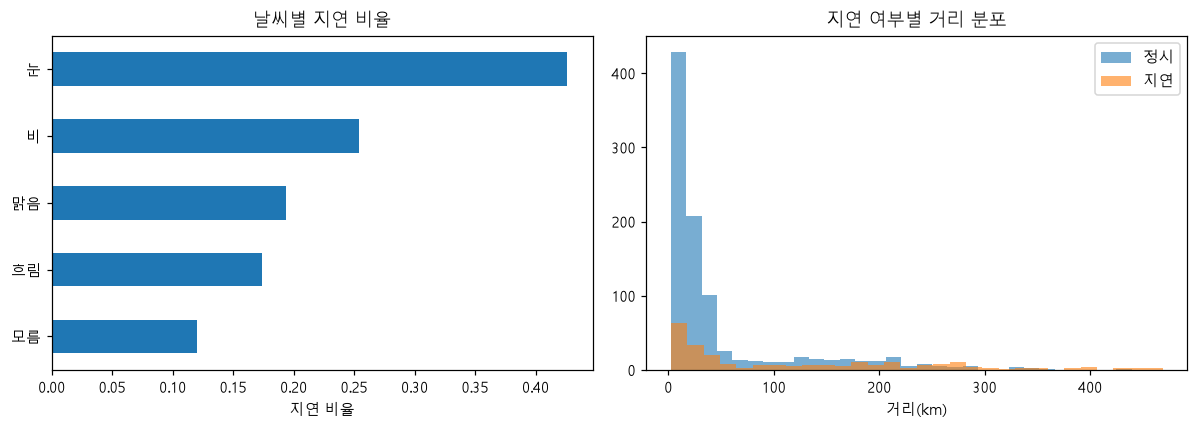
4단계. 거리 구간별 지연 비율로 확인하기
오른쪽 그래프의 세로축은 비율이 아니라 주문 수라서, 가까운 거리는 막대가 다 높아 보입니다. 거리를 세 구간으로 나눠 구간마다의 지연 비율을 숫자로 확인합니다.
# pd.cut: 숫자를 정한 경계로 잘라 구간 이름을 붙인다. right=False 는 "0 이상 50 미만"처럼 왼쪽 끝을 넣는다
df["거리구간"] = pd.cut(df["거리km"], bins=[0, 50, 250, 1000], right=False,
                     labels=["50km 미만", "50~250km", "250km 이상"])
# 구간마다 주문 수(count)와 지연 비율(mean)을 낸다. observed=True 는 주문이 있는 구간만 보인다
summary = df.groupby("거리구간", observed=True)["지연"].agg(["count", "mean"]).round(3)
summary.columns = ["주문 수", "지연 비율"]
# 결과: 거리가 멀수록 지연 비율이 커지는지
print(summary) 주문 수 지연 비율
거리구간
50km 미만 866 0.136
50~250km 259 0.317
250km 이상 69 0.667그래프에서 알 수 있는 것
- 날씨가 나쁠수록 늦습니다. 왼쪽 그래프에서 막대가 길수록 늦는 주문이 많다는 뜻입니다. 눈 오는 날은 10건 가운데 4건 넘게(0.426) 늦고, 맑은 날은 10건 가운데 2건쯤(0.194) 늦습니다. "모름"은 날씨가 빠져 있던 주문이라 건수가 적어 참고만 합니다.
- 가까운 주문이 대부분이고, 대부분 제때 옵니다. 오른쪽 그래프에서 파랑(정시)은 50km 안쪽에 크게 몰려 있습니다.
- 멀수록 늦을 가능성이 커집니다. 4단계의 표에서 50km 미만은 지연 비율이 0.136 이지만, 250km 이상은 0.667 로 세 건 가운데 두 건이 늦습니다. 오른쪽 그래프의 먼 쪽에서 주황(지연) 막대가 파랑만큼 높거나 더 높은 것이 이 뜻입니다.
- 모델에 넣을 특성의 실마리가 됩니다. 날씨와 거리, 2단계에서 본 지역과 저녁 주문이 지연과 함께 움직입니다. 실습 4에서 이 열들을 특성으로 씁니다.
- 함께 움직인다고 원인이라는 뜻은 아닙니다. 눈이 와서 늦는지, 눈 오는 날 먼 주문이 많아서 늦는지는 이 그래프만으로 가를 수 없습니다. 그래프는 "어디를 더 볼지" 알려 주는 단서입니다.
이 실습이 뜻하는 것
이 실습은 택배 회사 직원이 정리한 장부를 넘기며 "언제 늦었나"를 따져 보는 일과 같습니다. 전체에서 몇 건이 늦었는지 세고(1단계), 날씨·지역·주문 시각으로 묶어 늦은 비율을 견주고(2단계), 그래프로 그려 한눈에 보고(3단계), 거리를 세 구간으로 나눠 다시 셉니다(4단계). 여기서 장부가 out_delivery_clean.csv, "~별로 묶어 보기"가 groupby, 늦은 비율이 지연 열의 평균입니다. 그래프를 읽는 법은 바로 위 "그래프에서 알 수 있는 것"에 있으므로 여기서는 숫자의 뜻만 짚습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 전체 | 0.206 | 주문 다섯 건 가운데 한 건 꼴로 늦습니다 |
| 2. 날씨별 | 눈 0.426, 맑음 0.194 | 눈 오는 날은 맑은 날보다 늦는 비율이 두 배를 넘습니다. '모름' 0.120 은 건수가 적어 참고만 합니다 |
| 2. 지역별 | 지방 0.404, 서울 0.124 | 지방 배송이 서울보다 세 배 넘게 자주 늦습니다 |
| 2. 저녁 주문 | True 0.326, False 0.167 | 18시 이후 주문은 그 밖의 주문보다 두 배쯤 자주 늦습니다 |
| 3. 그래프 | 막대그래프와 히스토그램 | 날씨별 차이와, 가까운 주문이 대부분이고 대부분 제때 온다는 것을 그림으로 보여 줍니다 |
| 4. 거리 구간별 | 50km 미만 0.136, 250km 이상 0.667 | 먼 주문은 세 건 가운데 두 건이 늦습니다. 다만 250km 이상은 69건뿐입니다 |
한 줄로 줄이면, 날씨·지역·주문 시각·거리가 지연과 함께 움직인다는 단서를 찾은 실습입니다. 이 열들을 실습 4에서 모델에 넣을 특성으로 씁니다. 함께 움직인다는 것이 곧 원인이라는 뜻은 아니며, 이 숫자들은 "어디를 더 볼지"를 알려 줄 뿐입니다.
코드 설명
- 전체 지연 비율은 0.206 입니다. 주문 다섯 건 가운데 한 건 꼴로 늦습니다. 이 숫자가 실습 5의 기준선과 이어집니다.
- 눈 오는 날이 0.426 으로 맑은 날(0.194)의 두 배를 넘고, 지방이 0.404 로 서울(0.124)의 세 배를 넘습니다. 저녁 주문(18시 이후)도 0.326 으로 그 밖의 주문(0.167)의 두 배쯤입니다. 날씨, 지역, 주문시각이 쓸모 있는 특성이 되리라는 실마리입니다.
- 날씨를 '모름' 으로 채운 주문은 건수가 적어 0.120 이라는 숫자를 크게 믿지는 않습니다.
- 오른쪽 그래프에서 파랑이 정시, 주황이 지연입니다(matplotlib 의 기본 색). 50km 안쪽은 정시가 압도적으로 많고, 250km 를 넘는 쪽에서는 주황 막대가 파랑만큼 높거나 더 높습니다. 거리가 지연과 함께 움직인다는 뜻입니다.
pd.cut(열, bins=경계, labels=이름)은 숫자를 구간으로 바꿉니다. 거리처럼 값이 넓게 퍼진 열을 몇 구간으로 묶어 비율을 견줄 때 씁니다.저녁주문,거리구간열은 이 실습 안에서만 쓰고 저장하지 않았습니다. 파일은 실습 2에서 저장한 그대로입니다.