1장. 머신러닝 프로세스와 기본 개념
실습 5 — 기준선과 모델 채점하기
실습 4와 같은 방법으로 데이터를 준비한 뒤, 아무것도 배우지 않은 기준선과 로지스틱 회귀 모델의 성적을 견줍니다. 정확도 하나만 보면 무엇을 놓치는지 혼동행렬로 확인합니다.
1단계. 실습 4와 같은 준비
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 실습 4와 똑같이 준비한다. random_state 가 같아서 똑같이 나뉜다
df = pd.read_csv("out_delivery_clean.csv")
df["주말"] = (pd.to_datetime(df["주문일"]).dt.day_of_week >= 5).astype(int)
features = ["주문시각", "거리km", "무게kg", "주말", "지역", "상품분류", "날씨", "택배사"]
X = pd.get_dummies(df[features], dtype=int)
y = df["지연"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)
print(X_train.shape, X_test.shape)(895, 21) (299, 21)2단계. 기준선 구하기
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score

# DummyClassifier(strategy="most_frequent"): 학습용에서 가장 많은 답('정시')만 늘 말하는 모델
base = DummyClassifier(strategy="most_frequent")
base.fit(X_train, y_train)

# 시험용으로 채점한다. 이 점수가 넘어야 할 기준선이다
print("기준선 정확도:", round(accuracy_score(y_test, base.predict(X_test)), 3))기준선 정확도: 0.7933단계. 모델 학습하고 채점하기
이번 모델은 로지스틱 회귀입니다. 택배 회사가 주문마다 "지연 위험 점수"를 매기는 점수표를 만든다고 생각하면 쉽습니다. 거리, 날씨, 주문시각 같은 특성마다 점수를 정해 두고, 주문 한 건이 오면 해당하는 점수를 더해 "이 주문이 늦을 확률"을 냅니다. 로지스틱 회귀는 이 점수표를 학습용 데이터에서 스스로 배웁니다. 실습 3에서 본 것처럼 멀거나 눈 오는 주문이 늦는 편이라면, 그런 특성에 큰 점수를 주도록 배웁니다.
| 걸음 | 모델이 하는 일 | 점수표로 치면 |
|---|---|---|
| 1 | 특성마다 가중치(점수)를 배운다 | 항목마다 몇 점을 줄지 정한다 |
| 2 | 주문 한 건의 점수를 모두 더한 뒤, S자 곡선(시그모이드 함수)으로 0~1 사이의 확률로 바꾼다 | 합계 점수를 "늦을 확률 몇 %"로 바꾼다 |
| 3 | 확률이 기준값 0.5 이상이면 "지연", 아니면 "정시"라고 답한다 | 확률이 절반을 넘으면 지연 안내를 보낸다 |
이름에 "회귀"가 들어 있지만, 확률이라는 숫자를 거쳐 지연·정시를 고르는 분류 모델입니다. 확률은 predict_proba 로, 0.5 로 자른 답은 predict 로 얻습니다.
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

# 만들기 → 학습(fit). 학습에는 학습용만 쓴다
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)

# 예측(predict)과 채점은 시험용으로 한다
pred = model.predict(X_test)
print("모델 정확도:", round(accuracy_score(y_test, pred), 3))

# 답마다 정밀도, 재현율, F1 을 한 표로 본다. digits=3 은 소수 셋째 자리까지
print(classification_report(y_test, pred, target_names=["정시", "지연"], digits=3))

# predict_proba 는 [정시일 확률, 지연일 확률] 을 낸다. [:, 1] 로 지연일 확률만 꺼낸다
proba = model.predict_proba(X_test)[:, 1]
# 시험용 주문의 거리·날씨·주문시각 옆에 지연 확률, 예측, 실제 답을 붙인다
look = df.loc[X_test.index, ["거리km", "날씨", "주문시각"]].assign(
    지연확률=proba.round(3), 예측=pred, 실제=y_test.values
)
look = look.sort_values("지연확률", ascending=False)
# 결과: 지연 확률이 가장 높은 3건과 가장 낮은 2건
print(pd.concat([look.head(3), look.tail(2)]))모델 정확도: 0.799
precision recall f1-score support
정시 0.827 0.945 0.882 237
지연 0.536 0.242 0.333 62
accuracy 0.799 299
macro avg 0.681 0.594 0.608 299
weighted avg 0.766 0.799 0.768 299
거리km 날씨 주문시각 지연확률 예측 실제
263 459.0 비 13 0.912 1 1
530 257.6 맑음 15 0.805 1 1
220 318.0 흐림 21 0.787 1 1
834 40.5 맑음 4 0.031 0 1
103 3.9 맑음 5 0.031 0 04단계. 혼동행렬 그리기
from sklearn.metrics import ConfusionMatrixDisplay

# 실제(y_test)와 예측(pred)으로 혼동행렬을 그린다
# 세로가 실제(True label), 가로가 예측(Predicted label)이다
ConfusionMatrixDisplay.from_predictions(y_test, pred, display_labels=["정시", "지연"])
plt.title("혼동행렬 (기준값 0.5)")
plt.show()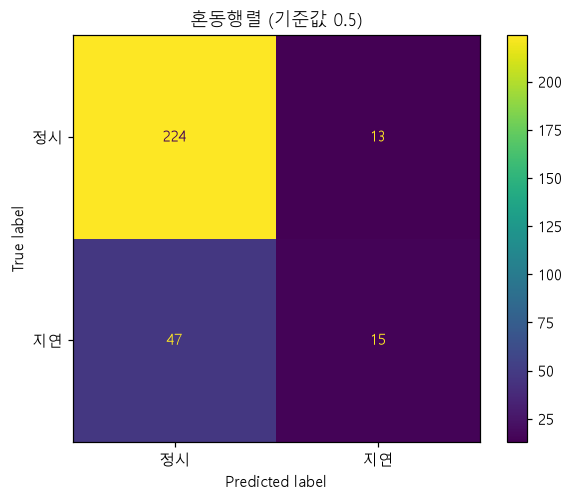
혼동행렬 그래프 읽는 법
이 그래프는 시험용 주문 299건을 "실제로는 어땠나"와 "모델은 뭐라고 했나"로 나눠 센 표입니다. 세로축(True label)이 실제 답, 가로축(Predicted label)이 모델의 예측입니다. 위 줄은 실제로 제때 온 주문 237건, 아래 줄은 실제로 늦은 주문 62건입니다. "혼동행렬" 절의 그림과는 위아래가 반대이니 줄 이름부터 읽습니다.
| 칸 | 숫자 | 뜻 | 이름 |
|---|---|---|---|
| 왼쪽 위 | 224 | 제때 온 주문을 "정시"라고 했다 | 맞게 넘김(TN) |
| 오른쪽 위 | 13 | 제때 온 주문을 "지연"이라고 했다 | 헛경보(FP) |
| 왼쪽 아래 | 47 | 늦은 주문을 "정시"라고 했다 | 놓침(FN) |
| 오른쪽 아래 | 15 | 늦은 주문을 "지연"이라고 했다 | 맞게 잡음(TP) |
칸의 색은 오른쪽 색 막대처럼 수가 많을수록 밝은 노랑, 적을수록 짙은 보라입니다. 224 칸만 밝은 것은 시험용 주문 대부분이 정시이고 모델도 대부분 "정시"라고 답했기 때문입니다. 3단계에서 본 40.5km 새벽 4시 주문(지연 확률 0.031, 실제 지연)이 왼쪽 아래 47건 가운데 하나입니다.
네 칸으로 3단계의 점수를 다시 계산할 수 있습니다.
| 지표 | 칸으로 계산 | 값 |
|---|---|---|
| 정확도 | (224 + 15) ÷ 299 | 0.799 |
| 재현율(지연) | 15 ÷ (47 + 15) | 0.242 |
| 정밀도(지연) | 15 ÷ (13 + 15) | 0.536 |
한 줄로 말하면, 늦을 주문 62건 가운데 47건을 놓쳤습니다. 정확도 0.799 는 기준선과 비슷하고, 지연 안내 문자를 보내는 일이라면 늦은 고객 넷 가운데 셋은 안내를 받지 못합니다. 실습 6에서 기준값을 낮춰 놓침을 줄여 봅니다.
이 실습이 뜻하는 것
이 실습은 예보관 두 사람의 적중률을 견주는 일과 같습니다. 같은 시험 문제를 준비하고(1단계), 날씨를 보지 않고 늘 "정시"라고만 말하는 예보관의 점수를 매기고(2단계), 항목마다 점수를 매기는 점수표로 판단하는 예보관을 가르쳐 채점한 뒤(3단계), 맞힌 것과 놓친 것을 네 칸 표로 셉니다(4단계). 여기서 늘 같은 말만 하는 예보관이 기준선(DummyClassifier), 점수표 예보관이 로지스틱 회귀, 네 칸 표가 혼동행렬입니다. 혼동행렬의 칸마다의 뜻은 바로 위 "혼동행렬 그래프 읽는 법"에 있으므로 여기서는 되풀이하지 않습니다.
| 단계 | 출력 | 뜻 |
|---|---|---|
| 1. 준비 | (895, 21) (299, 21) | 실습 4와 똑같이 나뉘었습니다 |
| 2. 기준선 | 0.793 | 늘 "정시"라고만 해도 시험용 299건 가운데 정시인 237건을 맞혀 이만큼 받습니다 |
| 3. 모델 정확도 | 0.799 | 기준선보다 0.006 높을 뿐이라 정확도로는 거의 차이가 없습니다 |
| 3. 지연 줄 | 정밀도 0.536, 재현율 0.242 | "지연"이라고 한 주문은 절반쯤 맞았지만, 실제로 늦은 주문은 네 건에 한 건쯤만 잡았습니다 |
| 3. 지연 확률 | 0.912 와 0.031 | 459km 비 오는 날 주문은 늦을 확률을 높게 보았고 실제로 늦었습니다. 40.5km 새벽 주문은 0.031 로 보았는데 실제로 늦어 놓쳤습니다 |
| 4. 혼동행렬 | 놓침 47 | 실제 지연 62건 가운데 47건을 "정시"라고 했습니다 |
한 줄로 줄이면, 정확도만 보면 모델이 기준선과 비슷하고, 재현율을 보면 늦을 주문 대부분을 놓친다는 것을 확인한 실습입니다. 실습 6에서 기준값을 낮춰 놓침을 줄여 봅니다. 시험용 299건, 한 번 나눈 결과라 숫자는 나누는 방법에 따라 조금씩 달라질 수 있습니다.
코드 설명
- 기준선은 0.793 이고 로지스틱 회귀는 0.799 라서, 정확도로는 거의 차이가 없습니다. "늘 정시"라고만 해도 0.793 을 받는 문제이기 때문입니다.
classification_report의 지연 줄을 보면 재현율이 0.242 입니다. 실제 지연을 네 건에 한 건쯤만 잡았다는 뜻입니다.support는 그 답의 실제 건수(지연 62건)입니다.- 혼동행렬에서 실제 지연 62건 가운데 15건만 잡고 47건을 놓쳤습니다. 재현율 0.242 가 이 15 ÷ 62 입니다. 정확도만 보았다면 놓쳤을 문제입니다.
predict_proba(X_test)[:, 1]은 주문마다 지연일 확률입니다. 이 확률이 0.5 이상이면predict가 1(지연)을 냅니다. 확률이 가장 높은 459km 비 오는 날 주문(0.912)은 실제로 늦었고, 확률이 0.031 인 40.5km 새벽 주문은 실제로 늦었는데 놓쳤습니다.ConfusionMatrixDisplay.from_predictions(실제, 예측)은 혼동행렬을 그림으로 그립니다. 칸의 색은 matplotlib 의 기본 색입니다.