1장. 머신러닝 프로세스와 기본 개념
기준값 바꾸기
화재경보기에 민감도 다이얼이 있다고 해 봅시다. 다이얼을 올려 예민하게 하면 작은 연기에도 울려서 놓침은 줄지만 헛경보가 늘어납니다. 내려서 둔하게 하면 헛경보는 줄지만 놓칠 위험이 커집니다. 분류 모델에서 이 다이얼이 기준값입니다.
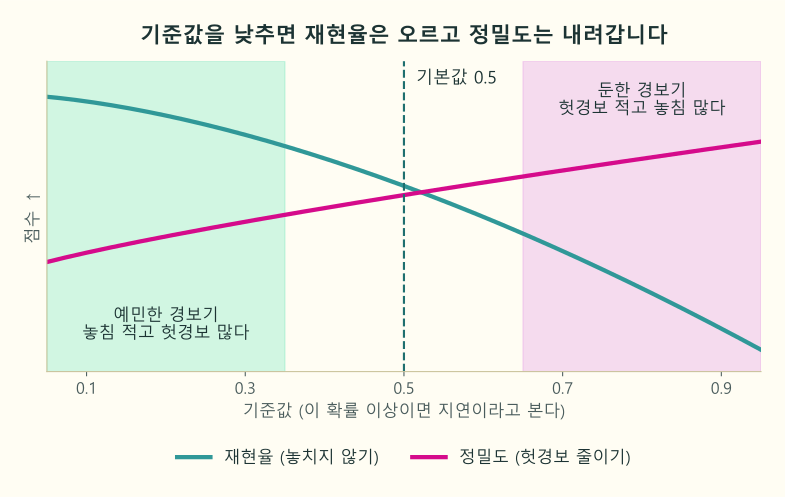
가로축이 기준값이고, 왼쪽으로 갈수록 낮아서 예민한 경보기입니다. 청록 선이 재현율, 마젠타 선이 정밀도입니다. 기준값을 낮추면 지연이라고 보는 주문이 늘어 재현율은 오르고, 그 가운데 헛경보가 섞여 정밀도는 대체로 내려갑니다. 이 그림도 모양을 보이려고 그린 곡선입니다.
기준값이 하는 일
모델은 먼저 주문마다 지연일 확률을 계산합니다. predict 는 그 확률이 0.5 이상이면 지연이라고 답할 뿐입니다. 0.5 는 정해진 값이 아니라 기본값이므로, 업무에 맞춰 바꿀 수 있습니다.
| 기준값 | 지연이라고 보는 주문 | 재현율 | 정밀도 | 어울리는 때 |
|---|---|---|---|---|
| 높게(예: 0.7) | 적다 | 낮다 | 높은 편 | 헛경보 한 번의 비용이 클 때 |
| 기본(0.5) | 보통 | 보통 | 보통 | 따로 정할 근거가 없을 때 |
| 낮게(예: 0.3) | 많다 | 높다 | 낮은 편 | 놓친 지연 한 건이 아플 때 |
코드로 바꿔 보기
지연 4건, 정시 6건에 모델이 계산한 지연 확률이 아래와 같다고 해 봅니다.
import numpy as np
from sklearn.metrics import precision_score, recall_score

y_true = np.array([1, 1, 1, 1, 0, 0, 0, 0, 0, 0])
# 주문마다 모델이 계산한 지연 확률(설명용으로 정한 값)
proba = np.array([0.9, 0.7, 0.45, 0.25, 0.6, 0.35, 0.2, 0.15, 0.1, 0.05])

for t in [0.5, 0.3, 0.2]:
    # 확률이 기준값 이상이면 1(지연), 아니면 0(정시)
    pred = (proba >= t).astype(int)
    print(t, "정밀도", round(precision_score(y_true, pred), 3), "재현율", recall_score(y_true, pred))
기준값 0.5 에서는 정밀도 0.667, 재현율 0.5 입니다. 0.3 으로 낮추면 정밀도 0.6, 재현율 0.75 가 되고, 0.2 까지 낮추면 정밀도 0.571, 재현율 1.0 이 됩니다. 실제 지연을 모두 잡는 대신 헛경보가 셋으로 늘었습니다.
코드에 나오는 함수
| 코드 | 쉬운 뜻 |
|---|---|
np.array([...]) | NumPy 배열을 만든다. 배열끼리는 칸마다 한꺼번에 견주고 계산할 수 있다 |
proba >= t | 확률 10개를 기준값 t 와 칸마다 견준다. 넘으면 True, 못 넘으면 False 인 배열이 나온다 |
.astype(int) | as type(꼴을 바꾸어). True 는 1, False 는 0 으로 바꾼다 |
precision_score, recall_score | 바꾼 예측으로 정밀도와 재현율을 다시 계산한다 |
이 코드가 뜻하는 것
화재경보기의 민감도 다이얼을 0.5, 0.3, 0.2 로 차례로 돌려 가며, 같은 연기 기록에 몇 번 울리는지 보는 일입니다. 여기서 연기의 짙기가 proba, 다이얼 눈금이 t, 울렸다 안 울렸다가 pred 입니다.
| 줄 | 하는 일 | 쉽게 말하면 |
|---|---|---|
proba = np.array([...]) | 주문마다 지연 확률을 정해 둔다 | 날마다 감지한 연기의 짙기 |
for t in [0.5, 0.3, 0.2] | 기준값을 셋으로 바꿔 본다 | 다이얼을 차례로 돌린다 |
pred = (proba >= t).astype(int) | 기준값을 넘으면 1, 아니면 0 | 이 눈금에서 울리는 날을 표시한다 |
precision_score(...), recall_score(...) | 두 지표를 계산한다 | 헛경보와 놓침이 얼마나 되는지 센다 |
기준값을 낮출수록 재현율은 0.5, 0.75, 1.0 으로 오르고 정밀도는 0.667, 0.6, 0.571 로 내려갑니다. 다이얼 하나로 놓침과 헛경보를 맞바꾸는 것입니다.
작게 줄여서 눈으로 보기
기준값이 예측을 어떻게 바꾸는지 0.5 와 0.3 두 눈금에서 직접 봅니다.
import numpy as np

proba = np.array([0.9, 0.7, 0.45, 0.25, 0.6, 0.35, 0.2, 0.15, 0.1, 0.05])

for t in [0.5, 0.3]:
print(t, proba >= t, (proba >= t).astype(int))0.5 [ True True False False True False False False False False] [1 1 0 0 1 0 0 0 0 0]
0.3 [ True True True False True True False False False False] [1 1 1 0 1 1 0 0 0 0]| 결과 | 읽는 법 |
|---|---|
0.5 줄의 [1 1 0 0 1 0 0 0 0 0] | 0.9, 0.7, 0.6 세 주문만 지연이다. 혼동행렬 절의 예측과 같다 |
0.3 줄의 [1 1 1 0 1 1 0 0 0 0] | 0.45 와 0.35 가 더해져 다섯 주문이 지연이다 |
| 새로 지연이 된 둘 | 셋째(0.45)는 실제 지연이라 놓침이 하나 줄고, 여섯째(0.35)는 실제 정시라 헛경보가 하나 는다 |
기준값을 낮추면 지연이라고 보는 주문이 늘어납니다. 그 가운데 실제 지연이 있으면 재현율이 오르고, 실제 정시가 있으면 정밀도가 내려갑니다.
주의할 점
- 기준값도 모델의 설정이므로 원래는 검증용 데이터로 고릅니다.
- 기준값을 고를 때는 숫자보다 비용을 먼저 적어 봅니다. "문자 한 통의 비용"과 "놓친 지연 한 건의 비용"을 견주면 어느 쪽으로 다이얼을 돌릴지 정해집니다.